권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • AI_플랫폼(주식 매수 점수)
  • 유튜브
  1. 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고

목차

  • 100년 만에 20.1㎝, 세계에서 가장 빨리 자란 키
  • 이 평균은 “코호트”를 추적해서 만든 것이다
  • 더 깊이: 횡단 자료와 종단 자료
  • 결론: 평균은 무엇을, 언제, 누구와 비교했는지에 달려 있다

(기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유

통계기초
기술통계
2016년 국제 연구는 1896년생과 1996년생 한국 여성의 평균 키를 비교해, 100년 만에 20.1㎝가 자랐다는 세계 1위 기록을 발표했다. 유전자가 100년 만에 바뀌었을 리는 없다. 이 ’평균’이 실제로 어떻게 만들어졌는지 — 그리고 같은 통계를 잘못 읽으면 어떤 착시에 빠지는지를 살펴본다.
Author

권세혁

Published

August 26, 2026

100년 만에 20.1㎝, 세계에서 가장 빨리 자란 키

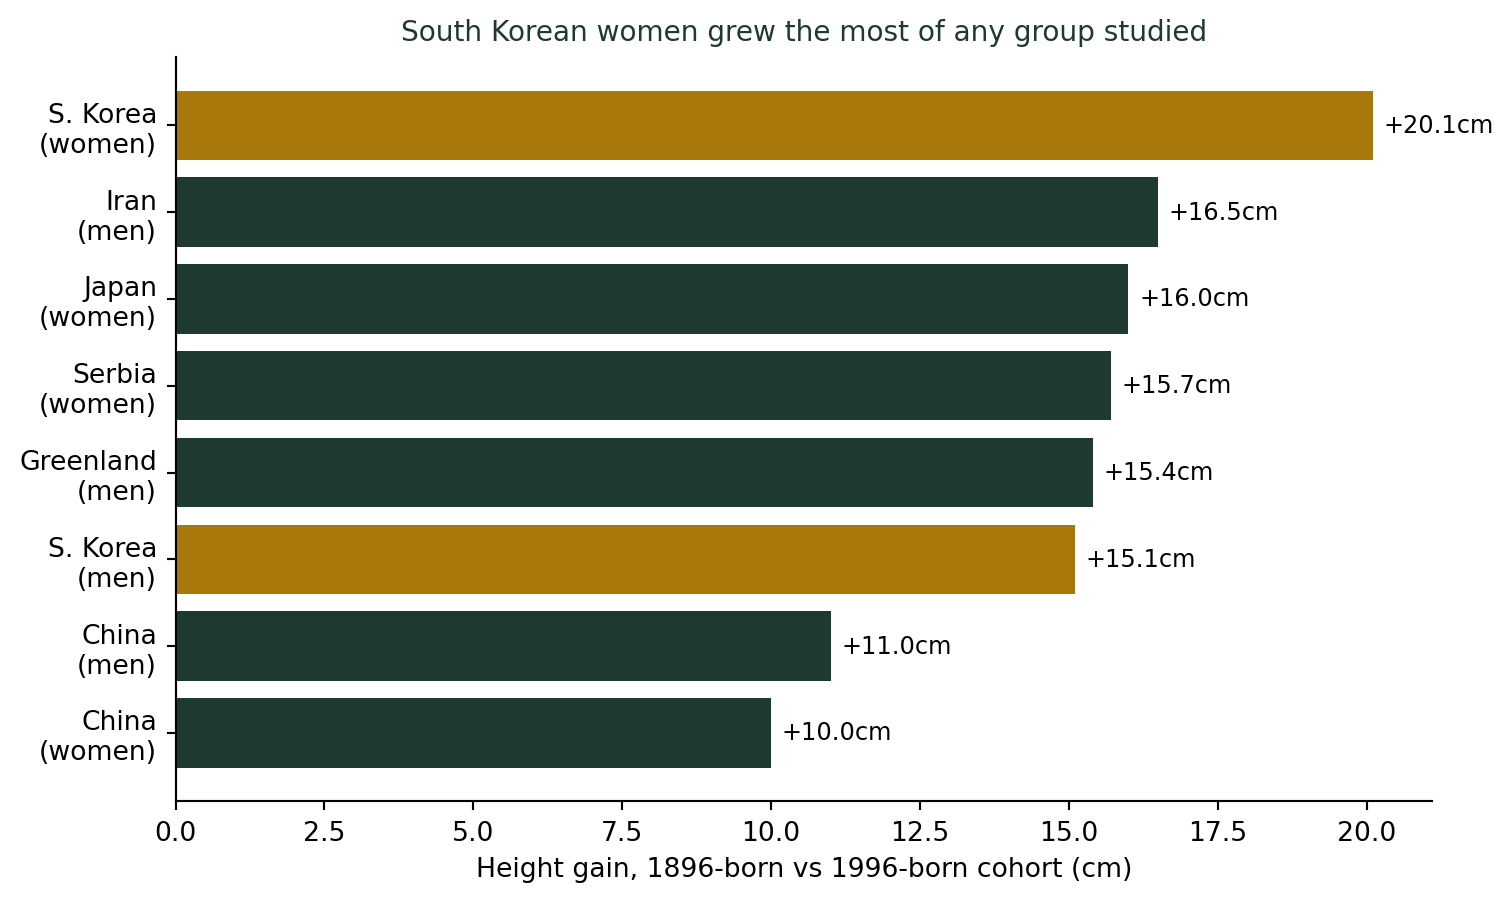
2016년 임페리얼 칼리지 런던의 마지드 에자티(Majid Ezzati) 교수팀이 이끄는 국제 공동연구(NCD-RisC)는 전 세계 200개국 1,800만 명의 신장 자료를 분석해 국제학술지 eLife에 결과를 발표했다. 1896년생과 1996년생, 즉 100년의 격차를 둔 두 세대의 성인 평균 키를 비교한 것이었는데, 이 연구에서 가장 극적인 변화를 보인 집단은 한국 여성이었다. 142.2㎝에서 162.3㎝로, 100년 만에 20.1㎝가 자랐다 — 조사 대상 200개국 어느 나라·성별보다 큰 폭이었다. 한국 남성도 159.8㎝에서 174.9㎝로 15.1㎝ 자라 상위권에 들었다.

Height gain (cm) between the 1896-born and 1996-born cohorts, for the countries/sexes with the largest gains in the NCD-RisC (2016) study published in eLife. South Korean women gained the most of any group in the entire 200-country study.

100년이면 사람의 유전자가 바뀌기엔 턱없이 짧은 시간이다. 그런데도 평균 키가 이렇게 크게 움직였다는 건, 이 “평균”이라는 숫자가 유전이 아니라 영양·보건 환경의 변화를 담고 있다는 뜻이다. 여기서 통계적으로 흥미로운 질문이 하나 생긴다. 이 연구자들은 도대체 어떻게 “1896년생의 평균 키”와 “1996년생의 평균 키”를 각각 잰 걸까?

이 평균은 “코호트”를 추적해서 만든 것이다

답은 이렇다. 연구팀은 특정 하루에 온갖 나이대 사람을 모아 한꺼번에 잰 게 아니다. 같은 해에 태어난 사람들(코호트, cohort)이 성인이 되었을 때(대략 18세 전후) 측정된 키 기록을, 태어난 연도별로 묶어 비교했다. 1896년생이 성인이 된 1910년대의 기록과, 1996년생이 성인이 된 2010년대의 기록을 나란히 놓은 것이다. 즉 “다 자란 성인끼리, 태어난 해만 다르게” 비교한 셈이다.

이 방식이 왜 중요한지는, 반대로 이렇게 하지 않았을 경우를 상상해보면 분명해진다. 만약 연구팀이 오늘 하루 20대부터 80대까지 모든 연령대 한국인의 키를 한꺼번에 재서 “세대별 평균”이라고 발표했다면 어떻게 됐을까?
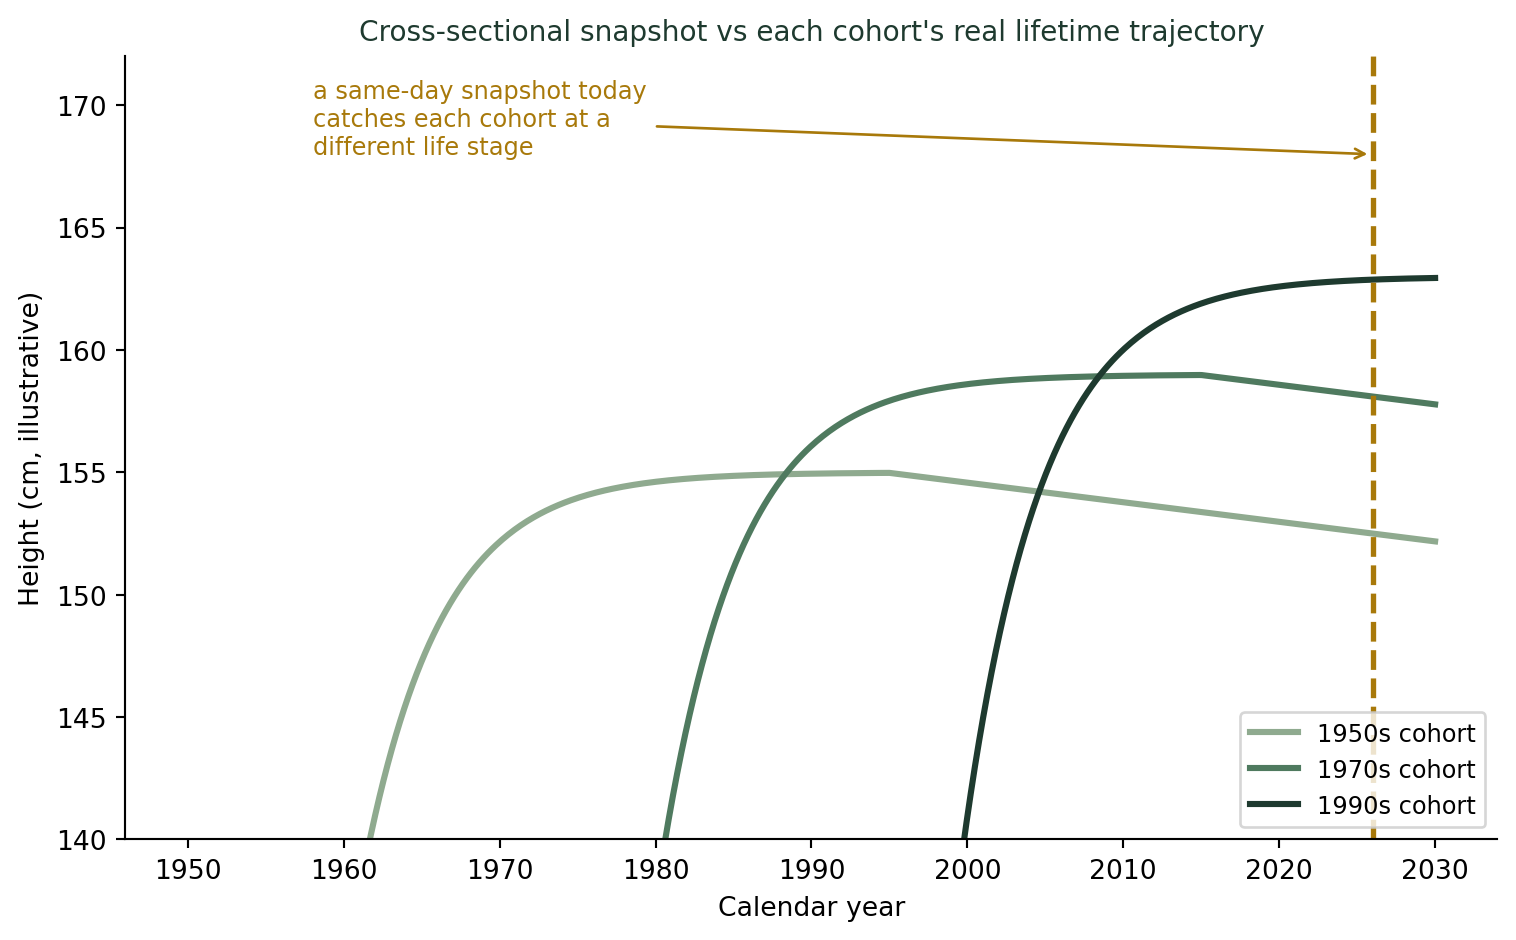
A stylized, illustrative model (not the real NCD-RisC data) of three birth cohorts’ height-over-lifetime curves, offset upward across generations to reflect the real secular trend. A same-day cross-sectional snapshot (dashed line) catches each cohort at a completely different point of its own life cycle — including the natural height loss after middle age — mixing that in with the genuine generational gain.

세 곡선은 실제 자료가 아니라 원리를 보여주기 위한 단순화된 모형이다. 각 세대는 성장기(20세 전후까지 상승)와 성인기 정체 구간을 거친 뒤, 중년 이후에는 척추 디스크 압축과 골밀도 감소 등으로 서서히 키가 줄어든다 — 이는 널리 알려진 노화의 자연스러운 현상이다. 금색 점선으로 표시한 “오늘”이라는 한 시점에서 세 세대를 동시에 관찰하면, 1950년대생은 이미 정점을 지나 줄어드는 구간에서, 1990년대생은 한창 정점에 있는 구간에서 붙잡힌다. 이 둘의 키 차이에는 진짜 세대 간 성장 차이(코호트 효과)와 같은 사람이 나이 들며 겪는 변화(연령 효과)가 뒤섞여 있다. NCD-RisC 연구가 굳이 “각 세대가 성인이 된 시점”을 기준으로 맞춰 비교한 이유가 바로 이 혼입을 피하기 위해서다.

세대 비교 통계를 읽을 때 확인할 것
  1. 비교 시점이 맞춰져 있는가? “오늘 여러 세대”를 비교하는지, “각 세대가 같은 나이였을 때”를 비교하는지에 따라 결론이 달라진다.
  2. 평균 뒤에 숨은 표본 구성이 바뀌지 않았는가? 지난 챕터에서 다룬 우리 반 평균 이야기처럼, 비교 대상 집단의 구성 자체가 달라지면 개인의 변화 없이도 평균은 움직인다.
  3. “평균이 변했다”가 곧 “개인이 변했다”를 뜻하지는 않는다. 세대 평균 키가 올랐다고 해서 특정 개인이 부모보다 반드시 크다는 뜻은 아니다. 평균은 집단의 요약값일 뿐이다.

더 깊이: 횡단 자료와 종단 자료

강의노트 〈기초통계학 1. 자료의 이해 — 횡단 자료 vs. 종단 자료〉는 특정 시점에 여러 개체를 한 번에 조사하는 횡단 자료(cross-sectional data)와, 동일 개체·현상을 시간 흐름에 따라 추적하는 종단 자료(time series / longitudinal data)를 구분한다. 오늘 살펴본 세대별 키 비교의 함정은 정확히 이 구분과 맞닿아 있다. “오늘 하루 여러 연령대”를 재는 건 횡단 자료이고, “같은 나이가 됐을 때의 여러 세대”를 재는 건 세대(코호트)를 축으로 한 비교다. NCD-RisC 연구가 신뢰할 만한 이유는, 나이라는 변수를 성인기 시점으로 통제해 코호트 간 비교가 순수하게 “태어난 해”의 차이만 반영하도록 설계했기 때문이다.

결론: 평균은 무엇을, 언제, 누구와 비교했는지에 달려 있다

나는 학생들에게 “평균 키가 커졌다”는 뉴스를 보여줄 때마다 이렇게 묻는다. “이 평균은 누구를, 언제 잰 걸까?” 100년 만에 20.1㎝라는 숫자는 분명 진짜다 — 한국의 영양과 보건 환경이 그만큼 극적으로 좋아졌다는 증거다. 하지만 이 숫자가 설득력을 갖는 이유는 크기 자체가 아니라, 같은 나이의 사람들끼리, 태어난 해만 다르게 비교했다는 방법론에 있다. 세대 간 평균을 비교하는 통계를 마주하면, 그 평균이 정확히 무엇을 무엇과 맞춰 비교한 것인지부터 확인하는 습관이 필요하다.

참고 자료
  • Bentham, J. et al. (NCD Risk Factor Collaboration, 2016). A century of trends in adult human height. eLife, 5:e13410.
  • 한국 여성 평균키 162.3㎝… 100년새 20㎝ 커져 세계1위 — 한국일보
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08