권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • AI_플랫폼(주식 매수 점수)
  • 유튜브
  1. 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고

목차

  • 로또는 상상하고, 벼락은 상상하지 않는다
  • 왜 “떠올리기 쉬움”이 “자주 일어남”으로 둔갑하는가
  • 더 깊이: 확률은 원래 “떠오르는 정도”가 아니라 “장기적 비율”로 정의된다
  • 결론: 무서운 것과 위험한 것은 다르다

(사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유

통계기초
확률
행동통계
로또 1등에 당첨될 확률은 815만분의 1이다. 평생 벼락에 맞을 확률은 그보다 500배 넘게 높다. 그런데도 매주 로또를 사며 당첨을 상상하는 사람은 많아도, 벼락을 걱정하는 사람은 거의 없다. 뉴스에 잘 나오는 사건일수록 기억하기 쉽고, 기억하기 쉬운 사건일수록 더 자주 일어나는 것처럼 느껴진다.
Author

권세혁

Published

August 21, 2026

로또는 상상하고, 벼락은 상상하지 않는다

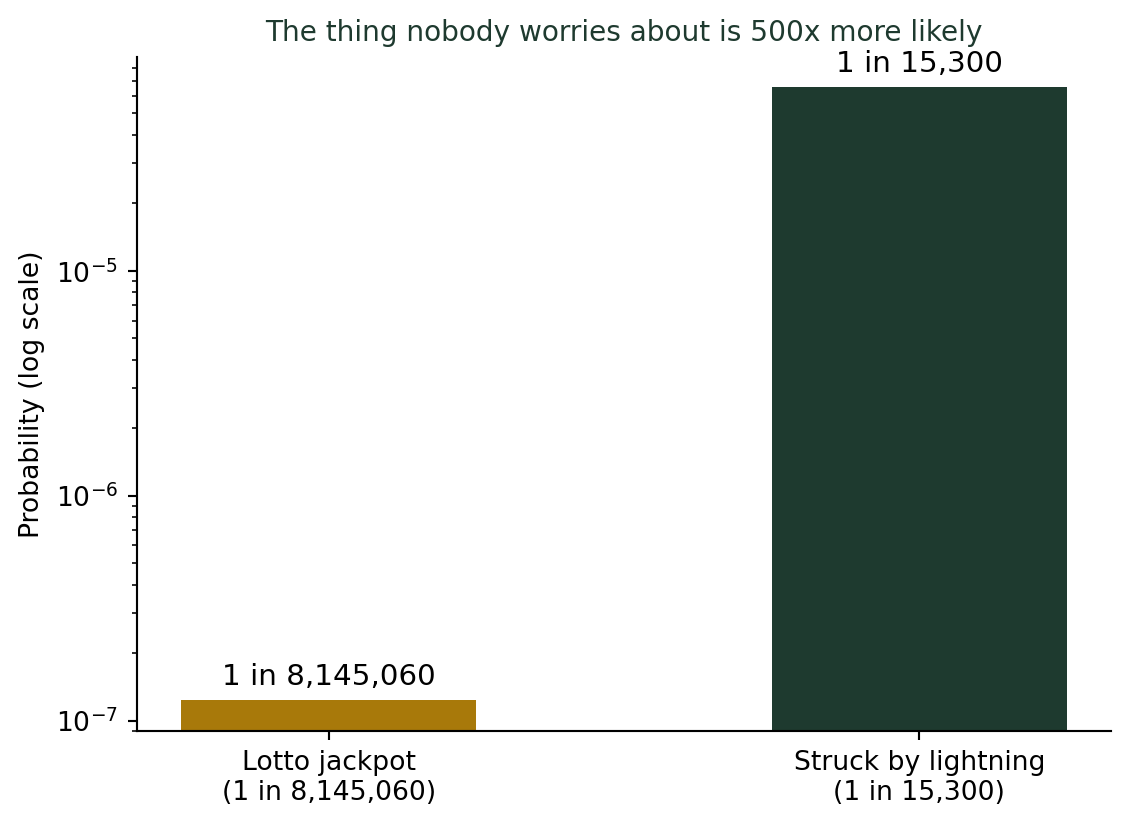
매주 토요일 저녁, 로또 추첨 방송을 챙겨보며 1등을 상상하는 사람은 많다. 반면 오늘 하루 벼락에 맞을까 봐 걱정하며 외출하는 사람은 거의 없다. 그런데 두 확률을 나란히 놓으면 이 순서는 뒤집힌다. 로또 6/45에서 1등에 당첨될 확률은 정확히 \(\binom{45}{6} = 8,145,060\)분의 1이다. 반면 미국 국립기상청(NWS)이 추정하는 평생 벼락에 맞을 확률은 약 15,300분의 1이다.

Two real, calculable probabilities on a log scale: winning the Korean Lotto 6/45 jackpot (an exact combinatorial calculation, 1 in 8,145,060) vs being struck by lightning at some point in your life (a commonly cited U.S. National Weather Service estimate, roughly 1 in 15,300). Being struck by lightning is over 500 times more likely — yet lightning barely crosses anyone’s mind.

벼락에 맞을 확률이 로또 1등 확률보다 500배 넘게 높은데도, 벼락을 걱정하며 사는 사람은 없다. 반대로 로또는 매주 수백만 명이 “이번엔 될지도 모른다”는 마음으로 산다. 이유는 명확하다. 로또 1등 당첨자는 매주 뉴스에 나오고, 당첨 판매점에는 “명당”이라는 팻말이 붙어 사람들이 줄을 선다. 반면 벼락에 맞은 사람의 사연은 개인 사고로 조용히 지나갈 뿐, 거의 보도되지 않는다. 우리가 실제로 두려워하거나 기대하는 크기는 실제 확률이 아니라, 그 사건이 얼마나 쉽게 머릿속에 떠오르는가로 결정된다. 이 현상에 심리학자 아모스 트버스키와 대니얼 카너먼은 가용성 편향(availability bias, availability heuristic)이라는 이름을 붙였다.

왜 “떠올리기 쉬움”이 “자주 일어남”으로 둔갑하는가

1973년 트버스키와 카너먼은 이런 실험을 했다. 사람들에게 영어 단어에서 K, L, N, R, V 같은 자음이 첫 번째 글자로 더 많이 쓰이는지, 세 번째 글자로 더 많이 쓰이는지 물었다. 대다수는 첫 글자 쪽이라고 답했다. 그런데 실제로 이 자음들은 세 번째 글자로 쓰이는 경우가 더 흔하다. 이유는 단순하다. 우리는 단어를 “K로 시작하는 단어”로는 쉽게 떠올리지만, “세 번째 글자가 K인 단어”로는 검색하듯 떠올리기 어렵다. 떠올리기 쉬운 정도가 실제 빈도를 대신해버린 것이다.

뉴스 보도도 똑같은 방식으로 작동한다. 자주 일어나지만 심심한 사건(낙상, 감기, 교통 정체)은 기사가 되지 않는다. 드물지만 극적인 사건(상어 습격, 항공기 사고, 이상동기 범죄)은 며칠씩 이어지는 특집 기사가 된다. 그 결과, 우리 머릿속에 저장되는 “사례의 개수”는 실제 발생 개수와 전혀 다른 비율로 쌓인다.
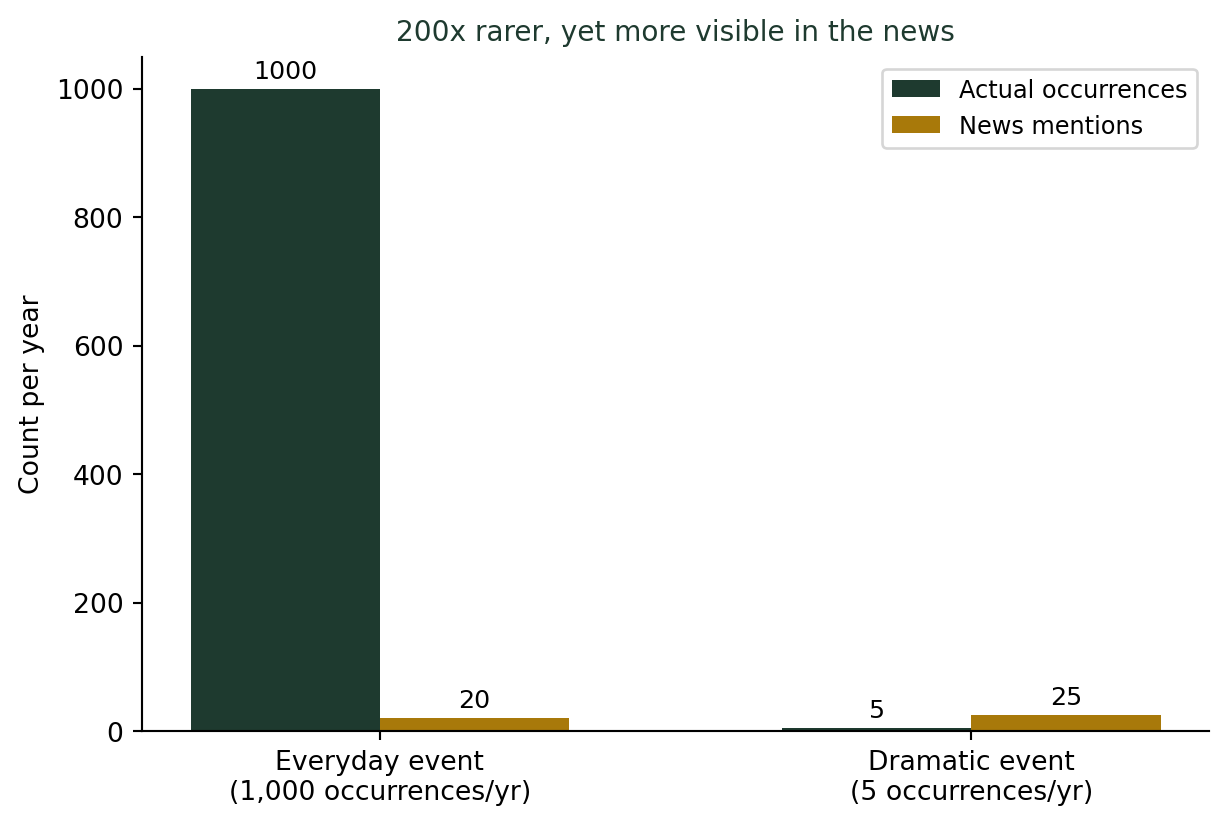
A simplified illustrative model, not real statistics: an everyday event that happens 1,000 times a year but gets covered in only 2% of cases, versus a rare event that happens 5 times a year but each time generates about 5 follow-up stories. The rare event ends up more ‘available’ in the news even though it happens 200 times less often.

이 그림은 실제 통계가 아니라 메커니즘을 보여주기 위한 단순화된 모형이다. 일상적인 사건은 1,000번 일어나도 2%만 기사화되어 20건의 보도가 나온다. 반면 극적인 사건은 5번밖에 안 일어나지만 한 건당 후속 보도가 5건씩 붙어 25건의 보도가 나온다. 실제로는 200배 더 드문 사건이, 뉴스에서는 더 자주 등장하는 사건으로 뒤바뀐다. 우리는 뉴스에서 본 횟수를 실제 발생 빈도의 대용치로 쓰기 때문에, 이 역전이 그대로 체감 위험도의 역전으로 이어진다.

“요즘 세상이 흉흉하다”는 체감

한국에서도 비슷한 패턴이 반복된다. 이상동기 범죄나 전세사기처럼 자극적인 사건이 연달아 보도되면 “요즘 왜 이렇게 사건사고가 많지”라는 체감이 강해진다. 그런데 이런 체감과 실제 범죄 통계의 장기 추세가 반대로 움직이는 경우가 여러 조사에서 보고된다. 범죄가 실제로 늘었는지는 매번 공식 통계로 따로 확인해야 할 질문이지, “요즘 뉴스에 많이 나온다”는 인상만으로 답할 수 있는 질문이 아니다.

“요즘 자주 보인다”는 느낌을 검증하는 법
  1. 그 사건이 뉴스가 될 만큼 극적인가? 극적일수록 실제 발생 빈도보다 보도 빈도가 부풀려질 가능성이 크다.
  2. 비교 대상이 되는 “안 무서운” 사건의 실제 확률도 알고 있는가? 로또와 벼락처럼, 진짜 확률은 종종 가장 상상하지 않는 곳에 있다.
  3. “내 기억에 몇 건 떠오른다”는 것과 “실제 통계가 몇 건이다”는 것을 구분했는가? 전자는 언론 보도량과 개인적 경험에 좌우되고, 후자만이 진짜 빈도다.

더 깊이: 확률은 원래 “떠오르는 정도”가 아니라 “장기적 비율”로 정의된다

강의노트 〈수리통계학 1. 확률론 — 상대 빈도(Relative Frequency)〉는 확률을 \(P(A) = \lim_{n \to \infty} f/n\), 즉 시행을 무한히 반복했을 때 사건 \(A\)가 일어난 횟수의 비율로 정의한다. 뷔퐁이 동전을 4,040번, 피어슨이 24,000번 던져 상대빈도가 0.5 근처로 수렴하는 것을 직접 확인했다는 사례도 함께 소개한다. 가용성 편향은 바로 이 정의를 어기는 방식으로 작동한다. 사람들은 \(n\)번의 전체 시행 중 \(f\)번을 실제로 세는 대신, 머릿속에 쉽게 떠오르는 사례의 수로 그 비율을 대신 추정한다. 뉴스 보도처럼 표본 자체가 이미 극적인 사건 쪽으로 치우쳐 있다면, 그 편향된 표본에서 나온 “체감 빈도”는 강의노트가 정의하는 진짜 확률과 처음부터 다른 것을 재고 있는 셈이다.

결론: 무서운 것과 위험한 것은 다르다

이번 주 나흘 동안 다룬 핫핸드, 도박사의 오류, 생존자 편향, 평균으로의 회귀는 모두 “무작위성을 잘못 읽는” 오류였다. 가용성 편향은 조금 다르다. 무작위성이 아니라 기억이라는 필터를 잘못 읽는 오류다. 우리 기억은 모든 사건을 공평하게 저장하지 않는다. 극적이고, 최근이고, 감정을 자극하는 사건일수록 더 선명하게, 더 오래 남는다. 그 결과 “내가 자주 떠올릴 수 있는 것”과 “실제로 자주 일어나는 것” 사이에는 항상 간극이 생긴다. 로또 1등을 상상하기 전에, 벼락에 맞을 확률이 그보다 훨씬 높다는 사실을 떠올려 보는 편이 통계적으로는 더 정직하다.

참고 자료
  • Tversky, A., & Kahneman, D. (1973). Availability: A heuristic for judging frequency and probability. Cognitive Psychology, 5(2), 207-232.
  • Lightning Safety — National Weather Service
  • 로또 6/45 — 위키백과
  • Availability heuristic — Wikipedia
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08