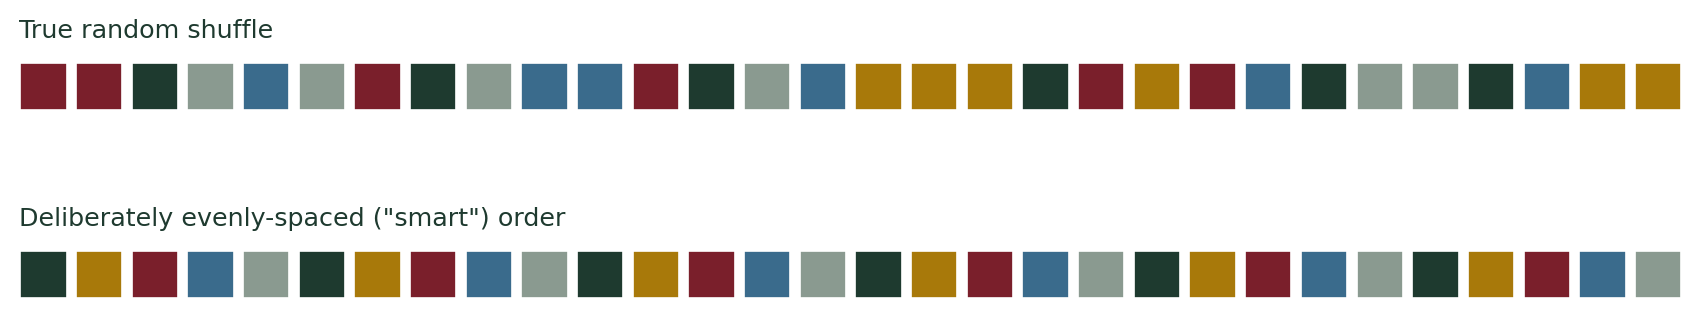
(확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
통계기초
확률
2014년 스포티파이는 완벽하게 무작위한 셔플 알고리즘을 일부러 덜 무작위하게 바꿨다. 진짜 무작위 셔플은 같은 아티스트의 곡이 연달아 나오는 경우가 너무 잦아서, 이용자들이 ’무작위가 아니다’라고 항의했기 때문이다. 진짜 무작위는 고르게 흩어지지 않고 뭉친다는 사실이 왜 이렇게 반직관적인지 살펴본다.
완벽하게 무작위였는데, 무작위가 아니라는 항의가 빗발쳤다
2014년 스포티파이는 재생목록 셔플 기능에 수학적으로 완벽한 무작위 알고리즘(피셔-예이츠 셔플)을 쓰고 있었다. 그런데도 이용자 항의가 끊이지 않았다. “같은 가수 노래가 왜 자꾸 연달아 나오죠? 이거 무작위 아니잖아요.” 스포티파이 엔지니어링 블로그는 결국 이렇게 인정했다 — 진짜 무작위는 원래 이렇게 뭉치기 마련이라고. 그래서 스포티파이는 같은 아티스트의 곡이 너무 가까이 배치되지 않도록, 알고리즘을 일부러 덜 무작위하게 바꿨다. 2005년 애플도 같은 문제를 겪었다. 스티브 잡스는 당시 발표 자리에서 이렇게 말했다. “우리 셔플이 무작위가 아니라는 사람들이 많더군요. 사실은 완벽하게 무작위입니다. 다만 무작위라는 게 가끔은 같은 아티스트의 두 곡이 나란히 나온다는 뜻이기도 하죠 … 그래서 스마트 셔플을 추가해 일부러 덜 무작위하게 만들었습니다 — 사람들은 그게 더 무작위하다고 느끼겠지만, 사실은 그 반대입니다.”
30곡을 진짜로 섞으면, 99.6% 확률로 어디선가 같은 아티스트가 연달아 나온다
이게 얼마나 흔한 일인지 직접 계산해보자. 5명의 아티스트가 각 6곡씩, 총 30곡짜리 재생목록을 진짜 무작위로 섞는다고 하자.
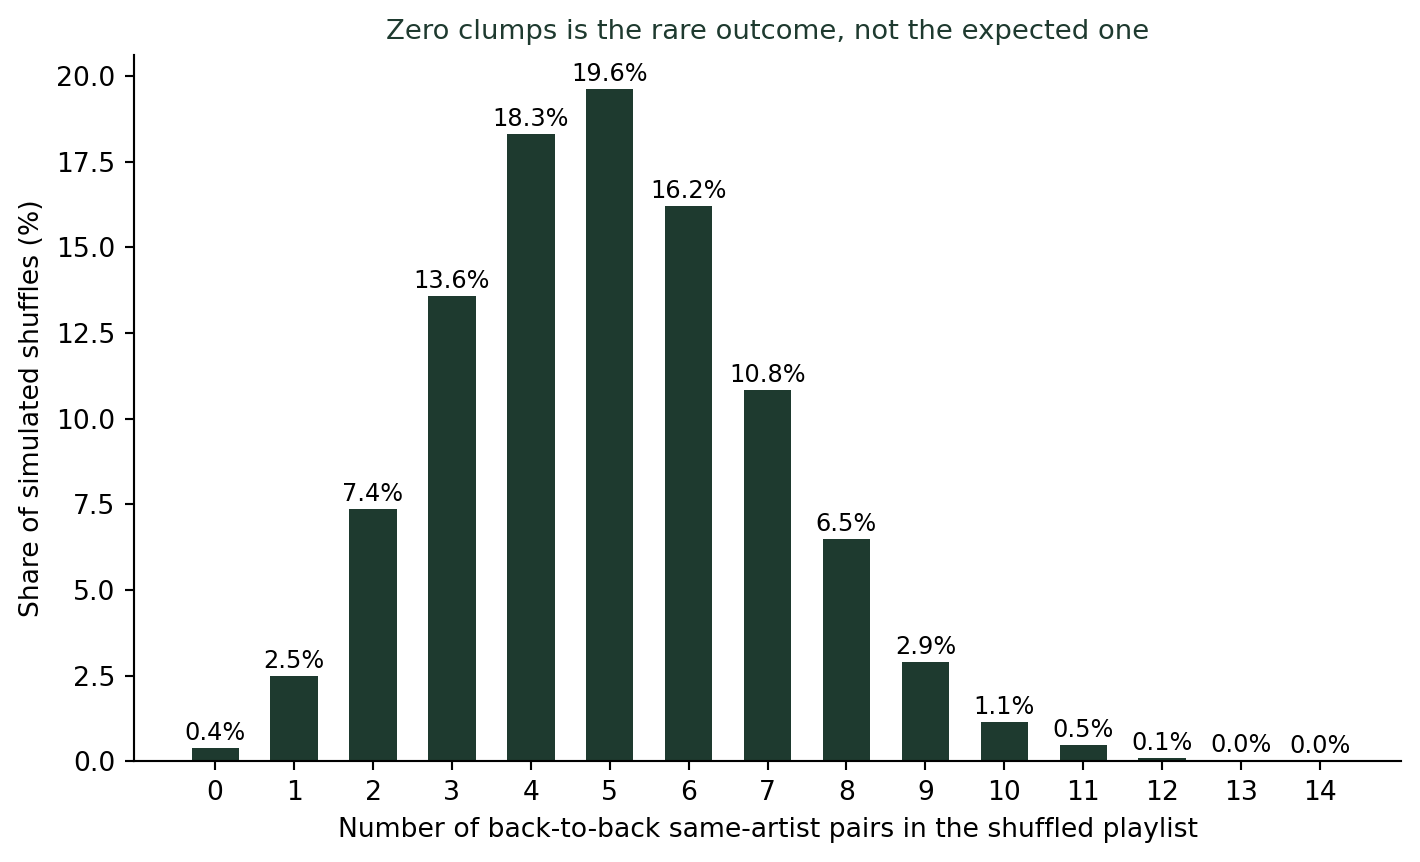
시뮬레이션 결과, 같은 아티스트가 한 번도 연달아 나오지 않는 “완벽하게 고른” 셔플은 0.4%밖에 안 된다. 평균적으로 한 재생목록에 이런 “뭉침”이 5번쯤 생긴다. 즉 이용자들이 항의한 “왜 자꾸 같은 가수가 연달아 나오죠?”라는 현상은 버그가 아니라, 진짜 무작위가 원래 하는 일이었다.
사람은 “고르게 흩어진 것”을 무작위라고 착각한다
우리 뇌는 무작위를 “예측할 수 없을 만큼 고르게 퍼진 상태”로 상상한다. 그런데 수학적으로 진짜 무작위(각 사건이 서로 독립)는 정반대다 — 뭉치거나 비는 구간이 생기는 게 오히려 자연스럽다. 오히려 뭉침이나 빈 구간이 전혀 없이 고르게 퍼진 배열은, 누군가 의도적으로 배치를 조정했다는 증거에 가깝다. 이 착각을 군집 착각(clustering illusion)이라 부른다. 제2차 세계대전 당시 런던 시민들이 독일군 V-1 로켓의 낙하 지점이 “특정 구역에 집중된 패턴”을 보인다며 그 지역에 스파이가 있다고 의심했던 사례도 같은 착각이었다 — 훗날 통계 분석 결과, 낙하 지점은 순수한 무작위(포아송) 분포와 통계적으로 구별되지 않았다.
군집 착각을 피하는 법
- “고르게 흩어져야 무작위답다”는 직관을 의심하라. 진짜 무작위는 뭉침과 빈 구간을 만드는 게 정상이다.
- 뭉쳐 보이는 패턴을 발견하면, 그게 순수한 우연으로 나올 확률부터 계산해보라. 오늘처럼 계산해보면 “이상한 뭉침”이 사실은 “가장 흔한 결과”인 경우가 많다.
- “덜 무작위하게” 설계된 시스템(플레이리스트 셔플, 좌석 배치 등)은 사용자 경험을 위한 것이지, 통계적 무작위성의 정의와는 다르다는 걸 구분하라.
더 깊이: 포아송 과정은 원래 뭉친다
강의노트 〈수리통계학 5. 유명분포 — 포아송분포〉는 사건들이 서로 독립적으로, 일정한 평균 발생률로 일어나는 과정을 포아송 과정으로 정의한다. 포아송 과정의 핵심은 사건 사이의 간격이 무작위(지수분포)라는 데 있다 — 간격이 일정하게 고정된 게 아니라 들쭉날쭉하다. 그 결과 짧은 구간에 사건이 몰리는 뭉침과, 사건이 뜸한 빈 구간이 함께 나타난다. 오늘 살펴본 플레이리스트 셔플이나 런던 폭격 지점이나, 수학적으로는 모두 “독립적인 사건들이 무작위 간격으로 발생한다”는 같은 포아송적 구조를 공유한다.
SDV 관점: “패턴이 보인다”는 보고를 검증하는 절차
무작위 배열에서 뭉침이 나올 확률을 계산하는 건 요약과 추론(1~2단계)에 해당하는 확률 계산이다. 제가 제안하는 SDV(통계적 데이터 가치화) 관점에서 이 문제가 중요한 이유는, 현업에서 “패턴이 보인다”는 보고가 끊임없이 올라오기 때문이다 — 특정 시간대에 불량품이 몰렸다, 특정 영업일에 고객 이탈이 몰렸다, 특정 구역에 사고가 몰렸다는 식이다. 오늘 확인했듯, 완전히 무작위한 과정에서도 이런 “몰림”은 기본값에 가깝다. 데이터를 가치 있는 결정으로 연결하려면, 뭉침을 발견한 즉시 원인을 찾아 나서기 전에 “이 정도 뭉침이 순수한 우연으로 나올 확률이 얼마인가”부터 계산해야 한다. 그 확률이 낮을 때만 자원을 들여 원인을 추적하는 것이, AI 시대에 통계학자가 설계해야 할 가치 있는 의사결정 절차다. (SDV(데이터 가치화))
결론: 고르게 섞였다면, 오히려 그게 이상한 것이다
나는 학생들에게 셔플 버튼을 누르고 같은 가수 노래가 연달아 나오면, 그걸 “앱이 이상하다”는 증거가 아니라 “무작위가 제대로 작동하고 있다”는 증거로 받아들이라고 말한다. 스포티파이와 애플이 결국 알고리즘을 “덜 무작위하게” 바꾼 이유는 수학이 틀려서가 아니라, 사람의 직관에 맞추기 위해서였다. 진짜 우연 앞에서는, 고르게 흩어지지 않는 쪽이 오히려 정상이다.
참고 자료
- Spotify Engineering, How to Shuffle Songs? (2014) — rnd.atspotify.com/how-to-shuffle-songs
- Spotify Engineering, Shuffle: Making Random Feel More Human (2025) — engineering.atspotify.com