권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • 데이터 플랫폼
  • 유튜브
  1. 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고

목차

  • “보통”이라는 말의 숨은 폭
  • 표준편차, 손으로 직접 계산해보자
  • 표준편차가 알려주는 것: “보통”의 실제 범위
  • 더 깊이: 실증적 법칙과 분산의 정의
  • 결론: 평균 뒤에는 항상 폭이 있다

(흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가

통계기초
기술통계
’오늘 낮 기온은 평년과 같은 27도’라는 예보를 들으면 안심이 된다. 그런데 평년 기온이 항상 정확히 27도였다는 뜻일까, 아니면 24도와 30도를 오가다 평균이 27도가 된 걸까? 이 둘을 구별해주는 숫자가 표준편차다. 배달 라이더 두 명의 배달 시간을 직접 손으로 계산해보며 표준편차의 의미를 알아본다.
Author

권세혁

Published

August 31, 2026

“보통”이라는 말의 숨은 폭

일기예보에서 “오늘 낮 최고기온은 평년과 같은 27도가 되겠습니다”라는 문장을 들으면 마음이 놓인다. 그런데 이 문장을 곰곰이 뜯어보면 숨겨진 질문이 하나 있다. 평년 기온이 매번 정확히 27도에 가까웠다는 뜻일까, 아니면 어떤 해는 22도, 어떤 해는 32도였는데 그걸 다 평균 내니 27도가 나온 걸까? 이 둘은 완전히 다른 상황이다. 앞의 경우라면 오늘 30도만 돼도 이례적인 더위지만, 뒤의 경우라면 30도는 그저 “그럴 수 있는” 평범한 하루다. 평균 하나만으로는 이 둘을 구별할 수 없다. 필요한 건 “보통”이 실제로 어느 정도의 폭을 가지고 움직이는지 알려주는 숫자 — 오늘부터 이번 주 다룰 표준편차(standard deviation)다.

표준편차, 손으로 직접 계산해보자

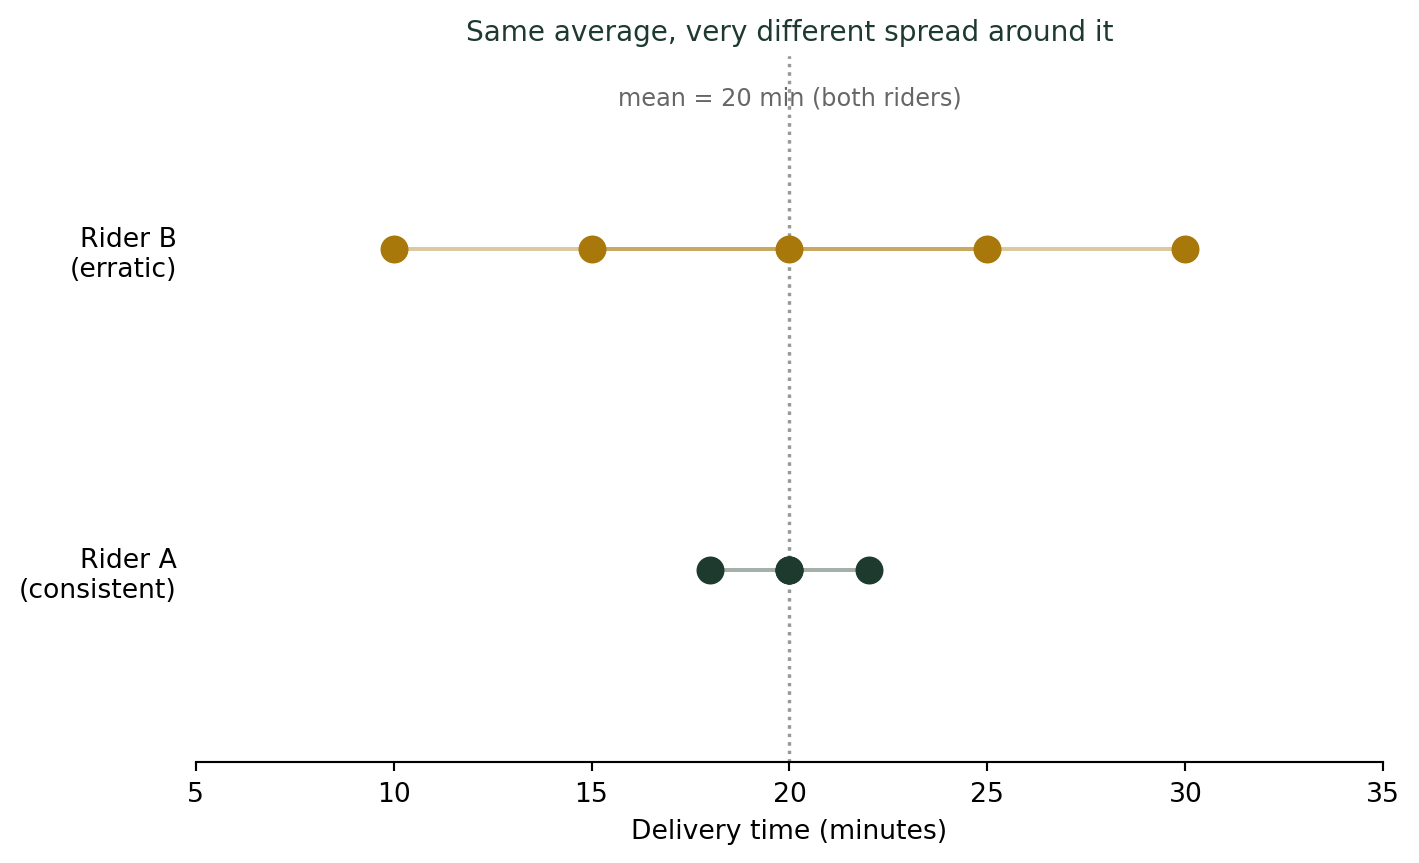
배달 라이더 두 명이 있다고 하자. 둘 다 최근 5건의 배달에 걸린 시간이 평균 20분으로 똑같다. 그런데 개별 기록을 보면 사뭇 다르다.

라이더 배달 시간(분) 평균
A (일관형) 18, 20, 22, 20, 20 20분
B (들쭉날쭉형) 10, 15, 20, 25, 30 20분

Five delivery times for two riders, both averaging exactly 20 minutes. Rider A’s times cluster tightly around the mean; Rider B’s swing widely. The vertical lines from each point to the mean are the deviations that standard deviation summarizes into a single number.

표준편차는 각 관측값이 평균에서 얼마나 떨어져 있는지(편차, deviation)를 하나의 대표 숫자로 요약한 것이다. 계산 순서는 이렇다.

  1. 각 값에서 평균을 뺀다 (편차).
  2. 편차를 제곱한다 (음수를 없애고, 큰 편차에 더 큰 벌점을 주기 위해).
  3. 제곱한 값들을 더하고, (\(n-1\))로 나눈다 — 이것이 분산(variance) \(s^2\)이다.
  4. 분산에 제곱근을 씌운다 — 이것이 표준편차 \(s\)다. 제곱근을 씌우는 이유는 단위를 원래 데이터와 같게(이 경우 “분”) 되돌리기 위해서다.

라이더 A는 편차가 \(-2, 0, 2, 0, 0\), 제곱하면 \(4, 0, 4, 0, 0\), 합이 8, \(8/(5-1) = 2.0\), 표준편차는 \(\sqrt{2.0} \approx\) 1.41분이다. 라이더 B는 편차가 \(-10, -5, 0, 5, 10\), 제곱하면 \(100, 25, 0, 25, 100\), 합이 250, \(250/4 = 62.5\), 표준편차는 \(\sqrt{62.5} \approx\) 7.91분이다. 평균은 똑같이 20분이지만, 라이더 A에게 배달을 맡기면 거의 항상 18~22분 안에 도착하고, 라이더 B는 10분 만에 올 수도 30분이 걸릴 수도 있다. 평균이 “어디쯤”을 말해준다면, 표준편차는 “그 주변에서 얼마나 흔들리는가”를 말해준다.

표준편차가 알려주는 것: “보통”의 실제 범위

표준편차의 진짜 쓸모는 여기서부터 시작된다. 분포가 좌우 대칭인 종 모양(정규분포에 가까운 모양)이라면, 평균으로부터 표준편차 1개 거리 안에 전체의 약 68%가, 2개 거리 안에 약 95%가 들어온다는 경험적 규칙이 있다. 이걸 8월 한 달의 낮 최고기온에 적용해보자.
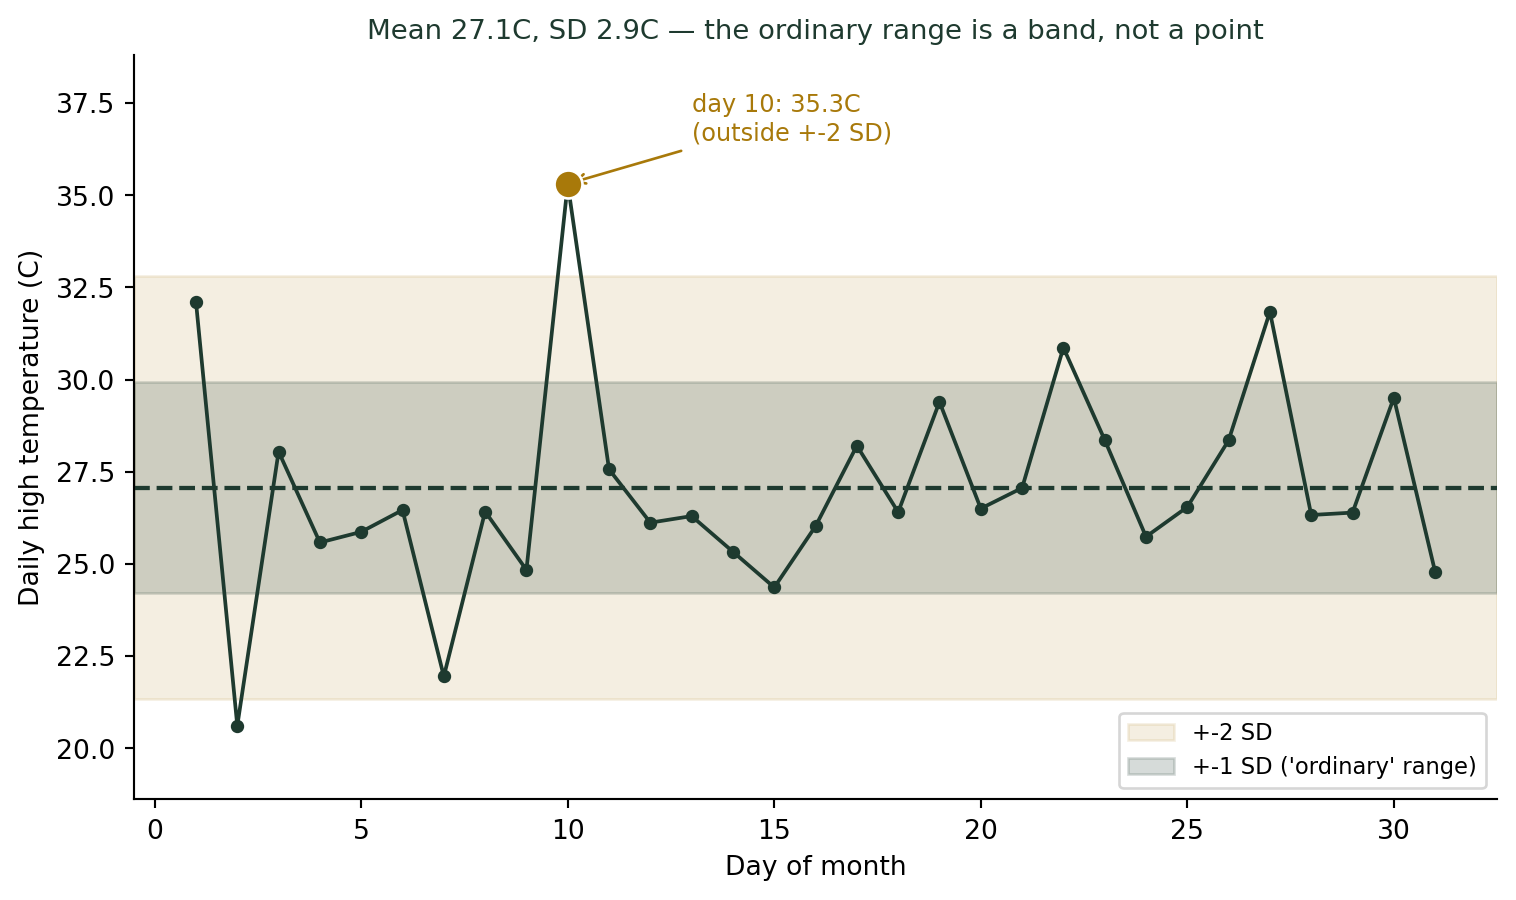
A stylized, illustrative month of daily high temperatures (not real KMA data) with a mean of 27.1C and standard deviation of 2.9C. The shaded bands mark +-1 SD (roughly the ‘ordinary’ range) and +-2 SD. Day 10, at 35.3C, sits well outside the 2-SD band — the kind of day a forecast would call unusually hot, not just ‘a bit above average.’

평균만 알면 “27도”라는 점 하나뿐이다. 표준편차까지 알면 “대략 24~30도 사이가 보통이고, 그 밖으로 벗어나면 이례적”이라는 범위가 생긴다. 10일째의 35.3도는 평균보다 8도 이상 높은데, 이는 단순히 “평균보다 더운 날”이 아니라 표준편차 2개(±2σ) 범위를 확실히 벗어난, 통계적으로 드문 날이라는 뜻이다. 표준편차가 없다면 “오늘 좀 덥네” 정도의 감상에 그치지만, 표준편차가 있으면 “이 정도 더위는 이 달에 한 번 나올까 말까 한 수준”이라고 구체적으로 말할 수 있다.

표준편차를 읽는 법
  1. 표준편차가 작다 → 값들이 평균 가까이 몰려 있다. 예측 가능하고 “믿을 만하다.”
  2. 표준편차가 크다 → 값들이 넓게 흩어져 있다. 평균만으로는 실제로 무슨 일이 일어날지 가늠하기 어렵다.
  3. 평균 ± 표준편차 범위가 대략 “보통”의 실질적인 정의다. 그 범위를 크게 벗어난 값이라야 “이례적이다”라고 말할 자격이 있다.

더 깊이: 실증적 법칙과 분산의 정의

강의노트 〈수리통계학 2. 확률변수 — 실증적 법칙(Empirical Rule)〉는 분포가 좌우 대칭인 종 모양일 때 \(P(|X-\mu| < k\sigma)\)가 \(k=1\)이면 적어도 68%, \(k=2\)면 적어도 95%, \(k=3\)이면 적어도 99.8%라고 정리한다 — 오늘 기온 그래프에서 그려본 두 개의 띠가 바로 이 법칙을 시각화한 것이다. 이 법칙이 성립하는 근거는 〈수리통계학 4. 기대값 — 주요 기대값〉이 정의하는 분산 \(\text{Var}(X) = E[(X-\mu)^2]\)과 표준편차 \(\sigma = \sqrt{\text{Var}(X)}\)에 있다. 오늘 라이더 예제에서 손으로 계산한 “편차 제곱의 평균”이 바로 이 정의를 표본 자료에 그대로 적용한 것이다.

결론: 평균 뒤에는 항상 폭이 있다

나는 학생들에게 평균을 배운 다음 날 표준편차를 가르치며 이렇게 말한다. “평균은 질문의 절반에만 답합니다.” 어디쯤에 있는지는 평균이 말해주지만, 그 주변이 얼마나 넓은지는 표준편차만이 말해줄 수 있다. 오늘 소개한 계산법 — 편차를 구하고, 제곱하고, 평균 내고, 제곱근을 씌우는 이 네 단계 — 은 이번 주 나머지 나흘 동안 다룰 이상치, 표준점수, 변동계수, 심슨의 역설을 이해하는 데 필요한 가장 기본적인 도구다. “보통”이라는 말을 들으면, 이제부터는 그 폭이 얼마인지부터 물어보자.

참고 자료
  • Empirical Rule (68-95-99.7 rule) — 정규분포에 가까운 대칭 분포에서 성립하는 경험적 법칙.
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08