권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • 데이터 플랫폼
  • 유튜브
  1. 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고
  • 📖 (위험과 불확실성을 이해하는 법) 비 올 확률 60%는 무슨 뜻인가? — 확률적 예보 읽는 법
  • 📖 (위험과 불확실성을 이해하는 법) 100년 빈도 홍수는 100년에 한 번만 오는가? — 재현빈도의 오해
  • 📖 (위험과 불확실성을 이해하는 법) 보험회사는 어떻게 사고를 예측하는가? — 기대손실
  • 📖 (위험과 불확실성을 이해하는 법) 발생 가능성은 낮지만 피해가 큰 사건을 어떻게 볼 것인가? — 저확률·고피해 리스크
  • 📖 (위험과 불확실성을 이해하는 법) 위험은 확률과 피해 크기의 결합이다 — 위험 평가의 원칙

목차

  • 똑같이 만점인데, 표준점수는 다르다
  • 표준점수는 사실 “몇 표준편차 위에 있는가”를 보기 좋게 늘어놓은 것
  • 편차값의 비밀: 같은 개념, 다른 눈금
  • 더 깊이: 표준화의 원리, \(Z = (X-\mu)/\sigma\)
  • 결론: 원점수는 “얼마나 맞혔는가”, 표준점수는 “얼마나 잘했는가”

(흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀

통계기초
기술통계
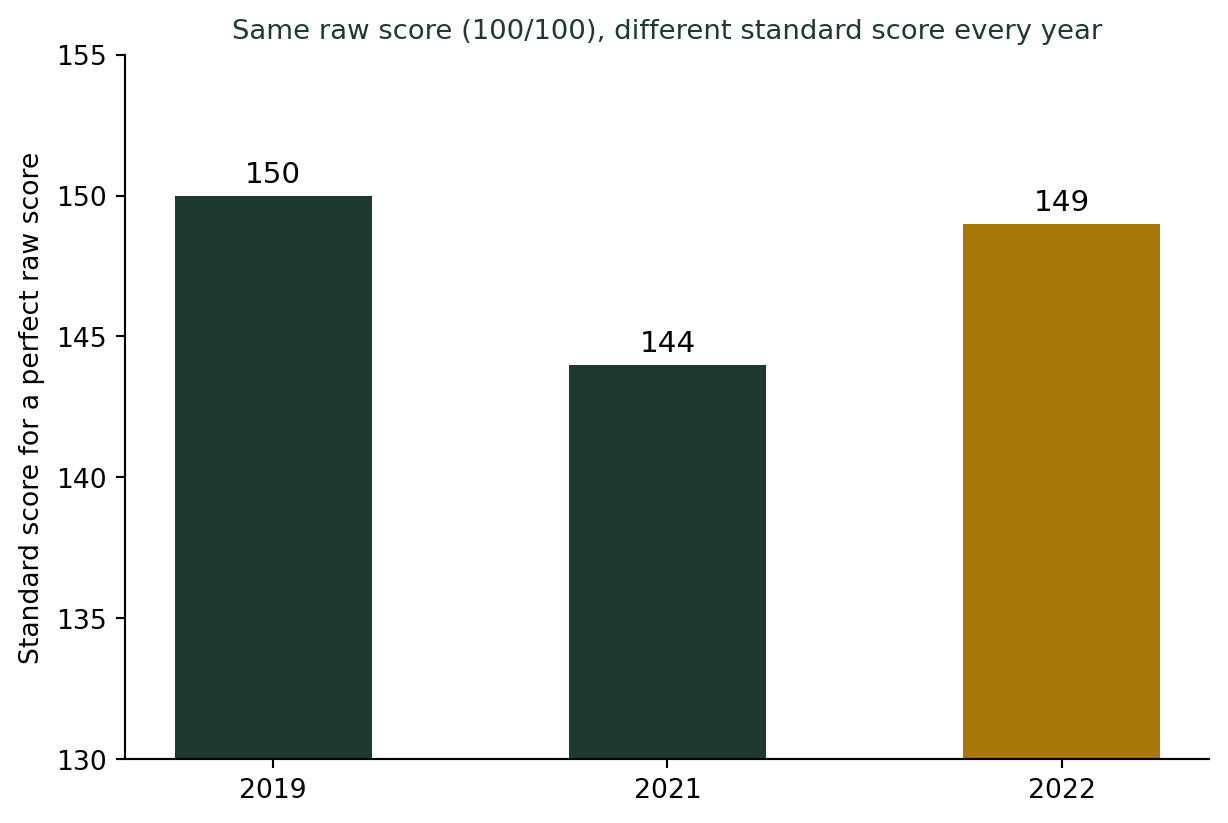
2019학년도 수능 국어 만점자의 표준점수는 150점, 2022학년도 만점자는 149점이었다. 둘 다 원점수는 100점(만점)인데 표준점수는 다르다. 그 해 시험이 얼마나 어려웠는지, 즉 평균과 표준편차가 해마다 다르기 때문이다. 어제 배운 표준편차가 어떻게 ’점수를 공정하게 비교하는 도구’로 쓰이는지 살펴본다.
Author

권세혁

Published

September 2, 2026

똑같이 만점인데, 표준점수는 다르다

수능이 끝나면 늘 나오는 뉴스가 있다. “이번 수능 국어, 만점자 표준점수 OOO점.” 그런데 이상하지 않은가? 국어 시험은 원점수 100점이 만점이다. 만점은 어느 해든 100점으로 똑같은데, 왜 “표준점수”는 해마다 달라질까? 실제 기록을 보면 이렇다.

학년도 국어 만점자 표준점수 체감 난이도
2019학년도 150점 역대 최고 수준
2021학년도 144점 비교적 평이
2022학년도 149점 “불수능”

The top standard score for a perfect raw score (100/100) on the Korean-language section of Korea’s national college entrance exam (CSAT), across three years. Every one of these students got exactly the same raw score - 100 out of 100 - yet their standard scores differ by up to 6 points, purely because each year’s exam had a different mean and spread.

원점수는 똑같이 100점인데 표준점수가 144점에서 150점까지 오르내린다. 그 해 시험이 어려워서 평균이 낮고 점수가 넓게 흩어질수록(표준편차가 클수록), 만점의 “가치”는 더 높게 평가된다. 이 변환의 정체가 바로 어제 배운 표준편차다.

표준점수는 사실 “몇 표준편차 위에 있는가”를 보기 좋게 늘어놓은 것

한국교육과정평가원이 실제로 쓰는 국어·수학 영역 표준점수 공식은 이렇다.

\[\text{표준점수} = 20 \times \frac{\text{원점수} - \text{평균}}{\text{표준편차}} + 100\]

가운데 분수 부분, \((\text{원점수} - \text{평균})/\text{표준편차}\)가 바로 표준화 점수(z-점수)다 — 내 점수가 평균에서 표준편차 몇 개만큼 떨어져 있는지를 나타내는 수치다. 여기에 20을 곱하고 100을 더하는 건, 마이너스 부호나 소수점이 섞인 z-점수를 “평균 100, 어느 정도 퍼져 있는 점수”라는 익숙한 모양으로 보기 좋게 늘어놓은 것뿐이다.

같은 원점수 88점을 받은 두 학생을 비교해보자. 한 명은 평균 75점, 표준편차 10점인 “쉬운 해”에 시험을 봤고, 다른 한 명은 평균 55점, 표준편차 18점인 “어려운 해”에 시험을 봤다.
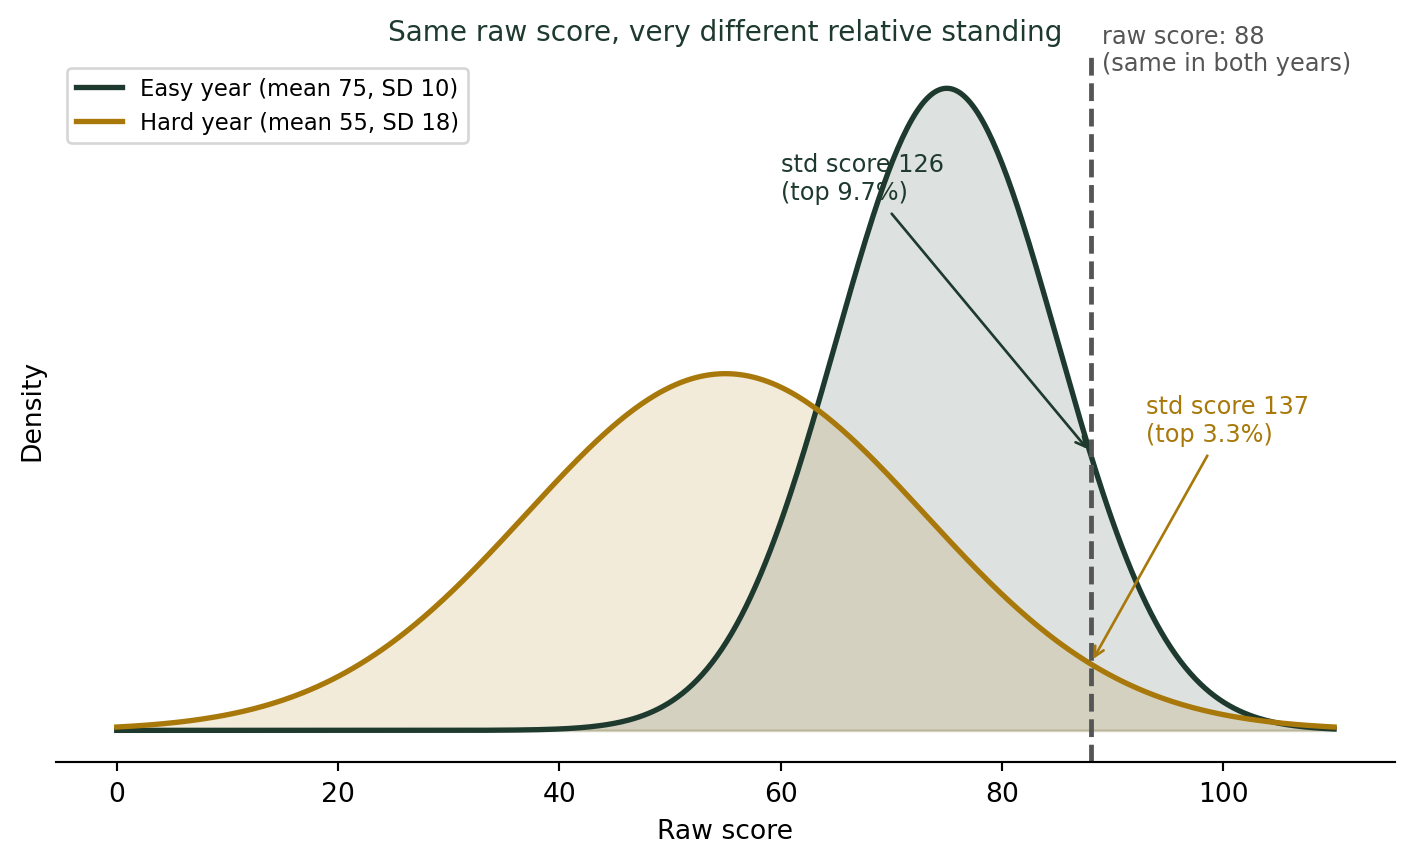
The same raw score of 88 (dashed line) in two hypothetical exam years with different means and spreads. In the easy year (mean 75, SD 10), 88 lands at the top 9.7% of test-takers. In the hard year (mean 55, SD 18), the same 88 lands at the top 3.3% - a much rarer, stronger relative performance, which the raw score alone cannot show.

원점수는 똑같이 88점이지만, 쉬운 해에는 상위 9.7%(표준점수 126점), 어려운 해에는 상위 3.3%(표준점수 137점)에 해당한다. 대학이 원점수만 보고 학생을 뽑는다면, 어려운 해에 88점을 받은 학생의 진짜 실력이 과소평가된다. 표준점수는 “그 해, 그 시험 안에서 상대적으로 얼마나 잘했는가”를 담아내기 위한 장치다.

편차값의 비밀: 같은 개념, 다른 눈금

흥미롭게도 수능은 영역마다 눈금을 다르게 쓴다. 국어·수학은 “평균 100, 표준편차 20”으로 늘어놓지만(\(20z+100\)), 탐구영역·제2외국어·한문은 “평균 50, 표준편차 10”으로 늘어놓는다(\(10z+50\)). 이 “평균 50, 표준편차 10” 눈금은 일본식 입시 용어 “편차값(偏差値)”과 정확히 같은 공식이다.

편차값의 비밀

두 공식은 겉보기에 다른 점수처럼 보이지만, 사실은 똑같은 z-점수에 서로 다른 배율(20 또는 10)과 기준점(100 또는 50)을 곱하고 더한 것뿐이다. “표준점수 120점”과 “편차값 60”은 둘 다 z=1, 즉 평균보다 표준편차 1개만큼 위에 있다는 같은 뜻이다. 표준점수의 진짜 비밀은 복잡한 공식이 아니라, 어떤 눈금을 쓰든 결국은 “평균에서 표준편차 몇 개만큼 떨어져 있는가”라는 하나의 질문으로 귀결된다는 것이다.

표준점수를 읽는 법
  1. 표준점수가 100(또는 50)보다 높다 → 그 해 평균보다 잘 봤다는 뜻이다. 원점수가 몇 점인지는 중요하지 않다.
  2. 표준점수의 최고점이 해마다 다른 이유는 시험 난이도(평균·표준편차)가 다르기 때문이다. 표준점수가 높은 해라고 학생들 실력이 늘어난 게 아니라, 그 해 시험이 어려워 점수가 넓게 흩어졌다는 뜻일 때가 많다.
  3. 원점수만으로 다른 과목·다른 해의 성적을 비교하면 안 된다. 표준점수는 바로 이 비교 불가능성을 해결하기 위해 만들어졌다.

더 깊이: 표준화의 원리, \(Z = (X-\mu)/\sigma\)

강의노트 〈수리통계학 3. 유명분포 — 정규분포〉는 \(X \sim N(\mu, \sigma^2)\)를 따르는 확률변수에 대해 \(Z = (X-\mu)/\sigma\)로 변환하면 항상 표준정규분포 \(N(0,1)\)을 따른다고 정리한다. 원래 분포가 무엇이든(국어 100점 만점이든, 수학 만점이든), 평균을 빼고 표준편차로 나누는 이 한 번의 변환으로 서로 다른 두 시험 결과를 같은 저울 위에 올릴 수 있다. 수능의 표준점수 공식 \(20Z+100\)은 이 이론적 \(Z\)에 시험 주관사가 보기 편한 배율과 기준점을 씌운 것에 지나지 않는다.

결론: 원점수는 “얼마나 맞혔는가”, 표준점수는 “얼마나 잘했는가”

나는 수능 채점 결과가 발표되는 매년 12월, 학생들에게 이 표를 보여주며 묻는다. “100점 만점을 받은 두 사람 중 누가 더 대단한 걸까요?” 답은 원점수만으로는 알 수 없다. 그 해 평균과 표준편차를 알아야, 즉 그 100점이 얼마나 드문 성취였는지를 알아야 답할 수 있다. 어제 표준편차가 “보통의 폭”을 재는 도구였다면, 오늘 표준점수는 그 폭을 이용해 서로 다른 잣대로 잰 점수들을 하나의 공정한 저울 위에 올려놓는 도구다.

참고 자료
  • 역대급 ‘불수능’ 사실로…국어 표점 149, 수학 147 — 파이낸셜뉴스
  • 한국교육과정평가원, 수능 표준점수 산출 공식(국어·수학: \(20Z+100\), 탐구/제2외국어·한문: \(10Z+50\))
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08