권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • 데이터 플랫폼
  • 유튜브
  1. 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고
  • 📖 (위험과 불확실성을 이해하는 법) 비 올 확률 60%는 무슨 뜻인가? — 확률적 예보 읽는 법
  • 📖 (위험과 불확실성을 이해하는 법) 100년 빈도 홍수는 100년에 한 번만 오는가? — 재현빈도의 오해
  • 📖 (위험과 불확실성을 이해하는 법) 보험회사는 어떻게 사고를 예측하는가? — 기대손실
  • 📖 (위험과 불확실성을 이해하는 법) 발생 가능성은 낮지만 피해가 큰 사건을 어떻게 볼 것인가? — 저확률·고피해 리스크
  • 📖 (위험과 불확실성을 이해하는 법) 위험은 확률과 피해 크기의 결합이다 — 위험 평가의 원칙

목차

  • 학과별로는 여성이 이겼는데, 전체 합격률은 남성이 높았다
  • 단순화한 숫자로 직접 확인해보자
  • 역설이 일어나는 진짜 이유: 지원자 수의 쏠림
  • 더 깊이: 교란변수와 집계 편향
  • 결론: 전체 숫자 하나만 보고 승부를 가르지 말라

(흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설

통계기초
기술통계
1973년 UC버클리 대학원 입학 통계는 남성 합격률 44.2%, 여성 합격률 34.6%로 성차별 소송까지 갔다. 그런데 개별 학과별로 뜯어보니 6개 주요 학과 중 4곳에서 오히려 여성 합격률이 더 높았다. 부분에서 이기고도 전체에서 지는 이 역설의 정체를 단순화한 숫자 예시로 직접 확인한다.
Author

권세혁

Published

September 4, 2026

학과별로는 여성이 이겼는데, 전체 합격률은 남성이 높았다

1973년 UC버클리 대학원은 12,763명의 지원자를 심사했다. 전체 합격률을 성별로 나눠보니 남성 44.2%, 여성 34.6%로 거의 10%포인트 차이가 났다. 이 정도 격차는 성차별 소송으로 이어질 만큼 심각해 보였다. 그런데 통계학자 피터 비켈(Peter Bickel)과 동료들이 학과별로 데이터를 다시 뜯어보자 이상한 일이 벌어졌다. 6개 주요 학과 중 4곳에서 여성의 합격률이 오히려 남성보다 높거나 비슷했다. 부분(학과)에서는 여성이 이기거나 비겼는데, 전체 합계에서는 남성이 크게 앞섰다. 어떻게 이런 일이 가능할까?

단순화한 숫자로 직접 확인해보자

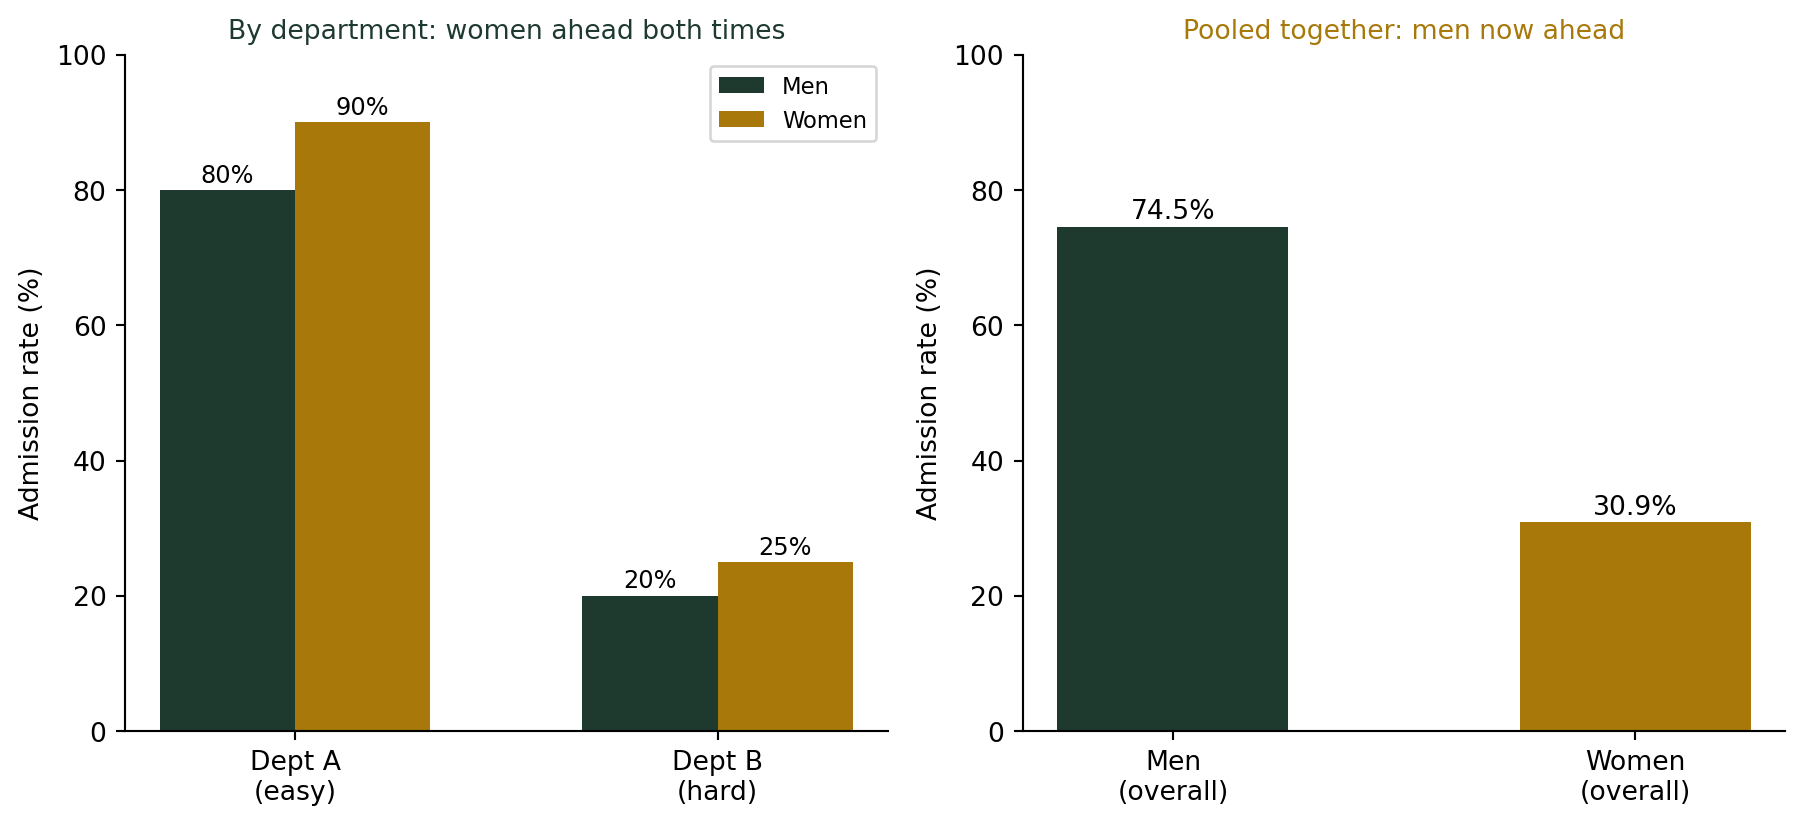
버클리의 실제 자료는 학과가 6개가 넘어 복잡하니, 같은 원리를 두 학과짜리 단순한 예시로 재현해보자. 아래는 실제 버클리 수치가 아니라, 역설이 일어나는 메커니즘을 보여주기 위한 가상의 예시다.

학과 남성 지원 남성 합격 남성 합격률 여성 지원 여성 합격 여성 합격률
A (쉬운 학과) 100명 80명 80% 10명 9명 90%
B (어려운 학과) 10명 2명 20% 100명 25명 25%
합계 110명 82명 74.5% 110명 34명 30.9%

Left: admission rate by department - women have a higher rate in both Department A and Department B. Right: the same data pooled into an overall rate - men now come out far ahead. Nothing about any individual applicant changed; only how the numbers were grouped changed.

왼쪽 그래프를 보면 학과 A, 학과 B 어디서든 여성 막대가 더 높다. 그런데 오른쪽처럼 두 학과를 합쳐 전체 합격률을 계산하면 순위가 뒤집힌다. 이게 바로 심슨의 역설(Simpson’s paradox)이다. 아무도 숫자를 조작하지 않았다. 어떤 지원자의 결과도 바뀌지 않았다. 단지 어떻게 묶어서 보느냐만 바뀌었을 뿐인데, 결론이 정반대가 됐다.

역설이 일어나는 진짜 이유: 지원자 수의 쏠림

표를 다시 보면 답이 보인다. 남성은 쉬운 학과 A에 압도적으로 많이(100명) 지원했고, 여성은 어려운 학과 B에 압도적으로 많이(100명) 지원했다. 학과 A는 원래 합격률 자체가 높고(80~90%대), 학과 B는 원래 합격률 자체가 낮다(20~25%대). 그러니 학과 A에 몰린 남성 집단은 “쉬운 시험을 많이 본 덕분에” 전체 합격률이 높게 나오고, 학과 B에 몰린 여성 집단은 “어려운 시험을 많이 본 탓에” 전체 합격률이 낮게 나온다. 실제 버클리 사건에서도 결론은 같았다 — 여성 지원자들이 경쟁이 치열해 원래 합격률이 낮은 인기 학과에 상대적으로 더 많이 지원했기 때문에, 학과별로는 차별이 없었는데도(오히려 약간 유리했는데도) 전체 합계는 불리하게 나온 것이었다.

전체 합계는 사실 “가중평균”이다

전체 합격률은 단순한 평균이 아니라, 각 학과 지원자 수를 가중치로 삼은 가중평균이다. 남성의 가중치는 쉬운 학과 A에, 여성의 가중치는 어려운 학과 B에 몰려 있었기 때문에, 학과별 순위와 전체 순위가 어긋난 것이다. 두 집단이 하위 범주에 다른 비율로 분포해 있을 때, 이 역설은 언제든 나타날 수 있다.

집계 통계를 마주하면 확인할 것
  1. 비교하는 두 집단이 하위 범주(학과, 부서, 병원, 연령대 등)에 비슷한 비율로 분포해 있는가? 아니라면 전체 합계는 왜곡될 수 있다.
  2. 전체 결론과 세부 결론이 다르다면, 세부 결론을 우선 믿어라. 세부 집단 안에서는 비교 대상의 조건이 훨씬 비슷하기 때문이다.
  3. “이 두 집단을 가르는 제3의 변수(학과 선택, 병의 중증도, 지역 등)가 있는가”를 항상 물어라. 그 변수가 바로 역설을 일으키는 숨은 손이다.

더 깊이: 교란변수와 집계 편향

강의노트 〈기초통계학 3. 통계의 이해 — 확률 해석의 함정〉이 정리하는 “통계 해석의 주요 함정” 표에는 오늘 다룬 역설과 정확히 맞아떨어지는 두 항목이 나란히 있다. 교란변수는 “실제 원인인 제3 변수를 간과하는 것”이고, 집계 편향은 “표본 구성 변화로 인한 왜곡 — 집계 통계량이 부분 집단의 경향을 숨기는 것”이다. 오늘 버클리 사례에서 학과 선택이 바로 그 교란변수였다 — 성별과도 관련이 있고(여성이 어려운 학과에 더 많이 지원) 합격률과도 관련이 있는(학과마다 원래 난이도가 다른) 제3의 변수가 숨어 있었기 때문에, 이를 무시한 집계 통계는 실제와 반대되는 그림을 그렸다.

결론: 전체 숫자 하나만 보고 승부를 가르지 말라

나는 학생들에게 “전체 평균이 이렇다”는 뉴스나 보고서를 볼 때마다 이렇게 물으라고 말한다. “이 전체 숫자는 어떤 하위 집단들을 어떤 비율로 섞은 것인가?” 이번 주 우리는 표준편차로 흩어짐을 재고, 이상치 하나가 그 흩어짐을 얼마나 흔드는지 보고, 표준점수로 서로 다른 잣대를 하나로 맞추고, 변동계수로 단위가 다른 흩어짐을 비교했다. 오늘의 심슨의 역설은 이 모든 이야기의 마지막 경고다 — 부분과 전체가 다른 말을 할 때는, 그 차이 자체가 숨은 변수를 찾으라는 신호라는 것.

참고 자료
  • Bickel, P. J., Hammel, E. A., & O’Connell, J. W. (1975). Sex bias in graduate admissions: Data from Berkeley. Science, 187(4175), 398-404.
  • Simpson’s paradox — Wikipedia
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08