권세혁HOME
  • about & me
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • AI_플랫폼(주식 매수 점수)
  • 유튜브
  1. 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음

목차

  • 실업률 2.0%, 그런데 체감 실업률은 7.6%
  • 실업자가 되려면 세 가지 조건을 다 채워야 한다
  • 더 깊이: 지표가 측정하는 것을 오해하는 함정
  • SDV 관점: 좁은 정의를 넓은 정책으로 잇기
  • 결론: 실업률 숫자 뒤에 숨은 사람들

(공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의

통계기초
기술통계
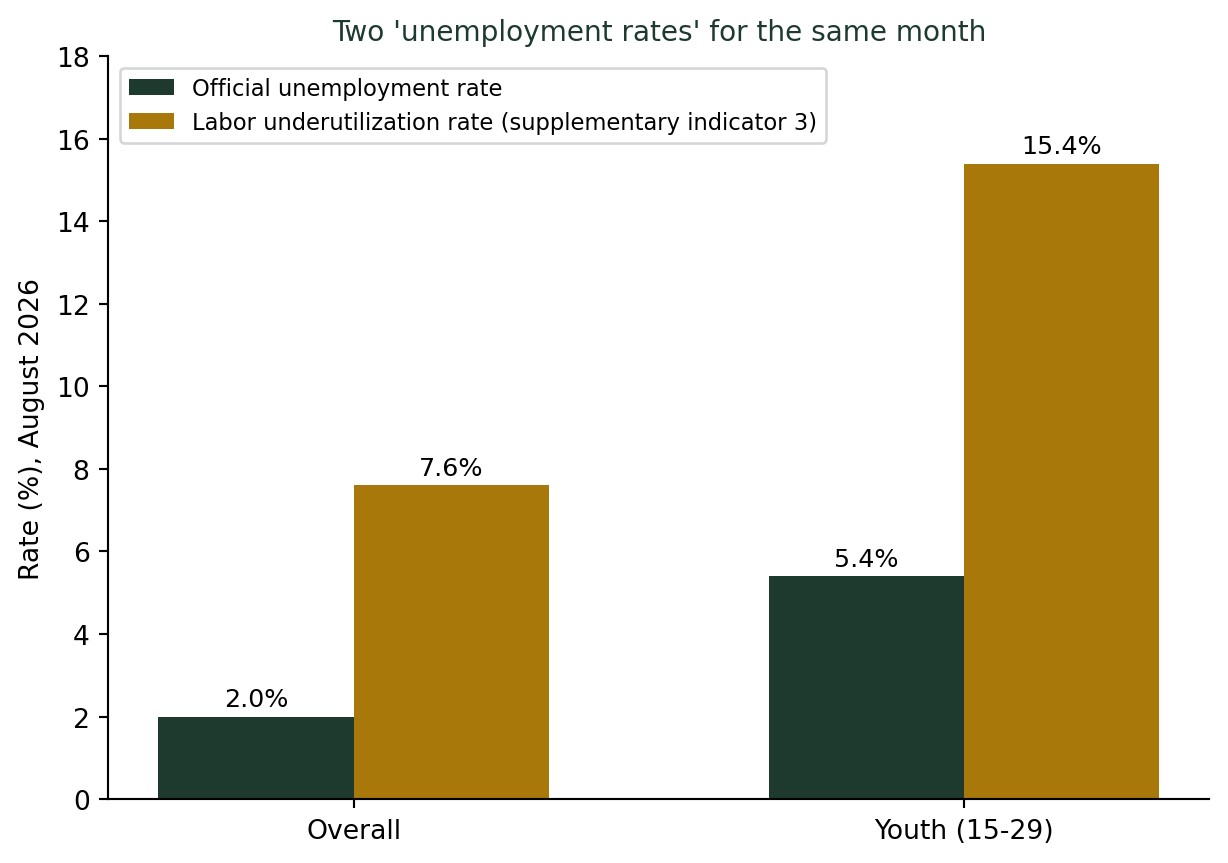
2026년 8월, 한국의 공식 실업률은 2.0%였다. 그런데 같은 달 국가데이터처가 함께 발표한 ’고용보조지표3’은 7.6%다. 청년층은 5.4%와 15.4%로 격차가 10%포인트나 된다. 같은 나라, 같은 달인데 왜 이렇게 다를까? 답은 ’실업자’라는 단어를 어디까지 세느냐에 있다.
Author

권세혁

Published

September 16, 2026

실업률 2.0%, 그런데 체감 실업률은 7.6%

2026년 8월 발표된 한국의 공식 실업률은 2.0%였다. 실업자 수는 58만 8천 명으로 1년 전보다 오히려 4천 명 줄었다. 숫자만 보면 거의 완전고용에 가깝다. 그런데 같은 달, 같은 통계 안에 실업률과 나란히 발표되는 또 다른 숫자가 있다. 고용보조지표3(확장실업률)은 7.6%다. 청년층(15~29세)으로 좁혀 보면 격차가 더 벌어진다 — 공식 청년실업률 5.4%, 고용보조지표3 기준 청년 체감실업률 15.4%. 같은 나라, 같은 달, 같은 연령대인데 두 숫자는 3배 가까이 차이가 난다.

South Korea’s official unemployment rate versus the supplementary ‘labor underutilization’ measure (고용보조지표3, roughly equivalent to the U.S. Bureau of Labor Statistics’ U-6), for August 2026. For the overall population the gap is 5.6 percentage points; for young adults (15-29) it widens to about 10 points.

실업자가 되려면 세 가지 조건을 다 채워야 한다

국가데이터처의 경제활동인구조사는 실업자를 이렇게 정의한다 — ① 현재 수입 있는 일을 하지 않고, ② 지난 4주간 적극적으로 구직활동을 했으며, ③ 일자리가 주어지면 2주 안에 즉시 취업할 수 있는 사람. 국제노동기구(ILO) 기준을 그대로 따른 정의다. 문제는 이 세 조건 중 하나라도 빠지면, 아무리 일하고 싶어도 실업자로 잡히지 않는다는 데 있다. 대표적인 사례가 구직단념자다. 지난 1년 안에 구직 경험은 있었지만, 반복된 실패나 눈높이에 맞는 일자리가 없어서 최근 4주간은 구직활동을 쉰 사람들이다. 이들은 실업자가 아니라 주부·학생과 같은 비경제활동인구로 분류되어, 실업률 계산식의 분자에서도 분모에서도 통째로 빠진다.
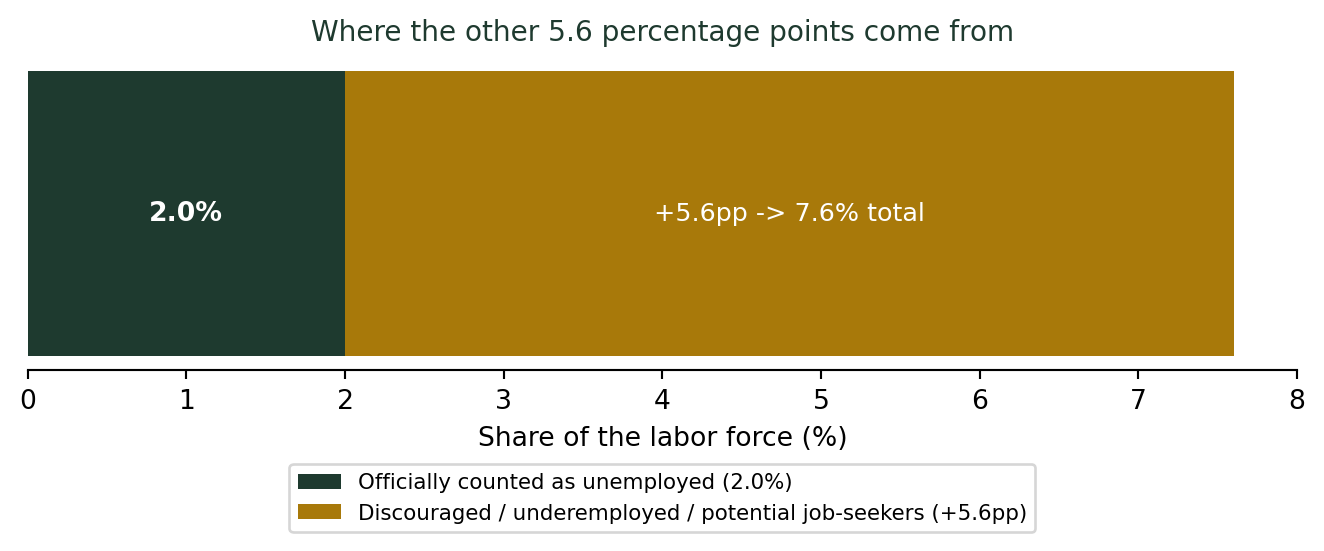
How the official unemployment rate (2.0%) grows into the broader 7.6% labor underutilization figure. The extra 5.6 percentage points come from people the narrow definition misses entirely: discouraged job-seekers who gave up searching in the last 4 weeks, part-time workers who want more hours but can’t get them, and others with the will and ability to work who don’t meet the strict ‘actively searching’ test.

국가데이터처는 이 사각지대를 메우기 위해 2014년부터 고용보조지표를 함께 발표한다. 그중 가장 넓은 범위를 보는 고용보조지표3은 ① 공식 실업자에 더해 ② 지금 일은 하고 있지만 더 일하고 싶어 하는 단시간 근로자(시간관련 추가취업가능자), ③ 구직단념자처럼 취업 의사와 능력은 있지만 최근 4주 기준을 채우지 못한 잠재구직자까지 모두 포함한다. 2026년 8월, 이 범위를 넓히자 실업률은 2.0%에서 7.6%로 뛰었다.

실업률을 읽는 법
  1. “실업률 X%”라는 숫자를 보면, 그 옆에 고용보조지표(체감실업률)가 함께 있는지 확인하라. 국가데이터처는 매달 두 숫자를 나란히 발표한다.
  2. 청년층·고령층처럼 구직을 쉽게 포기하는 집단일수록, 공식 실업률과 체감실업률의 격차가 크다.
  3. “실업률이 낮다”는 말이 “일자리 사정이 좋다”는 뜻은 아닐 수 있다. 구직을 아예 포기한 사람이 늘어도 공식 실업률은 오히려 낮아질 수 있다.

더 깊이: 지표가 측정하는 것을 오해하는 함정

강의노트 〈기초통계학 3. 통계의 이해 — 확률 해석의 함정〉이 정리한 “통계 해석의 주요 함정” 표에는 정확히 이 문제를 짚는 항목이 있다: “측정 지표 오해 — 지표가 측정하는 것을 잘못 이해. 실업률은 구직 포기자를 제외하므로 과소 추정 가능.” 오늘 살펴본 5.6%포인트의 격차가 바로 이 함정의 실제 크기다. 통계가 잘못된 게 아니라, “실업률”이라는 단어가 우리 직관보다 훨씬 좁은 것을 세고 있다는 사실을 모르는 게 함정이다.

SDV 관점: 좁은 정의를 넓은 정책으로 잇기

실업자를 정의하고 실업률을 계산하는 일은 요약(기술통계, 1단계)이고, 오늘처럼 그 정의의 사각지대를 고용보조지표3과 비교해 드러내는 작업은 추론(2단계)이다. 제가 제안하는 SDV(통계적 데이터 가치화) 관점에서 보면, 이 숫자들의 진짜 쓸모는 그다음부터 시작된다. 청년고용 대책, 구직단념자 지원 예산, 시간제 일자리의 정규직 전환 정책 같은 실제 결정은 2.0%가 아니라 7.6%, 그리고 그 안의 세부 구성을 근거로 설계해야 한다. 좁은 정의의 숫자 하나만 보고 정책을 짜면, 정작 가장 도움이 필요한 사람들이 통계에서부터 빠져 있다는 걸 놓치게 된다. 숫자를 정확히 재는 것과, 그 숫자로 옳은 결정을 설계하는 것은 다른 일이다. (about SDV & me)

결론: 실업률 숫자 뒤에 숨은 사람들

나는 학생들에게 “실업률이 낮다”는 뉴스를 볼 때마다 “그럼 구직단념자는 몇 명이었을까?”를 함께 찾아보라고 말한다. 공식 실업률은 거짓말을 하지 않는다. 다만 그 정의 밖에 서 있는 사람들에 대해서는 아무 말도 하지 않을 뿐이다. 공식 통계를 읽는다는 건, 그 통계가 무엇을 세고 무엇을 빼놓았는지부터 확인하는 일이다.

참고 자료
  • 8월 취업자 18만4,000명 증가…청년층은 46개월째 감소 — 산업종합저널
  • 고용률 8월 사상 첫 70%…청년 취업난은 여전 — 한국일보
  • 고용보조지표(전체) — KOSIS
  • 취업준비생은 실업자인가? — KDI 나라경제


방문자 수 since 2026.08.08