권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • 데이터 플랫폼
  • 유튜브
  1. 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고
  • 📖 (위험과 불확실성을 이해하는 법) 비 올 확률 60%는 무슨 뜻인가? — 확률적 예보 읽는 법
  • 📖 (위험과 불확실성을 이해하는 법) 100년 빈도 홍수는 100년에 한 번만 오는가? — 재현빈도의 오해
  • 📖 (위험과 불확실성을 이해하는 법) 보험회사는 어떻게 사고를 예측하는가? — 기대손실
  • 📖 (위험과 불확실성을 이해하는 법) 발생 가능성은 낮지만 피해가 큰 사건을 어떻게 볼 것인가? — 저확률·고피해 리스크
  • 📖 (위험과 불확실성을 이해하는 법) 위험은 확률과 피해 크기의 결합이다 — 위험 평가의 원칙
  • 📖 (확률의 뒷이야기) 문을 바꾸면 정말 유리할까 — 몬티홀 문제
  • 📖 (확률의 뒷이야기) 시행이 많아질수록 진짜 확률에 가까워지는 이유 — 큰 수의 법칙
  • 📖 (확률의 뒷이야기) 벼락 맞을 확률과 나란히 놓아보면 — 로또 1등의 확률
  • 📖 (확률의 뒷이야기) 그럴듯하게 느껴지는 이유 — 혈액형 성격론과 바넘 효과
  • 📖 (확률의 뒷이야기) 우연과 확증편향 사이 — 징크스는 통계적으로 존재할까

목차

  • 니콜라스 케이지와 익사 사고, 치즈와 침대시트
  • 우연히도, 이 정도 상관은 생각보다 흔하다
  • 더 깊이: 상관과 인과를 혼동하는 함정
  • SDV 관점: 상관에서 멈추지 않고 인과로 나아가기
  • 결론: 챕터 1을 마치며 — 숫자 다음엔 항상 질문이 있다

(공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음

통계기초
상관분석
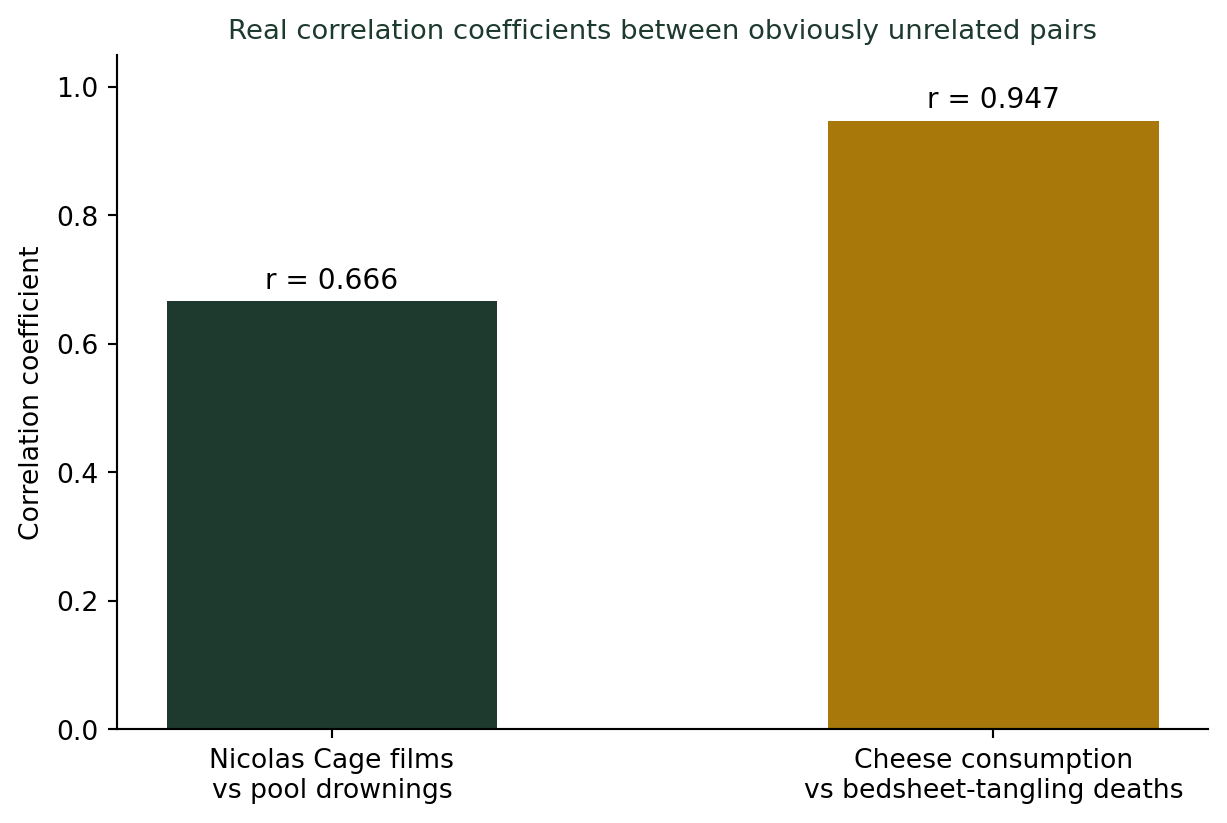
1999~2009년 미국에서 니콜라스 케이지가 출연한 영화 편수와 수영장 익사 사고 수의 상관계수는 0.666이다. 같은 기간 1인당 치즈 소비량과 침대시트에 엉켜 사망한 사람 수의 상관계수는 0.947이다. 둘 다 실제로 계산된 진짜 숫자다. 두 사건이 아무 관계가 없어도 상관계수가 이렇게까지 높게 나올 수 있는 이유를 직접 시뮬레이션으로 확인한다.
Author

권세혁

Published

September 18, 2026

니콜라스 케이지와 익사 사고, 치즈와 침대시트

통계학자 타일러 비건(Tyler Vigen)이 정리해 유명해진 사례가 있다. 1999년부터 2009년까지, 배우 니콜라스 케이지가 그해 출연한 영화 편수와 미국에서 수영장에 빠져 익사한 사람 수 사이의 상관계수는 0.666이다. 같은 기간 미국의 1인당 치즈 소비량과, 침대시트에 몸이 엉켜 사망한 사람 수 사이의 상관계수는 0.947에 달한다. 두 쌍 모두 실제로 존재하는 공개 데이터로 계산된 진짜 숫자다. 그런데 니콜라스 케이지의 영화 출연이 누군가를 익사하게 만들었다거나, 치즈를 많이 먹을수록 침대시트에 엉켜 죽을 확률이 올라간다고 믿는 사람은 없을 것이다.

Two real, published correlation coefficients between obviously unrelated things (Tyler Vigen’s ‘Spurious Correlations’ project, US data circa 1999-2009). Both are high enough that, in almost any other context, a researcher might be tempted to write a headline about them.

우연히도, 이 정도 상관은 생각보다 흔하다

이런 숫자가 어떻게 나올 수 있는지 직접 확인해보자. 서로 완전히 무관한 두 값이, 그저 해마다 오르내리기만 하는 시계열 자료라면 — 즉 “니콜라스 케이지 영화 편수”와 “익사 사고 수”처럼 해마다 등락하는 숫자 두 개를 아무 관계 없이 무작위로 만들어낸다면 — 상관계수는 얼마나 자주 이렇게 높게 나올까?
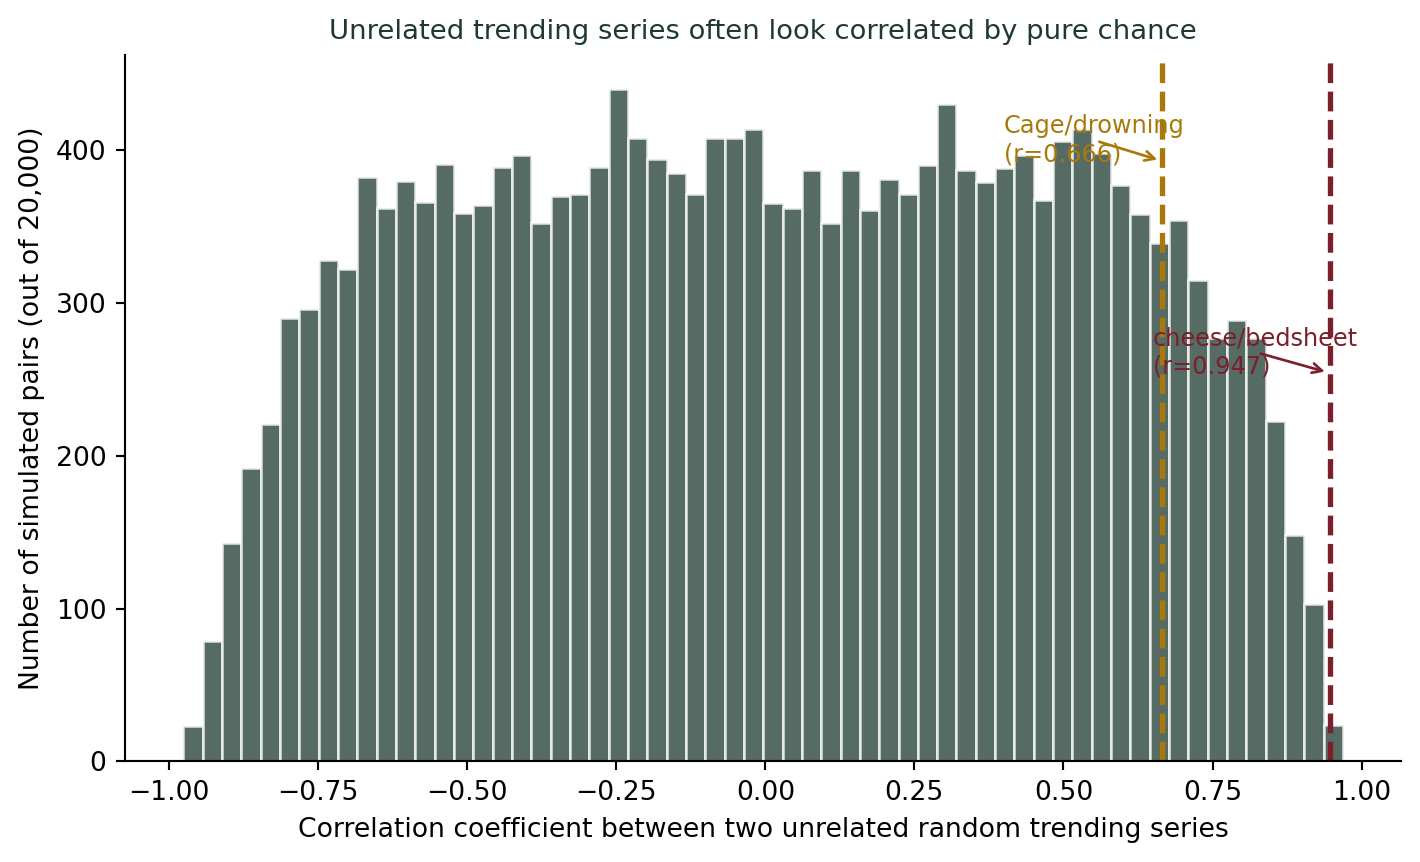
The distribution of correlation coefficients between 20,000 pairs of completely independent random-walk time series (24 points each, mimicking two unrelated year-by-year trending statistics). Even with zero real relationship, about 22% of random pairs exceed the Nicolas Cage/drowning correlation (0.666), and about 1.4% exceed the cheese/bedsheet correlation (0.947) - purely by chance.

시뮬레이션 결과, 아무 관계 없는 두 시계열 사이에서도 상관계수 0.666 이상이 나올 확률은 약 22%, 0.947 이상이 나올 확률도 약 1.4%였다. 완전히 우연으로도 드물지 않게 나올 수 있는 숫자라는 뜻이다. 이유는 단순하다 — 두 값이 서로 무관하더라도, 둘 다 시간이 지나며 오르내리는(트렌드가 있는) 숫자라면, 우연히 같은 방향으로 움직이는 구간이 겹치기 쉽다. 세상에는 해마다 오르내리는 통계가 수천, 수만 개나 있다. 그중 아무 둘이나 짝지어보면, 이 정도로 높은 상관계수를 보이는 쌍은 반드시 몇 개씩 나온다.

상관계수를 볼 때 확인할 것
  1. 상관계수가 높다고 인과관계가 있다는 뜻이 아니다. 오늘 확인했듯, 완전히 무관한 시계열도 우연히 높은 상관을 보일 수 있다.
  2. 두 변수를 이어줄 그럴듯한 메커니즘(경로)이 있는지 먼저 물어라. 메커니즘 없이 숫자만 비슷하게 움직인다면 의심부터 하라.
  3. 비교 대상 쌍이 많을수록, 그중 하나쯤은 우연히 높은 상관을 보이기 마련이다. 수백 개 변수를 모두 짝지어 상관계수를 훑는 방식(데이터 마이닝) 자체가 허위상관을 만들어내는 공장이다.

더 깊이: 상관과 인과를 혼동하는 함정

강의노트 〈기초통계학 3. 통계의 이해 — 확률 해석의 함정〉이 정리한 “통계 해석의 주요 함정” 표는 이 문제를 정확히 짚는다: “상관 vs. 인과 혼동 — 함께 움직인다고 인과관계로 오해. 예: 태양 흑점 수와 정당 점유율의 허위상관.” 니콜라스 케이지의 영화 편수와 태양 흑점 수는 소재만 다를 뿐, 통계적으로는 같은 함정이다. 둘 다 “함께 움직인다”는 사실 하나만으로 관계를 지어내려는 유혹이다.

SDV 관점: 상관에서 멈추지 않고 인과로 나아가기

두 변수의 상관계수를 계산하는 일은 요약(기술통계, 1단계)이고, 오늘처럼 그 상관이 우연일 가능성을 시뮬레이션으로 따져보는 건 추론(2단계)을 넘어선 검증이다. 제가 제안하는 SDV(통계적 데이터 가치화)의 관점에서 보면, 상관관계 하나를 발견하는 것과 그것을 결정의 근거로 쓰는 것 사이에는 큰 간극이 있다. 실제로 가치 있는 통계 작업은 상관계수를 보고 “관계가 있다”고 서둘러 결론짓는 게 아니라, 메커니즘을 확인하고, 무작위 대조(실험이나 자연실험)로 인과를 검증한 뒤에야 정책이나 투자 같은 실제 결정에 반영하는 것이다. AI는 수천 개 변수 쌍의 상관계수를 순식간에 계산해 보여줄 수 있다. 그럴수록 통계학자의 역할은 계산이 아니라, 그 상관 중 어느 것이 진짜 가치 있는 인과적 통찰인지 가려내는 것이다. (SDV(데이터 가치화))

결론: 챕터 1을 마치며 — 숫자 다음엔 항상 질문이 있다

이 시리즈의 첫 챕터, “숫자를 대표하는 방법”에서 시작해 오늘 “공식 통계 숫자 읽는 법”까지, 8주 40편 동안 우리는 같은 메시지를 여러 각도에서 반복해왔다. 평균도, 비율도, 순위도, 상관계수도 — 숫자 하나만으로는 이야기가 끝나지 않는다. 그 숫자가 무엇을 요약했는지, 무엇을 감췄는지, 우연이었는지 필연이었는지를 물어야 비로소 숫자가 쓸모 있어진다. 다음 챕터부터는 “확률과 우연의 세계”로 들어가, 이 질문들을 조금 더 정교한 도구로 다뤄볼 것이다.

참고 자료
  • Tyler Vigen, Spurious Correlations — tylervigen.com/spurious-correlations
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08