권세혁HOME
  • about & me
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • AI_플랫폼(주식 매수 점수)
  • 유튜브
  1. 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음

목차

  • 치명률이 24배 낮아졌다, 바이러스가 약해진 걸까
  • 분모(확진자)가 분자(사망자)보다 훨씬 더 크게 움직였다
  • 더 깊이: 치명률도 결국 상대빈도다
  • SDV 관점: 분모를 못 박아야 비교가 가치를 갖는다
  • 결론: 비율은 분모를 함께 봐야 완성된다

(공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법

통계기초
기술통계
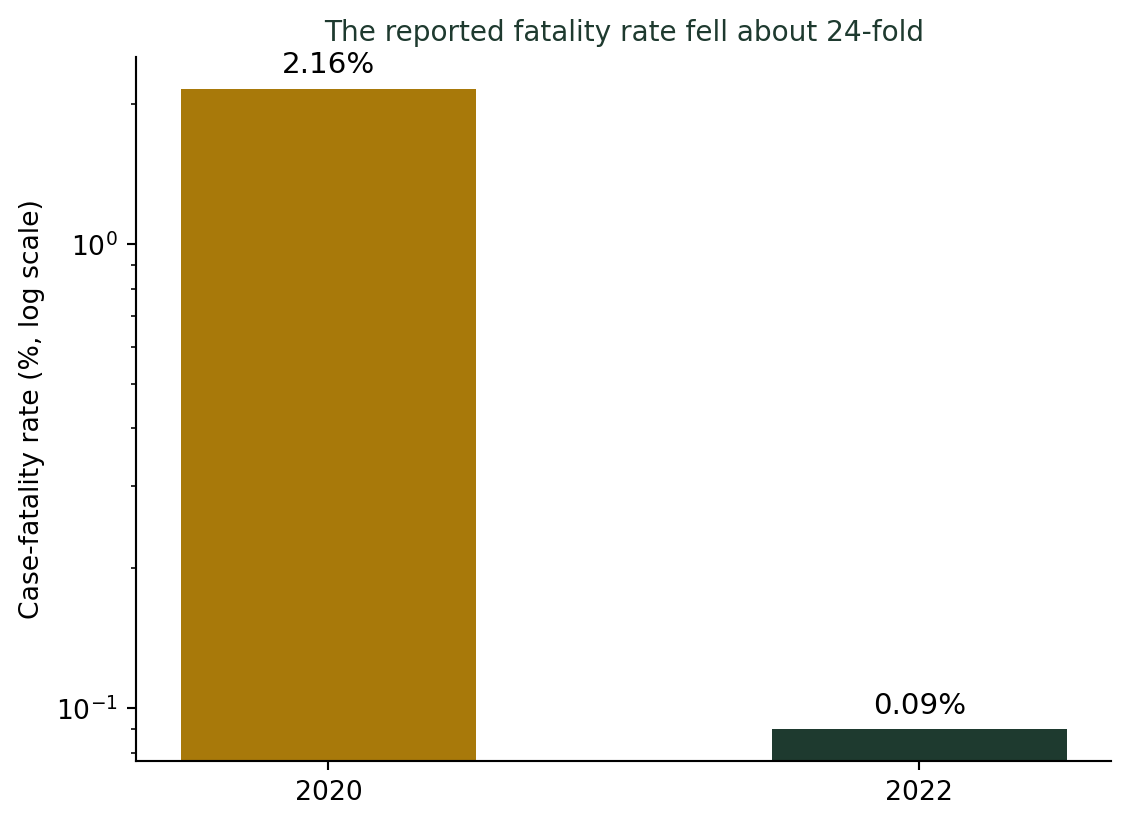
2020년 한국의 코로나19 치명률은 2.16%였다. 2022년에는 0.09%로 24배 낮아졌다. 바이러스가 약해진 걸까? 그사이 확진자 수(치명률의 분모)는 6만 명에서 2,842만 명으로 470배 늘었다. 사망자도 늘긴 했지만 20배였다. 분자보다 분모가 훨씬 더 크게 움직이면, 비율은 이렇게 거꾸로 뒤집힐 수 있다.
Author

권세혁

Published

September 17, 2026

치명률이 24배 낮아졌다, 바이러스가 약해진 걸까

코로나19 국내 발생 첫해인 2020년, 한국의 연간 치명률(사망자÷확진자×100)은 2.16%였다. 그런데 오미크론이 우세종이 된 2022년, 치명률은 0.09%로 떨어졌다. 24배 가까이 낮아진 셈이다. 이 숫자만 보면 “바이러스가 2년 사이 훨씬 약해졌다”고 결론짓기 쉽다. 그런데 같은 기간 사망자 수 자체는 오히려 늘었다 — 2020년 1,313명에서 2022년 25,915명으로, 약 20배 증가했다. 사망자는 늘었는데 치명률은 급락했다. 어떻게 이런 일이 가능할까?

South Korea’s annual COVID-19 case-fatality rate (deaths / confirmed cases), 2020 versus 2022, on a log scale. The rate dropped roughly 24-fold - but this alone doesn’t tell you whether the virus itself changed.

분모(확진자)가 분자(사망자)보다 훨씬 더 크게 움직였다

답은 분모에 있다. 2020년, 한국의 진단검사 역량은 지금과 비교가 안 될 만큼 제한적이었다. 증상이 뚜렷하거나 역학적으로 의심되는 사람 위주로만 검사가 이뤄졌고, 그해 전체 확진자는 60,722명이었다. 2022년에는 오미크론의 폭발적 확산과 함께 신속항원검사·자가검사키트가 전국에 보급되면서, 무증상이나 경증까지 포함해 그해에만 2,842만 명이 확진 판정을 받았다. 확진자 수(분모)가 약 470배 늘어난 것이다.
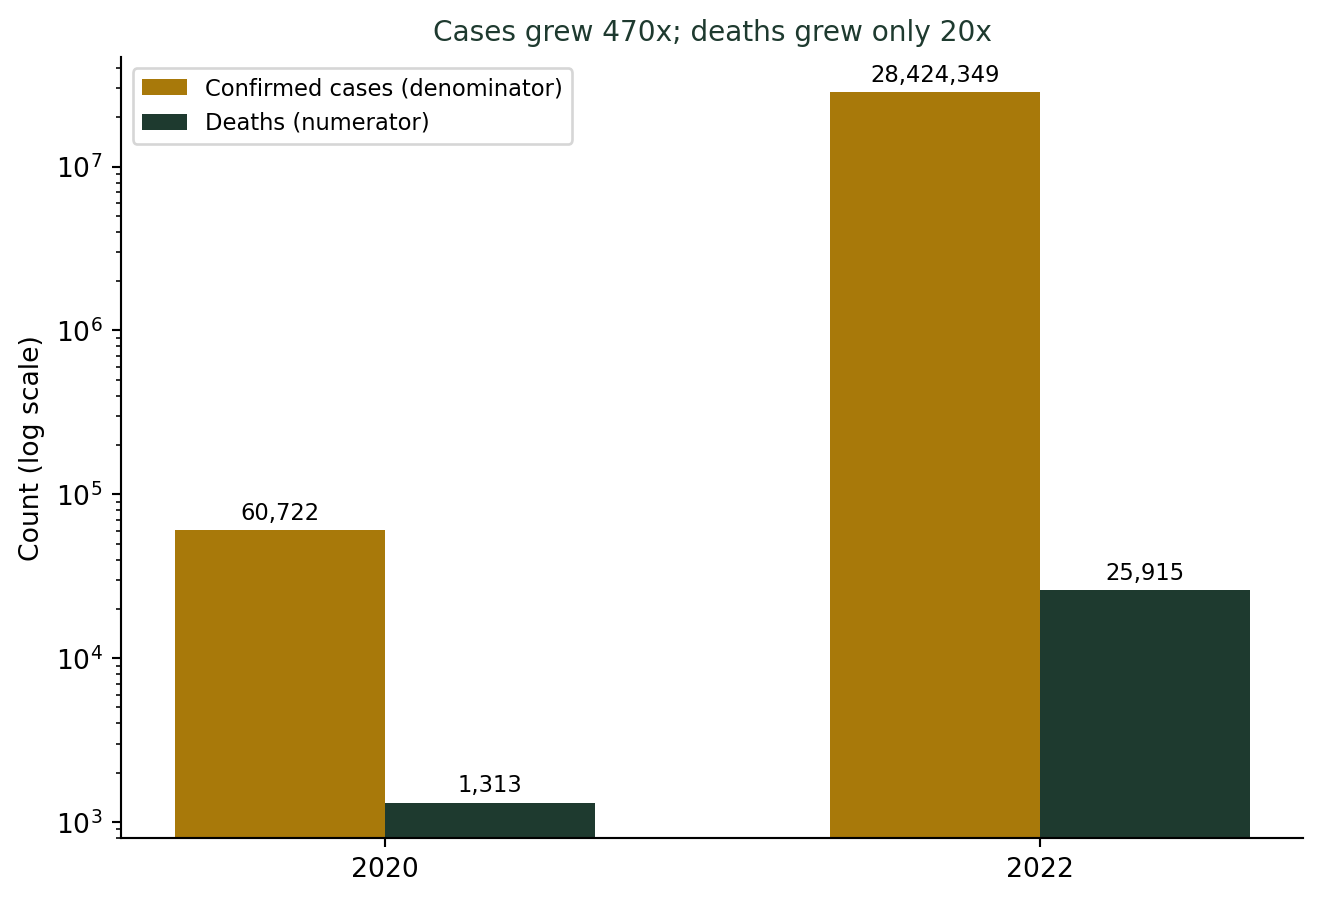
Confirmed cases (the denominator of CFR) grew about 470-fold from 2020 to 2022, while deaths (the numerator) grew about 20-fold over the same period, both on a log scale. When the denominator grows so much faster than the numerator, the ratio (CFR) must fall - even though far more people actually died in 2022 than in 2020.

분자(사망자)가 20배로 늘어나는 동안 분모(확진자)가 470배로 늘어났으니, 그 비율인 치명률은 곱셈적으로 낮아질 수밖에 없다. 실제로 \(470 / 20 \approx 24\)로, 치명률이 24배 낮아진 것과 정확히 맞아떨어진다. 이건 바이러스의 독성이 24분의 1로 줄었다는 뜻이 아니라, 누가 “확진자”로 집계됐는지가 완전히 달라졌다는 뜻에 훨씬 가깝다.

나라별 비교에서도 똑같은 함정이 있다

2020년 3월, 서울대 보라매병원 이상헌 교수는 당시 한국(0.92%)·미국(1.91%)·일본(2.95%)의 치명률 차이를 두고 “검사를 많이 한 나라일수록 분모가 되는 확진자 수가 많아 치명률이 낮게 보이는 통계적 착시”라고 지적했다. 검사를 적게 한 나라는 중증 환자 위주로만 확진자를 집계하니 분모가 작아 치명률이 높게 보이고, 검사를 많이 한 나라는 경증까지 다 잡히니 분모가 커져 치명률이 낮게 보인다. 나라 간 치명률을 그냥 비교하면, 방역 성과가 아니라 검사 역량의 차이를 재고 있는 셈이 된다.

치명률·발생률 같은 비율을 볼 때 확인할 것
  1. 분모(확진자·전체 인구·응시자 수)가 시점마다, 나라마다 같은 기준으로 집계됐는지 확인하라.
  2. 비율이 크게 변했다면, 분자와 분모 중 어느 쪽이 더 크게 움직였는지 따로 뜯어보라. 오늘처럼 둘 다 늘었는데 비율은 떨어질 수 있다.
  3. “치명률이 낮아졌다”가 “덜 위험해졌다”와 항상 같은 말은 아니다. 실제 위험도를 보려면 비율이 아니라 절대적인 사망자 수·중증화 수도 함께 봐야 한다.

더 깊이: 치명률도 결국 상대빈도다

강의노트 〈수리통계학 1. 확률론 — 상대 빈도(Relative Frequency)〉는 확률을 \(P(A) = \lim_{n \to \infty} f/n\), 즉 전체 시행 \(n\) 중 사건 \(A\)가 일어난 횟수 \(f\)의 비율로 정의한다. 치명률은 정확히 이 구조를 따르는 상대빈도다 — 전체 시행 \(n\)이 “확진 판정을 받은 사람”이고, 사건 \(f\)가 “그중 사망한 사람”이다. 그런데 이 정의가 성립하려면 \(n\)이 무엇을 기준으로 세어졌는지 일관돼야 한다. 검사 기준이 바뀌면 \(n\) 자체가 다른 모집단을 가리키게 되고, 상대빈도로서의 치명률도 더 이상 같은 것을 재지 않는다.

SDV 관점: 분모를 못 박아야 비교가 가치를 갖는다

치명률을 계산해 발표하는 일은 요약(기술통계, 1단계)이고, 오늘처럼 연도별·국가별 분모 차이를 파헤쳐 착시를 걷어내는 건 추론(2단계)이다. 제가 제안하는 SDV(통계적 데이터 가치화) 관점에서는, 이 숫자가 실제 결정에 쓰이려면 한 걸음 더 나아가야 한다. 병상 배정, 백신 우선순위, 방역 단계 조정 같은 결정은 해마다 검사 기준이 바뀌는 “치명률”이 아니라, 검사 여부와 무관하게 추정하는 인구 10만 명당 사망자 수(초과사망 포함) 같은, 분모가 고정된 지표를 근거로 삼아야 한다. AI는 이런 여러 지표를 순식간에 계산해 나열해줄 수 있다. 통계학자의 일은 그중 어떤 지표가 지금 이 결정에 진짜 가치 있는 근거인지 설계하는 것이다. (about SDV & me)

결론: 비율은 분모를 함께 봐야 완성된다

나는 학생들에게 치명률·실업률·합격률처럼 “몇 분의 몇”으로 계산되는 통계를 볼 때마다 분자보다 분모를 먼저 확인하라고 말한다. 분모가 시점마다, 집단마다 다르게 정의됐다면, 그 비율을 나란히 놓고 비교하는 것 자체가 이미 오해의 시작이다. 코로나19 치명률의 극적인 하락은 방역의 성공 이야기이기도 하지만, 동시에 “같은 이름의 통계가 사실은 매번 다른 것을 재고 있었다”는 이야기이기도 하다.

참고 자료
  • Characteristics and Trends of COVID-19 Outbreak in Korea — PMC
  • 코로나19 사망률 논란, 통계의 함정 — 이데일리


방문자 수 since 2026.08.08