권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • AI_플랫폼(주식 매수 점수)
  • 유튜브
  1. 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회

목차

  • “지난주 번호가 또 나왔다”는 뉴스는 사실 뉴스거리가 아니다
  • 매 회차는 독립이다 — 그런데 독립이 “달라야 한다”는 뜻은 아니다
  • 더 깊이: 독립의 정의와 곱셈 규칙
  • SDV 관점: “패턴처럼 보인다”를 확률로 검증하는 습관
  • 결론: 겹치는 게 이상한 게 아니라, 안 겹치는 걸 기대하는 게 이상하다

(확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건

통계기초
확률
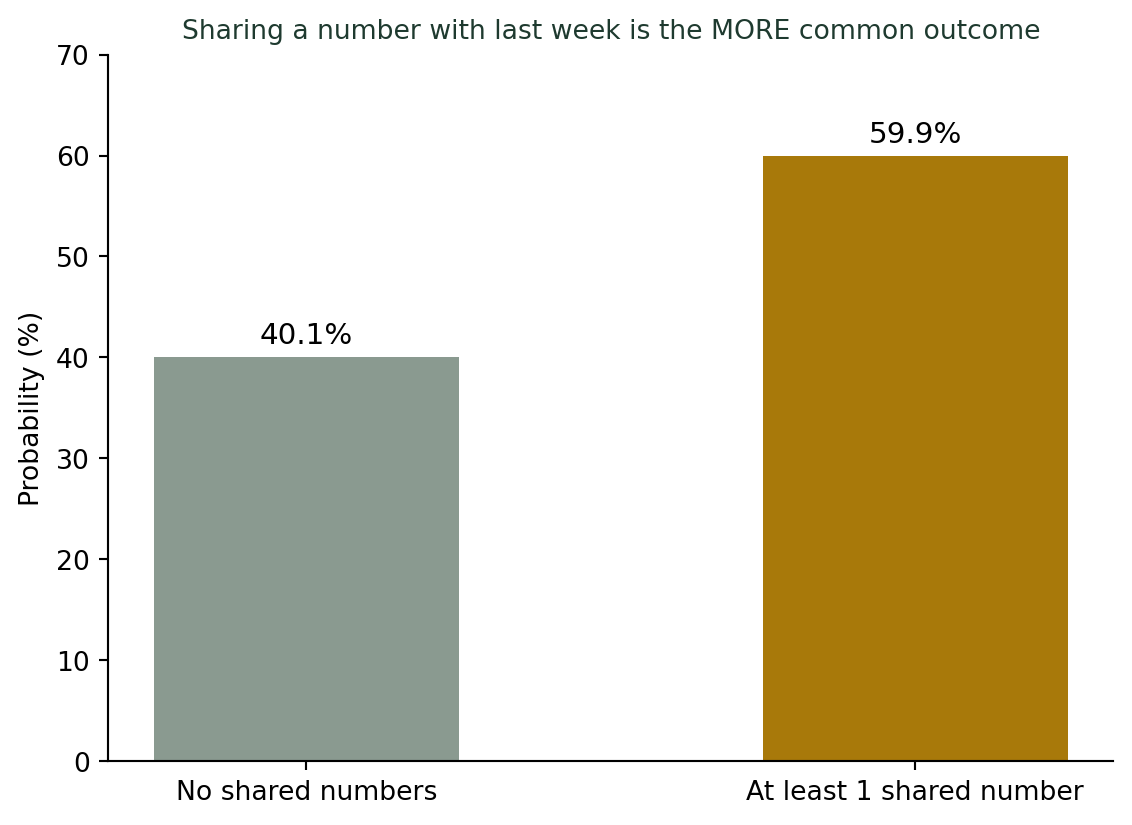
로또에서 지난주 나온 번호가 이번 주에 또 나오면 ’조작 아니냐’는 댓글이 꼭 달린다. 그런데 계산해보면, 지난 회차 6개 번호 중 적어도 하나가 이번 회차에도 나올 확률은 약 60%다. 2주에 1주 이상은 번호가 겹치는 게 오히려 정상이라는 뜻이다. 매 회차가 서로 독립이라는 사실이 왜 ’겹치지 않아야 한다’는 뜻이 아닌지 살펴본다.
Author

권세혁

Published

September 22, 2026

“지난주 번호가 또 나왔다”는 뉴스는 사실 뉴스거리가 아니다

로또 추첨 결과가 발표될 때마다 인터넷에는 비슷한 댓글이 달린다. “어? 이 번호 지난주에도 나왔던 건데?”, “이거 설계된 거 아니야?” 그런데 실제로 계산해보면, 지난 회차에 나온 6개 번호 중 적어도 하나가 이번 회차에도 나올 확률은 약 60%다. 2주 중 1주 이상은 번호가 겹치는 게 오히려 통계적으로 자연스러운 결과라는 뜻이다.

The probability that this week’s 6 lotto numbers (drawn from 1-45) share at least one number with last week’s 6, versus sharing none, computed exactly using combinations. Sharing at least one number is actually the more likely outcome.

매 회차는 독립이다 — 그런데 독립이 “달라야 한다”는 뜻은 아니다

로또 추첨기는 매주 45개의 공을 처음부터 다시 채워 넣고 돌린다. 지난주에 나온 공이 이번 주에 제외되는 일은 없다. 이렇게 한 사건(이번 주 추첨)의 결과가 다른 사건(지난주 추첨)의 결과에 전혀 영향을 받지 않을 때, 두 사건을 독립(independent)이라 한다. 그런데 여기서 흔한 오해가 생긴다 — 많은 사람이 “독립적이다”를 “서로 달라야 한다”로 잘못 받아들인다. 사실은 정반대다. 독립적이라는 건 지난주 결과가 이번 주 결과에 아무 제약도 주지 않는다는 뜻이지, 겹치지 않도록 조정된다는 뜻이 아니다. 오히려 아무 제약이 없기 때문에, 순전한 우연만으로도 번호가 겹칠 여지가 그대로 남아 있다.
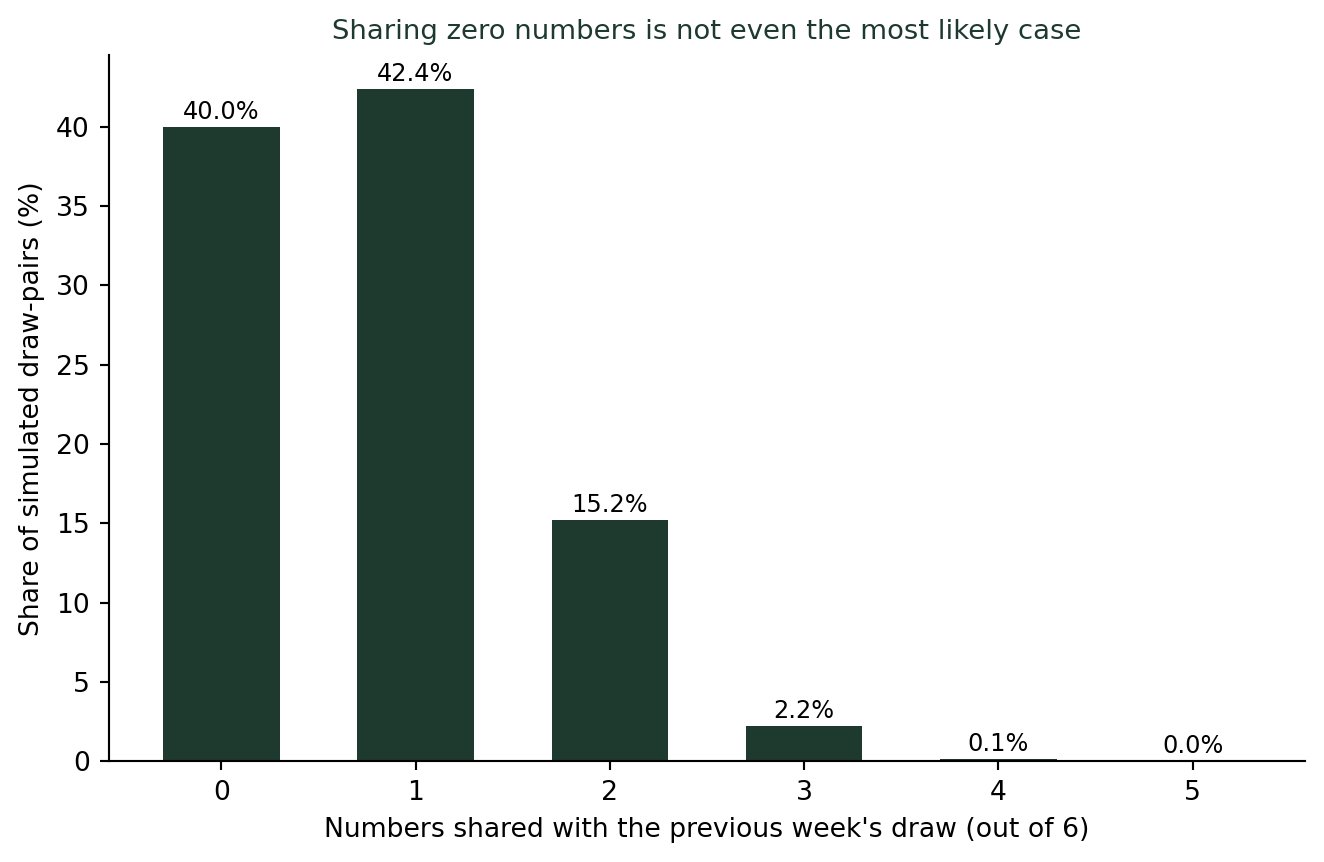
A simulation of 200,000 pairs of consecutive lotto draws: how many numbers (out of 6) are shared between one week and the next. Sharing exactly one number is actually the single most common outcome (about 42%), more common than sharing none at all (40%).

시뮬레이션 결과, 번호가 하나도 안 겹치는 경우는 40%, 정확히 1개 겹치는 경우가 42%로 오히려 더 흔하다. 2개 이상 겹치는 경우도 17.6%나 된다. 이런 겹침을 “조작의 증거”로 의심하려면, 1년(52회차) 중 절반 가까운 주에서 “조작 의혹”을 제기해야 한다는 뜻이다 — 그 자체로 이미 앞뒤가 맞지 않는다.

독립사건과 “우연의 반복”을 구분하는 법
  1. “독립”은 “달라야 한다”가 아니라 “서로 영향을 안 준다”는 뜻이다. 독립적인 사건도 우연히 같은 결과를 낼 수 있다.
  2. 반복되는 패턴을 보면, 그 패턴이 나올 수 있는 경우의 수를 먼저 세어보라. 오늘처럼 계산해보면 “예외적인 우연”이 사실은 “가장 흔한 결과”인 경우가 많다.
  3. 매 시행이 정말 독립인지부터 확인하라. 로또처럼 공을 매번 새로 채우는 게임은 독립이지만, 카드 게임처럼 이미 뽑힌 패를 빼고 진행하는 경우는 독립이 아니다.

더 깊이: 독립의 정의와 곱셈 규칙

강의노트 〈수리통계학 1. 확률론 — 독립〉은 두 사건 \(A\)와 \(B\)가 독립이면 \(P(A \cap B) = P(A) \cdot P(B)\)가 성립한다고 정의하고, 상호 배타적(mutually exclusive)인 사건과 독립사건을 혼동하면 안 된다는 예제도 함께 다룬다 — 두 사건이 동시에 일어날 수 없는 것(상호 배타)과, 두 사건이 서로 영향을 주지 않는 것(독립)은 전혀 다른 개념이다. 로또의 이번 주 추첨과 지난주 추첨은 상호 배타적이지 않다(둘 다 일어날 수 있다는 것 자체가 당연하다) — 그리고 독립이다(서로 영향을 안 준다). 이 두 성질이 합쳐지면, 오늘 계산한 것처럼 “번호가 겹칠 확률”을 곱셈 규칙으로 정확히 계산할 수 있다.

SDV 관점: “패턴처럼 보인다”를 확률로 검증하는 습관

두 사건이 독립인지 확인하고 겹칠 확률을 계산하는 일은 요약과 추론(1~2단계)에 해당하는 고전적 확률 계산이다. 제가 제안하는 SDV(통계적 데이터 가치화) 관점에서 이 계산이 갖는 가치는 실전에 있다. 품질관리에서 “같은 불량이 이번 달에도 반복됐다”, 마케팅에서 “이 고객군이 지난달과 또 겹친다”처럼, 업무 현장에서는 “반복”을 곧장 “이상 신호”로 해석하는 경우가 흔하다. 그런데 그 반복이 정말 이례적인지, 아니면 오늘 로또 사례처럼 독립적인 과정에서도 자연스럽게 나오는 흔한 결과인지를 먼저 계산해보지 않으면, 있지도 않은 원인을 찾아 헤매느라 자원을 낭비하게 된다. 데이터를 가치로 바꾸는 첫 단계는 종종, 그 데이터가 “설명이 필요한 이상 신호”인지 “설명이 필요 없는 정상 변동”인지를 가려내는 것이다. (SDV(데이터 가치화))

결론: 겹치는 게 이상한 게 아니라, 안 겹치는 걸 기대하는 게 이상하다

나는 학생들에게 “이런 우연이?”라는 반응이 나오면, 그 우연이 나올 수 있는 경우의 수를 직접 세어보라고 말한다. 지난주와 이번 주 로또 번호가 하나라도 겹칠 조합은 생각보다 훨씬 많다. 매주 반복되는 추첨이 서로 독립이라는 사실은, 번호가 겹치지 않게 막아주는 장치가 아니라 오히려 겹칠 여지를 그대로 열어두는 조건이다. 독립사건 앞에서는, 반복이야말로 기본값이다.


방문자 수 since 2026.08.08