(확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
통계기초
확률
한 반에 학생이 23명만 모여도, 그중 두 사람의 생일이 같을 확률은 50%를 넘는다. 365개의 날짜 중 겹칠 확률이 이렇게 높다니 믿기지 않는다면, 그건 질문을 잘못 이해했기 때문이다. 이번 학기 새로 시작하는 ‘확률과 우연의 세계’ 챕터를, 확률론에서 가장 유명한 이 퍼즐로 열어본다.
23명, 반이 다 모이기도 전에 생일이 겹친다
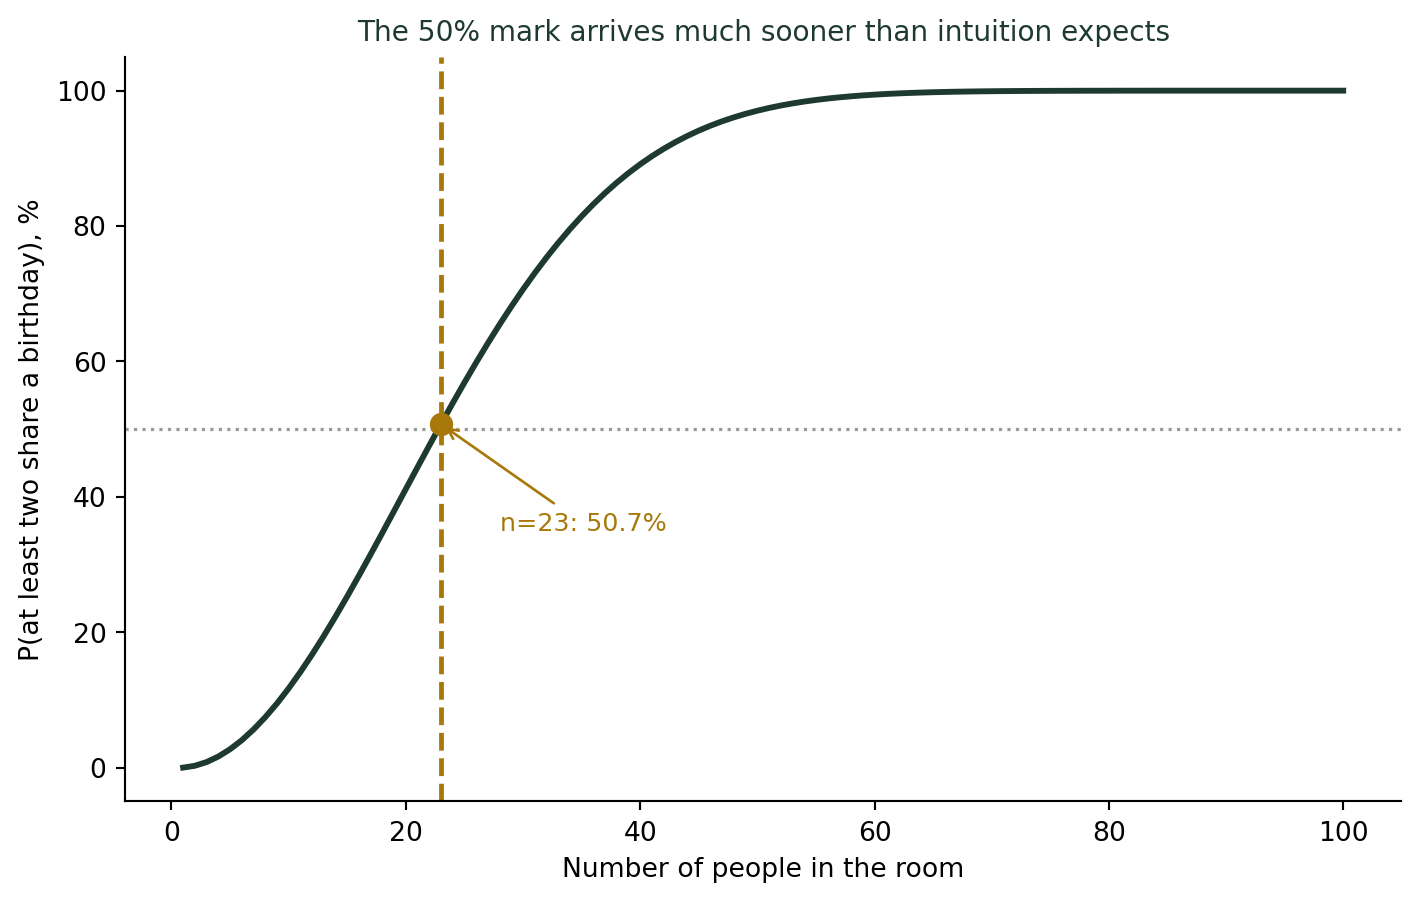
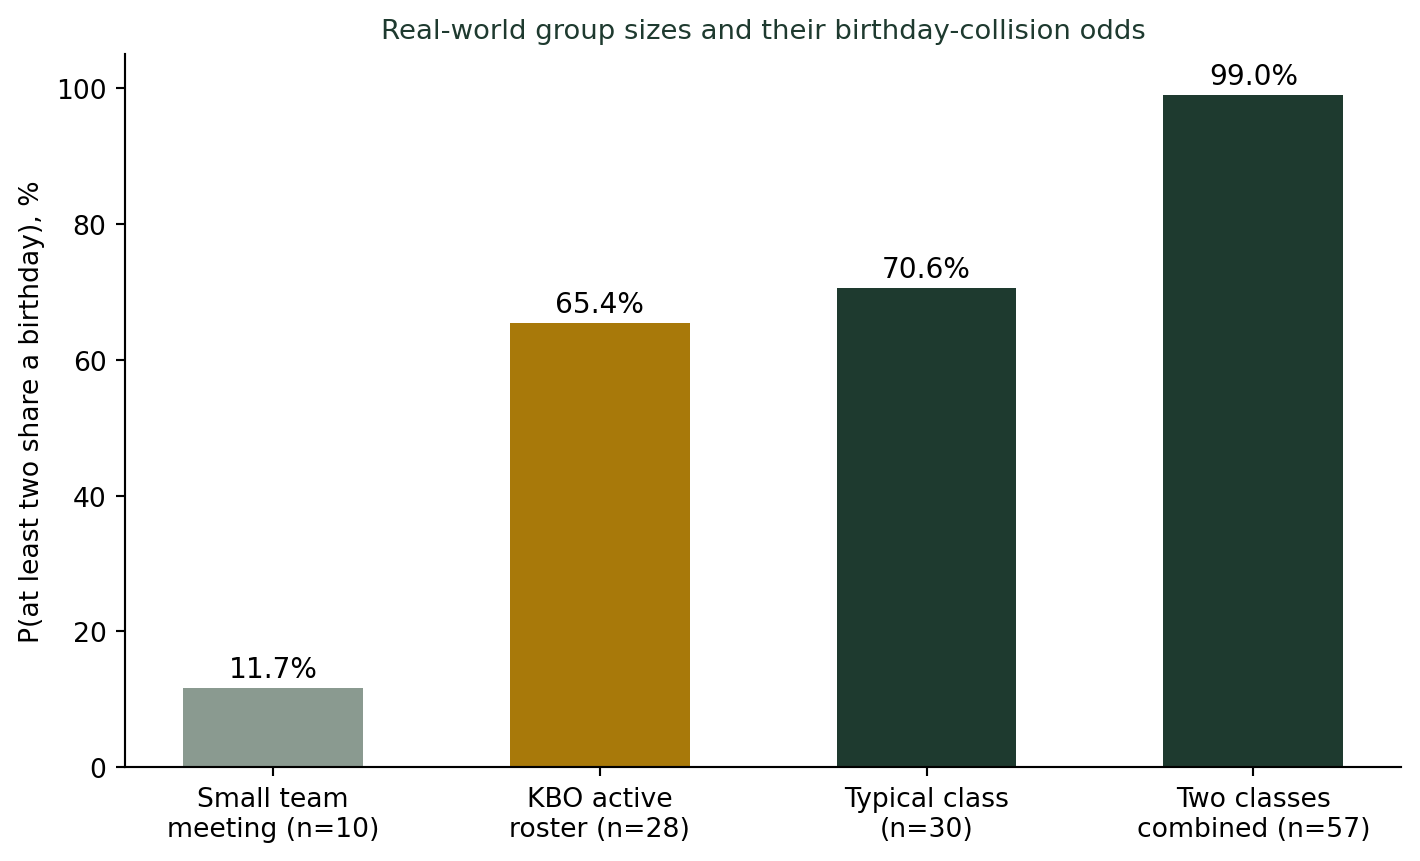
새 학기, 새로운 반 학생들과 처음 만나는 자리에서 나는 종종 이 질문을 던진다. “이 교실에 몇 명이 있어야, 그중 두 사람의 생일이 같을 확률이 50%를 넘을까요?” 대부분의 학생들은 365일의 절반쯤인 180명 안팎을 답한다. 정답은 23명이다. 학생 23명만 모여도, 그중 생일이 겹치는 두 사람이 있을 확률이 이미 50%를 넘는다. 반 정원이 28~30명이라면 그 확률은 65~70%까지 올라간다 — 대부분의 교실에서 생일이 겹치는 학생이 있다는 뜻이다. 직관과 정면으로 충돌하는 이 결과를 생일 문제(birthday problem)라 부른다.
질문을 잘못 알아들으면 답이 틀린다
이 결과가 이상하게 느껴지는 이유는, 많은 사람이 이 질문을 “나와 생일이 같은 사람이 있을 확률”로 잘못 알아듣기 때문이다. 나 한 사람 기준으로 22명 중 누군가와 생일이 같을 확률은 \(22/365 \approx 6\%\)로 낮은 게 맞다. 그런데 실제 질문은 “23명 중 아무 두 사람이든 생일이 같을 확률”이다. 23명이면 두 사람씩 짝지을 수 있는 경우의 수가 \(\binom{23}{2} = 253\)쌍이나 된다. 253번의 “혹시 겹칠까” 기회가 있는 셈이니, 그중 하나라도 겹칠 확률은 훨씬 커진다.
계산 방법은 정면 돌파보다 뒤에서 접근하는 쪽이 훨씬 쉽다. “적어도 한 쌍이 겹칠 확률”을 직접 구하는 대신, “아무도 안 겹칠 확률”을 구해서 1에서 빼는 것이다. 첫 사람의 생일은 365일 중 아무 날이나 상관없다. 두 번째 사람이 첫 사람과 겹치지 않을 확률은 \(364/365\), 세 번째 사람이 앞의 둘과 겹치지 않을 확률은 \(363/365\), 이런 식으로 23번째 사람까지 곱해나간다. 이 곱은 사람이 늘어날수록 급격히 작아지고, 그만큼 “적어도 한 쌍은 겹친다”는 확률(1에서 그 값을 뺀 것)은 빠르게 커진다.
생일 문제를 마주하면 기억할 것
- “나와 겹칠 확률”과 “그룹 안 아무 두 사람이 겹칠 확률”은 완전히 다른 질문이다. 후자는 비교 대상 쌍의 수가 인원수의 제곱에 가깝게 늘어나 훨씬 빨리 커진다.
- “적어도 하나”를 구할 땐 반대(여사건)를 먼저 구하라. “아무도 안 겹칠 확률”을 구해 1에서 빼는 쪽이 훨씬 계산하기 쉽다.
- 작은 표본에서 “이런 우연이?”라고 놀라기 전에, 비교 가능한 쌍이 몇 개나 있는지부터 세어보라. 우연처럼 보이는 많은 사건이, 사실은 비교 기회가 많아서 생긴 자연스러운 결과다.
더 깊이: 여사건으로 “적어도 하나”를 계산하는 법
강의노트 〈수리통계학 1. 확률론 — 독립〉은 확률 계산의 정리로 \(P(A^c) = 1 - P(A)\)를 제시하고, 17세기 도박사 슈발리에 드 메레(Chevalier de Méré)의 사례를 든다 — 주사위를 4번 던져 6이 한 번이라도 나올 확률은 \(1-(5/6)^4\)로, “한 번도 안 나올 확률”을 구해 1에서 빼서 계산한다. 오늘 계산한 생일 문제도 정확히 같은 틀이다. \(n\)명의 생일이 서로 독립이라고 가정한 뒤(한 사람의 생일이 다른 사람의 생일에 영향을 주지 않으므로), “아무도 안 겹칠 확률”을 각 사람이 앞사람들과 다른 날짜를 가질 확률의 곱으로 구하고, 1에서 뺀다. 독립사건의 곱셈 규칙과 여사건의 뺄셈 규칙, 이 두 가지 도구만으로 반직관적인 결과가 깔끔하게 풀린다.
SDV 관점: “말도 안 되는 우연”을 계산 가능한 확률로 바꾸기
생일 문제의 확률을 계산하는 일 자체는 요약과 추론(1~2단계)을 오가는 고전적인 확률 계산이다. 그런데 제가 제안하는 SDV(통계적 데이터 가치화) 관점에서 이 문제가 흥미로운 이유는 따로 있다. 사람들은 “말도 안 되는 우연이 일어났다”는 이야기를 사실로 믿고 의사결정에 반영하는 경우가 많다 — 이상 거래 탐지, 품질 관리에서의 “우연히 같은 결함이 반복됐다”는 보고, 의료 데이터에서 “같은 부작용이 겹쳤다”는 경보가 그 예다. 그런 사건이 정말 이례적인지, 아니면 애초에 비교 대상 쌍이 많아서 나올 법한 결과인지를 생일 문제의 틀로 먼저 계산해보는 것 — 이것이 “놀랍다”는 직관을 “그럴 확률이 얼마다”라는 숫자로 바꾸는, 데이터를 가치 있는 판단으로 이어주는 첫걸음이다. (SDV(데이터 가치화))
결론: 새 챕터, “우연”이라는 말을 계산해보는 시간
이번 챕터에서는 “확률과 우연의 세계”를 다룬다. 생일 문제는 그 출발점으로 손색이 없다 — 우리의 직관이 확률 앞에서 얼마나 쉽게 틀리는지, 그리고 그 직관을 바로잡는 데 복잡한 도구가 아니라 여사건과 독립이라는 단 두 가지 개념이면 충분하다는 것을 동시에 보여주기 때문이다. 다음에 “이런 우연이 있을 수 있나”라는 생각이 들면, 먼저 “비교할 수 있는 쌍이 몇 개나 있었지?”를 물어보자.