권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • AI_플랫폼(주식 매수 점수)
  • 유튜브
  1. 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회

목차

  • 48번 당첨된 편의점, 정말 “명당”일까
  • 답은 운이 아니라 “판매량”이다
  • 매주 1억 건 — 당첨자가 매주 나오는 진짜 이유
  • 더 깊이: 동일확률이라는 전제 위에서만 성립하는 이야기
  • SDV 관점: “잘 팔린다”와 “잘 맞는다”를 구분하는 결정
  • 결론: 명당을 찾지 말고, 판매량을 찾아라

(확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향

통계기초
확률
서울 노원구의 한 편의점은 로또 1등을 48회나 배출해 ’명당’으로 불리며 주말마다 줄이 늘어선다. 그런데 로또는 모든 번호 조합이 정확히 같은 확률을 갖도록 설계된 게임이다. ’명당’이 실제로 하는 일은 운을 늘려주는 게 아니라, 그저 표를 많이 팔아 당첨자 수를 늘리는 것뿐이다.
Author

권세혁

Published

September 24, 2026

48번 당첨된 편의점, 정말 “명당”일까

서울 노원구 상계동의 한 편의점은 로또 1등 당첨자를 48회나 배출해 전국 오프라인 판매점 중 최다 기록을 세웠다(2024년 기준). 주말이면 이 가게 앞에 긴 줄이 늘어선다. 다들 이 가게에서 사면 당첨 확률이 더 높다고 믿기 때문이다. 그런데 로또 6/45는 애초에 모든 번호 조합이 정확히 같은 확률(1/8,145,060)을 갖도록 설계된 게임이다. 어느 가게에서 사든, 어떤 요일에 사든, 자동이든 수동이든 확률은 달라지지 않는다. 그렇다면 이 가게는 왜 이렇게 많은 당첨자를 배출했을까?

답은 운이 아니라 “판매량”이다

복권위원회 관계자는 이 현상을 이렇게 설명한다. “구매자가 살 수 있는 번호조합은 814만 개뿐이지만, 이들이 사는 게임 수는 매주 1억 건이 넘는다. 예전에는 100명만 사던 조합을 지금은 1,000명이 구매한다면, 그 조합이 당첨됐을 때 당첨자 수가 많아질 수밖에 없다.” 즉 특정 가게에 당첨자가 몰리는 이유는 그 가게가 “행운의 장소”라서가 아니라, 그 가게가 압도적으로 많은 표를 팔기 때문이다. 표를 많이 팔수록 당첨 조합을 우연히 포함할 확률도 비례해서 커진다 — 이건 신비로운 힘이 아니라 단순한 곱셈이다.

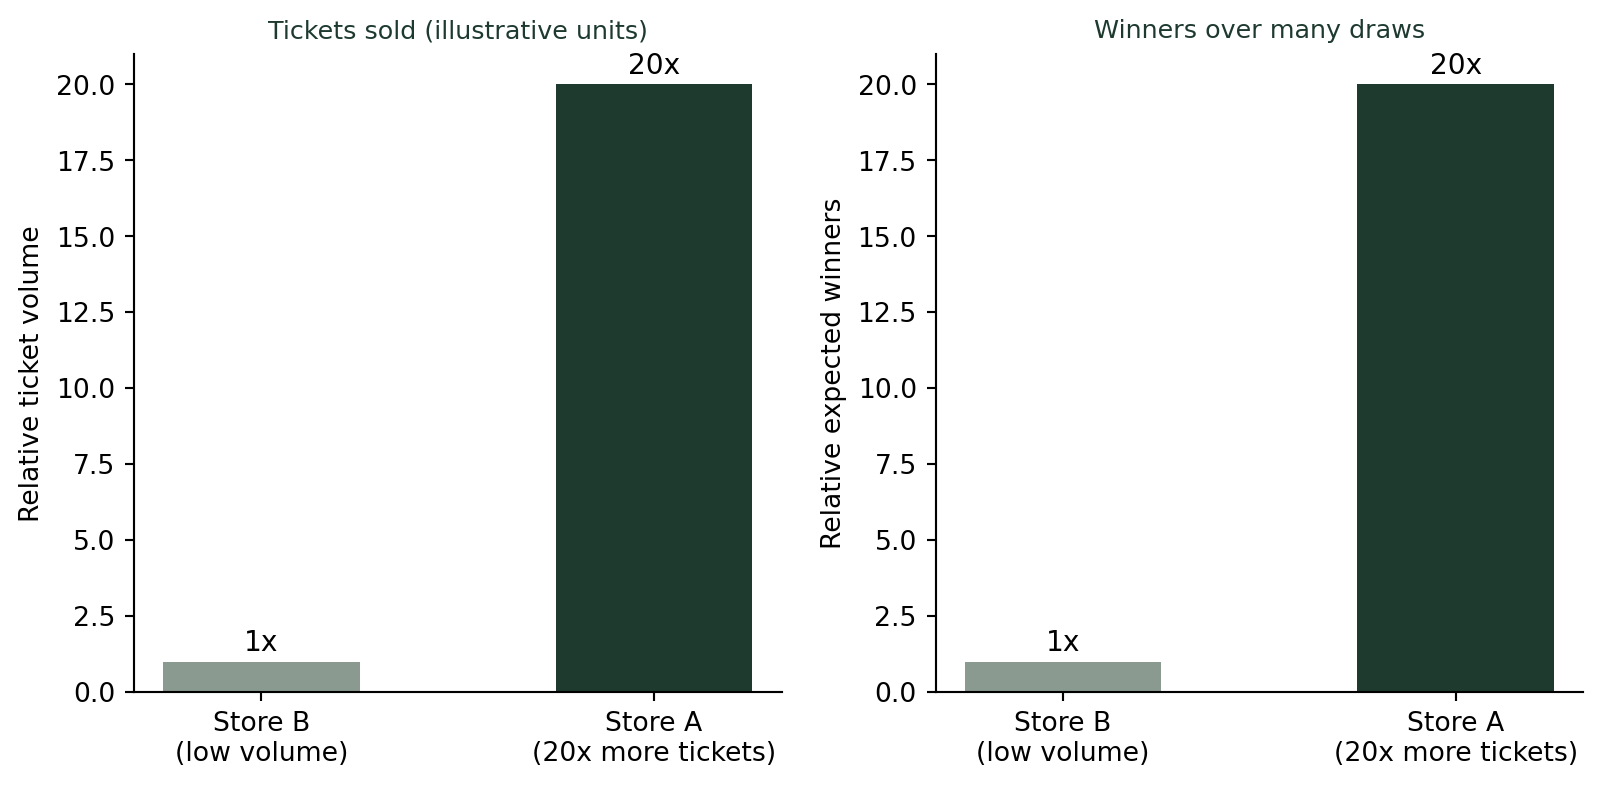
An illustrative example: if Store A sells 20x as many tickets as Store B, and every ticket has the exact same win probability, then over many draws Store A should produce roughly 20x as many winners - purely from volume, with no ‘lucky spot’ effect needed.

가게 하나가 유독 많이 팔리는 데는 실제 이유가 있다 — 대형 상권, 눈에 띄는 위치, 그리고 “명당”이라는 입소문 자체가 손님을 더 끌어모은다. 여기서 선택편향(selection bias)이 개입한다. 사람들은 당첨자가 나온 가게로 몰리고, 그 가게는 판매량이 더 늘어 당첨자가 또 나올 확률도 함께 커진다. 이 자기강화적 순환이 “명당”이라는 이야기를 계속 만들어내지만, 그 가게에서 산 개별 번호 조합의 당첨 확률 자체는 다른 가게에서 산 것과 조금도 다르지 않다.

매주 1억 건 — 당첨자가 매주 나오는 진짜 이유
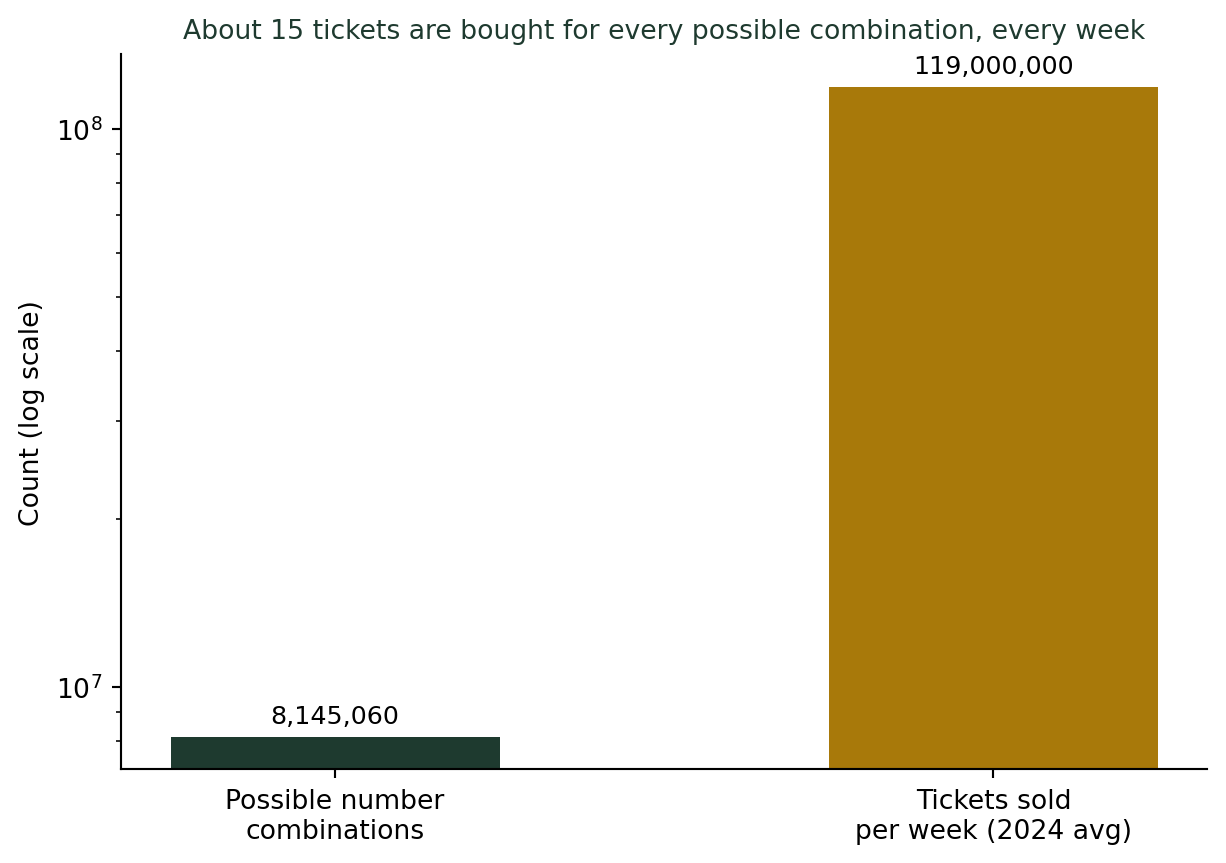
The gap between the number of possible lotto combinations (8,145,060) and the number of tickets actually purchased in a typical week (roughly 119 million, based on 2024’s 6.2001 trillion-won annual sales), on a log scale. With so many tickets chasing so few combinations, having multiple winners in the same draw becomes routine rather than exceptional.

2024년 로또 연간 판매액은 6조 2,001억 원으로 역대 최대였다. 1,000원짜리 게임 기준으로 환산하면 매주 약 1억 1,900만 건이 팔리는 셈이다. 가능한 번호 조합은 814만 5,060개뿐인데, 매주 그보다 약 15배 많은 표가 팔린다. 이러니 1등 당첨 조합 하나에도 평균 여러 명이 동시에 걸리는 게 당연하다. 실제로 2024년 한 해에만 1등 당첨자가 812명 나왔다 — 매주 평균 15명 넘게, 단 한 명도 당첨자가 없었던 주는 드물었다.

“명당” 이야기를 마주하면 확인할 것
  1. “이 조합·장소가 더 잘 당첨된다”는 주장을 보면, 확률 자체가 다른 건지 표본(판매량)이 다른 건지부터 구분하라. 동일확률 게임에서는 후자가 거의 항상 답이다.
  2. 당첨자 수가 많다는 사실만으로는 “왜”를 설명하지 못한다. 판매량 데이터를 함께 보지 않으면 원인을 오해하기 쉽다.
  3. 입소문이 판매량을 늘리고, 늘어난 판매량이 다시 입소문을 만드는 순환을 의심하라. “명당”은 종종 원인이 아니라 결과다.

더 깊이: 동일확률이라는 전제 위에서만 성립하는 이야기

강의노트 〈수리통계학 1. 확률론 — Laplace 확률(고전적 확률)〉은 표본공간의 모든 원소가 일어날 가능성이 같다는 균등가능성(equally likely) 가정 위에서 \(P(A) = |A|/|S|\)로 확률을 정의한다. 로또는 이 정의가 설계 그대로 적용되는 몇 안 되는 실생활 게임이다 — 814만 5,060개의 조합 각각이 정확히 같은 확률을 갖도록 공식적으로 설계돼 있다. 이 전제가 참이라는 걸 받아들이면, “특정 가게·번호가 더 잘 나온다”는 주장은 성립할 수 없다 — 남는 설명은 표본 크기(판매량) 차이뿐이다.

SDV 관점: “잘 팔린다”와 “잘 맞는다”를 구분하는 결정

동일확률 가정을 확인하고 당첨자 수 차이를 판매량으로 설명하는 일은 요약과 추론(1~2단계)의 영역이다. 제가 제안하는 SDV(통계적 데이터 가치화) 관점에서 이 사례가 중요한 이유는, 비슷한 착시가 비즈니스 데이터에서도 똑같이 반복되기 때문이다 — “이 매장이 전환율이 높다”는 보고가, 사실은 매장 운영이 뛰어나서가 아니라 단순히 트래픽(표본)이 커서 나온 결과일 수 있다. 데이터를 가치 있는 결정으로 연결하려면, “성과가 좋다”는 지표를 표본 크기로 나눠 실제 비율(전환율, 적중률)을 확인한 뒤에야 그 매장의 운영 방식을 다른 곳에 복제할지 결정해야 한다. 표본 크기를 무시한 채 “명당”만 좇으면, 정작 복제해야 할 것은 위치가 아니라 마케팅 방식이었을 수 있다. (SDV(데이터 가치화))

결론: 명당을 찾지 말고, 판매량을 찾아라

나는 학생들에게 “명당에서 사면 잘 된다더라”는 말을 들으면 이렇게 되물으라고 말한다. “그 가게가 파는 표 수는 얼마나 되나요?” 로또처럼 동일확률이 수학적으로 보장된 게임에서, 당첨자가 몰리는 곳은 운이 좋은 곳이 아니라 표를 많이 파는 곳이다. 명당이라는 이야기에 홀리기 전에, 그 이야기 뒤에 숨은 표본 크기부터 물어보는 습관이 필요하다.

참고 자료
  • 로또 1등 ’무더기 당첨’으로 확산된 조작설…사실은 이렇다? — 시사저널


방문자 수 since 2026.08.08