권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • AI_플랫폼(주식 매수 점수)
  • 유튜브
  1. 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고

목차

  • 교과서의 종 모양이 세상의 모양은 아니다
  • 네 가지 모양을 나란히 보기
  • 정규분포가 나타나는 조건
  • 정규분포를 가정하기 전에 던질 질문
  • 더 깊이: 정규분포의 정의와 중심극한정리
  • SDV 관점: 분포를 가정하기 전에 분포를 데이터에서 확인하라
  • 결론: 종 모양은 가정이지, 출발점이 아니다

(분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계

통계기초
분포
교과서의 종 모양 곡선은 너무 익숙해서, 세상의 데이터도 다 그럴 거라고 믿기 쉽다. 그러나 대기업 직원의 연봉, 특정 지역의 강수량, 고객이 머문 시간은 대칭이 아니다. 네 가지 분포를 나란히 놓고 정규분포가 언제 맞고 언제 틀리는지 살펴본다.
Author

권세혁

Published

October 12, 2026

교과서의 종 모양이 세상의 모양은 아니다

통계 수업에서 가장 먼저 배우는 그림은 종 모양의 정규분포다. 평균 근처에 데이터가 몰리고 양쪽으로 대칭으로 줄어드는 이 곡선은 너무 익숙해서, 많은 사람이 세상의 모든 데이터가 이 모양일 거라고 생각한다. 시험 점수나 키처럼 여러 요인이 더해져 만들어진 값은 실제로 정규분포에 가깝다. 그런데 회사원의 연봉, 하루 동안 한 사람이 쓰는 돈, 웹사이트 체류 시간은 어떨까? 이런 데이터는 한쪽 꼬리가 길게 늘어진 비대칭 모양인 경우가 많다.

네 가지 모양을 나란히 보기

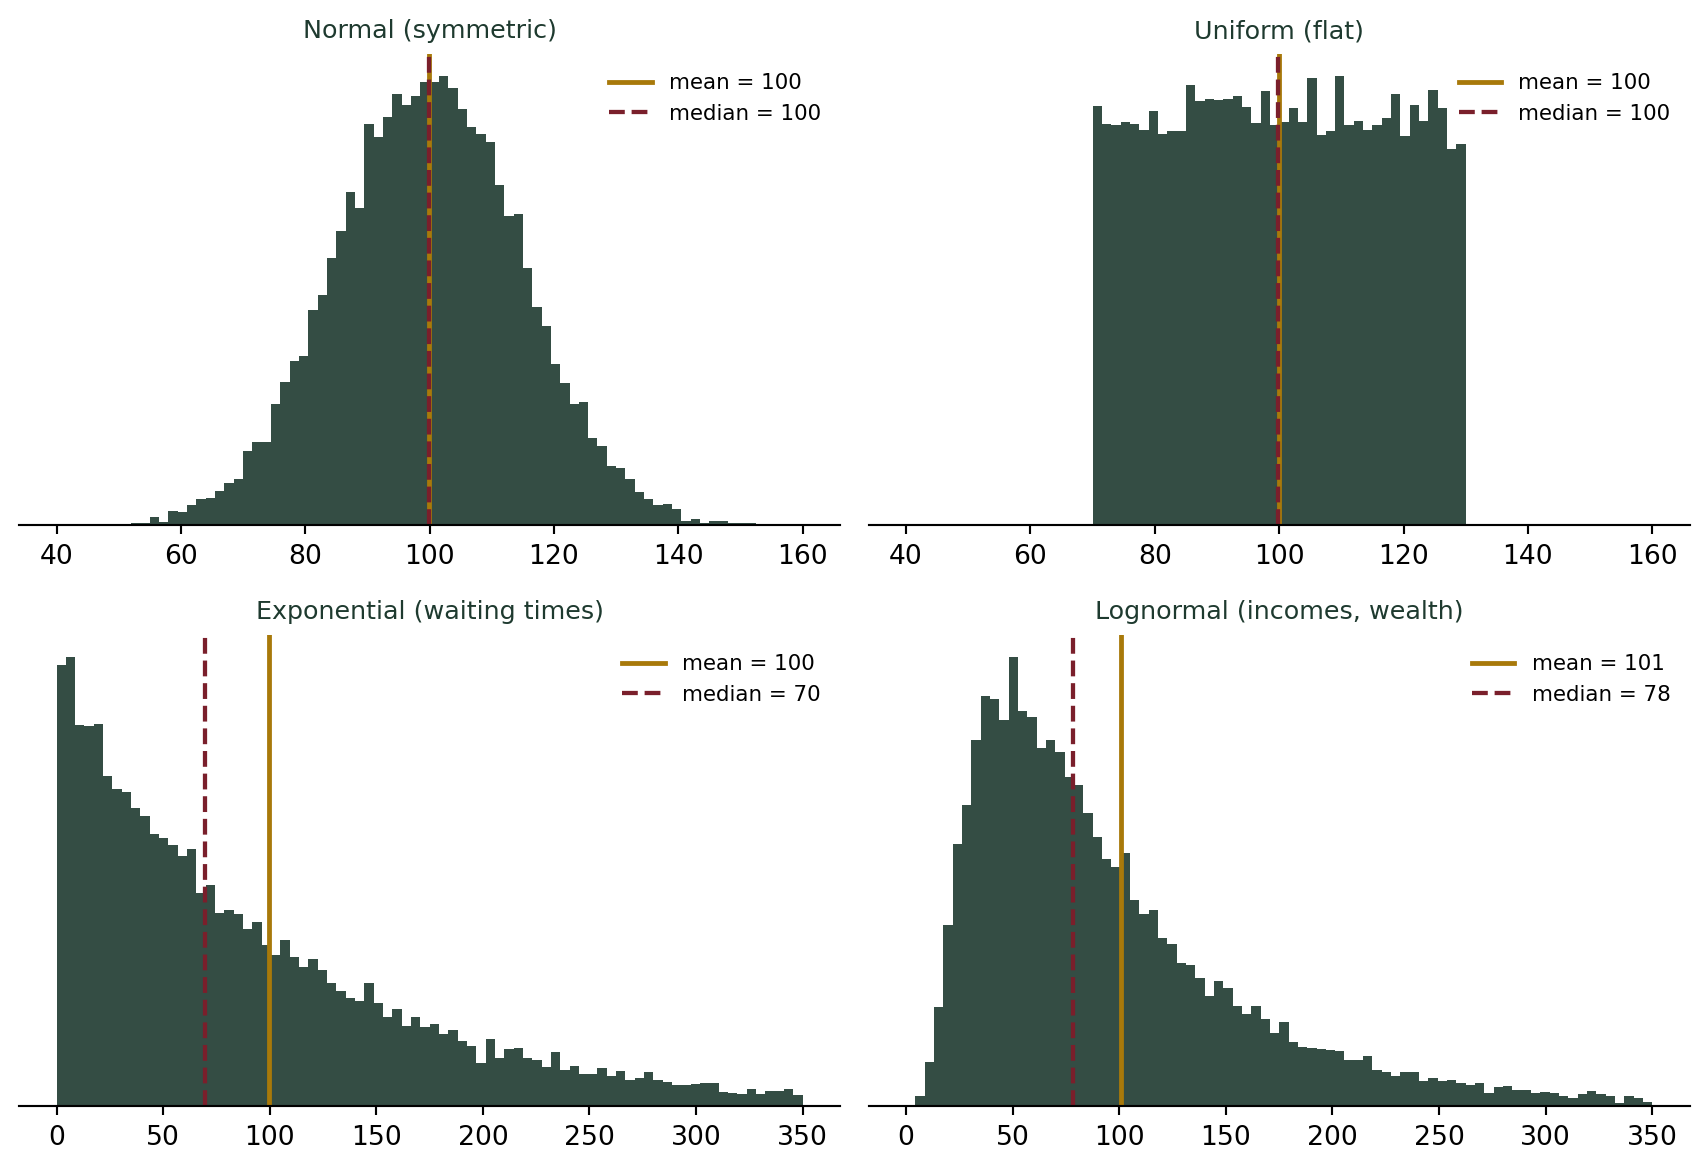
아래 그림은 같은 평균(100)을 가진 네 가지 가상의 데이터를 나란히 놓은 것이다. 왼쪽 위는 정규분포, 오른쪽 위는 균일분포, 왼쪽 아래는 지수분포(기다리는 시간), 오른쪽 아래는 로그정규분포(소득, 재산 같은 값)다.

Four distributions with the same mean of 100: normal (symmetric), uniform (flat), exponential (waiting times) and lognormal (incomes, wealth). Only the first looks like the textbook bell curve; the others have very different shapes and tails.

정규분포와 균일분포에서는 평균과 중앙값이 거의 같다. 그런데 지수분포와 로그정규분포에서는 평균이 중앙값보다 눈에 띄게 오른쪽에 있다. 꼬리가 긴 쪽으로 평균이 끌려가기 때문이다. 같은 “평균”이라도 분포의 모양에 따라 대표성이 달라진다는 뜻이다.

정규분포가 나타나는 조건

정규분포가 자연스럽게 나타나는 이유는 중심극한정리에 있다. 개별 데이터가 어떤 모양이든, 독립적인 값들이 많이 더해지거나 평균을 내면 그 합이나 평균의 분포는 정규분포에 가까워진다. 그래서 측정 오차, 여러 유전자의 합으로 결정되는 키, 많은 시험 문항의 합산 점수는 종 모양이 된다. 반면 소득은 곱셈 구조로 만들어진다. 학력, 업종, 경력, 운이 각각 소득을 몇 배씩 키우거나 줄이므로, 로그를 취해야 대칭에 가까워지는 로그정규 모양이 된다.
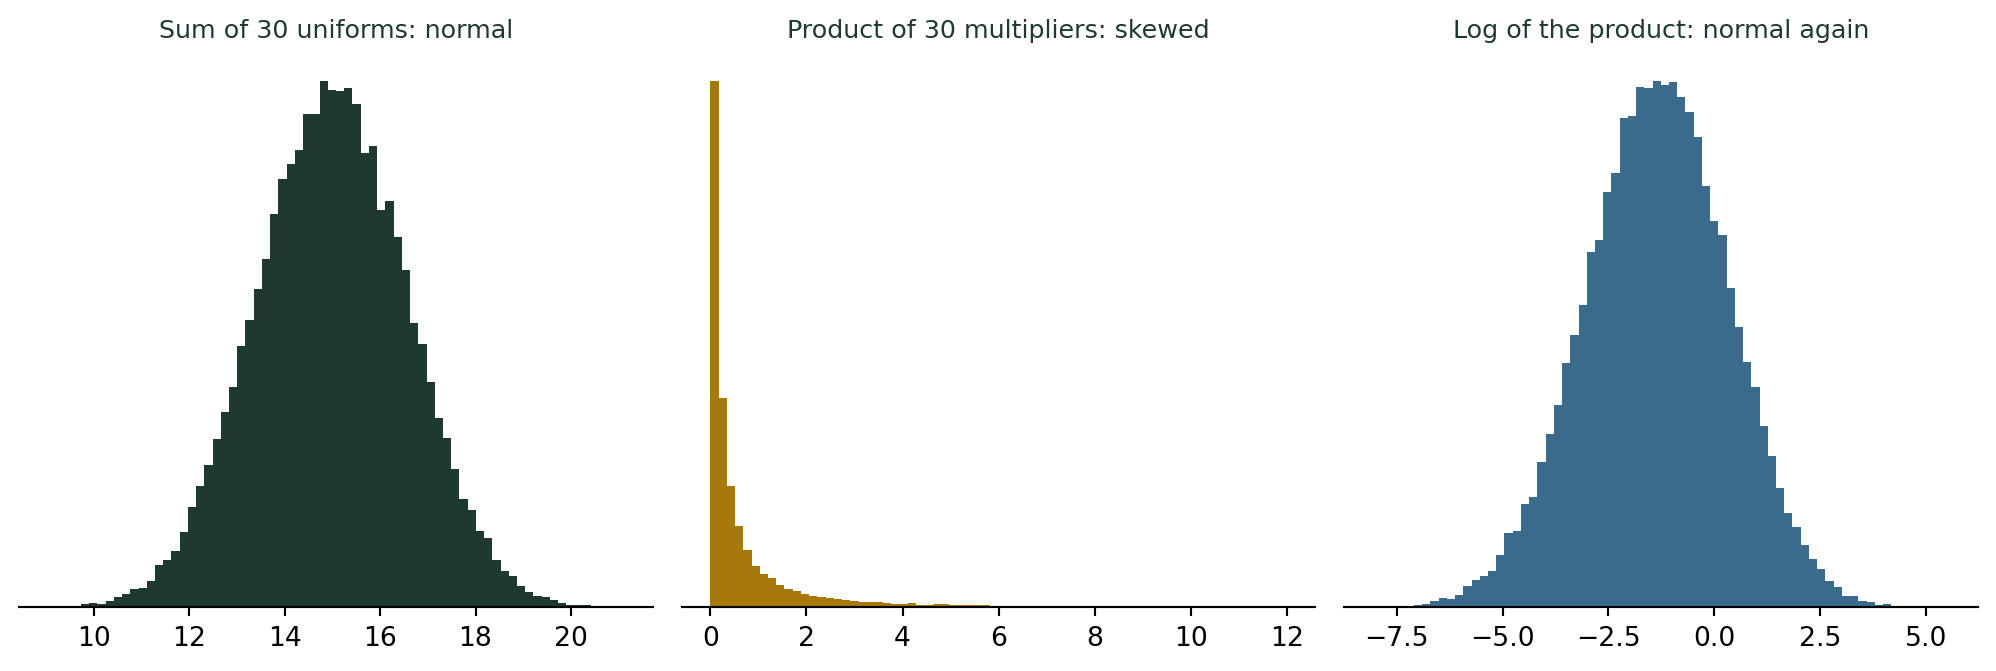
A sum of 30 independent uniform values looks normal. A product of 30 independent multipliers is strongly skewed on its own scale (values above 12 are cut off in the middle panel), but its logarithm, which is a sum of logs, looks normal again.

정규분포를 가정하기 전에 던질 질문

정규분포를 가정하면 평균과 표준편차만으로 모든 것을 설명할 수 있어 편하다. 그러나 그 편리함이 함정이 된다. 데이터가 한쪽으로 치우쳐 있는데도 평균과 표준편차로 “보통”을 정의하면, 실제 대부분의 사람과 동떨어진 기준이 나온다. 따라서 분석에 들어가기 전에 히스토그램을 먼저 그려보고, 대칭인지, 꼬리가 긴지, 상한이나 하한이 있는지를 확인하는 것이 순서다.

정규분포 가정을 점검하는 법
  1. 분포 모양부터 그려보라. 평균과 표준편차를 계산하기 전에 히스토그램 한 장이 가장 많은 것을 말해준다.
  2. 평균과 중앙값을 비교하라. 차이가 크면 분포가 치우쳐 있다는 신호다.
  3. “여러 요인이 더해졌는가, 곱해졌는가”를 생각하라. 더해지면 정규분포에 가깝고, 곱해지면 로그를 취해야 한다.
  4. 0이나 상한이 있는 데이터인지 확인하라. 음수가 불가능한 값은 대칭일 수 없다.

더 깊이: 정규분포의 정의와 중심극한정리

강의노트 〈수리통계학 5. 유명분포 — 정규분포〉는 정규분포를 평균 \(\mu\)와 분산 \(\sigma^2\)로 정의하고, 중심극한정리를 그 이론적 근거로 소개한다. 오늘 본 합의 분포와 곱의 분포 차이가 바로 그 정리가 말하는 조건을 눈으로 확인하는 과정이다.

SDV 관점: 분포를 가정하기 전에 분포를 데이터에서 확인하라

분포 모양을 확인하는 일은 요약과 추론(1~2단계)의 출발점이다. SDV(통계적 데이터 가치화) 관점에서 정규분포 가정은 데이터에 가치를 더하는 과정에서 조용히 판단을 왜곡하는 가장 흔한 원인이다. 고객 가치, 매출, 대기 시간 같은 지표에 평균과 표준편차로 “정상 범위”를 설정하면, 꼬리가 긴 데이터에서는 정상 범위가 너무 좁거나 넓게 잡힌다. 지표를 설계하기 전에 실제 분포를 그려보고 적합한 기준(중앙값, 분위수, 로그 변환)을 고르는 것이 데이터를 결정의 가치로 바꾸는 첫 단계다. (SDV(데이터 가치화))

결론: 종 모양은 가정이지, 출발점이 아니다

나는 학생들에게 정규분포를 “세상의 기본값”이 아니라 “여러 작은 힘이 더해진 결과에만 나타나는 특수한 모양”으로 기억하라고 말한다. 데이터를 받으면 공식보다 먼저 그림을 그려라. 종 모양이 보이면 정규분포를 쓰고, 한쪽으로 길게 늘어지면 다른 도구를 찾아라.

참고 자료
  • 중심극한정리와 정규분포에 관한 이론적 설명은 강의노트를 기준으로 했으며, 그림은 시뮬레이션 데이터(가상 자료)다.
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08