권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • AI_플랫폼(주식 매수 점수)
  • 유튜브
  1. 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고

목차

  • 평균 12통, 그런데 날마다 다르다
  • 포아송분포는 무엇을 세는가
  • 1년 365일 시뮬레이션으로 확인하기
  • 포아송분포를 쓰는 조건
  • 더 깊이: 포아송 과정과 포아송분포
  • SDV 관점: 평균과 함께 “정상 변동의 폭”을 설계하라
  • 결론: 평균이 같아도 하루는 흔들린다

(분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포

통계기초
분포
콜센터에 하루 평균 12통의 전화가 걸려 온다면, 어떤 날은 6통이고 어떤 날은 20통이다. 이 흔들림은 우연일까, 문제일까? 일정한 평균 속도로 독립적으로 일어나는 사건의 횟수는 포아송분포를 따른다. 평균 하나로 날마다의 변동 폭까지 예측할 수 있다.
Author

권세혁

Published

October 15, 2026

평균 12통, 그런데 날마다 다르다

한 고객센터가 하루 평균 12통의 전화를 받는다고 하자. 그런데 실제로 어떤 날은 7통, 어떤 날은 18통이 걸려 온다. 관리자는 이 날마다의 차이를 보고 “오늘은 인력이 부족했다”거나 “무슨 일이 생겼다”고 해석하기 쉽다. 그러나 평균이 같아도 이런 흔들림은 자연스럽게 생긴다. 일정한 평균 속도로 서로 독립적으로 일어나는 사건의 횟수는 포아송분포를 따르고, 포아송분포는 평균 하나만으로 날마다의 변동 폭까지 말해준다.

포아송분포는 무엇을 세는가

포아송분포는 정해진 시간이나 공간 안에서 드물게 일어나는 사건의 횟수를 센다. 평균 발생 횟수를 \(\lambda\)라고 하면, \(k\)번 일어날 확률은

\[P(X=k)=\frac{e^{-\lambda}\lambda^{k}}{k!}\]

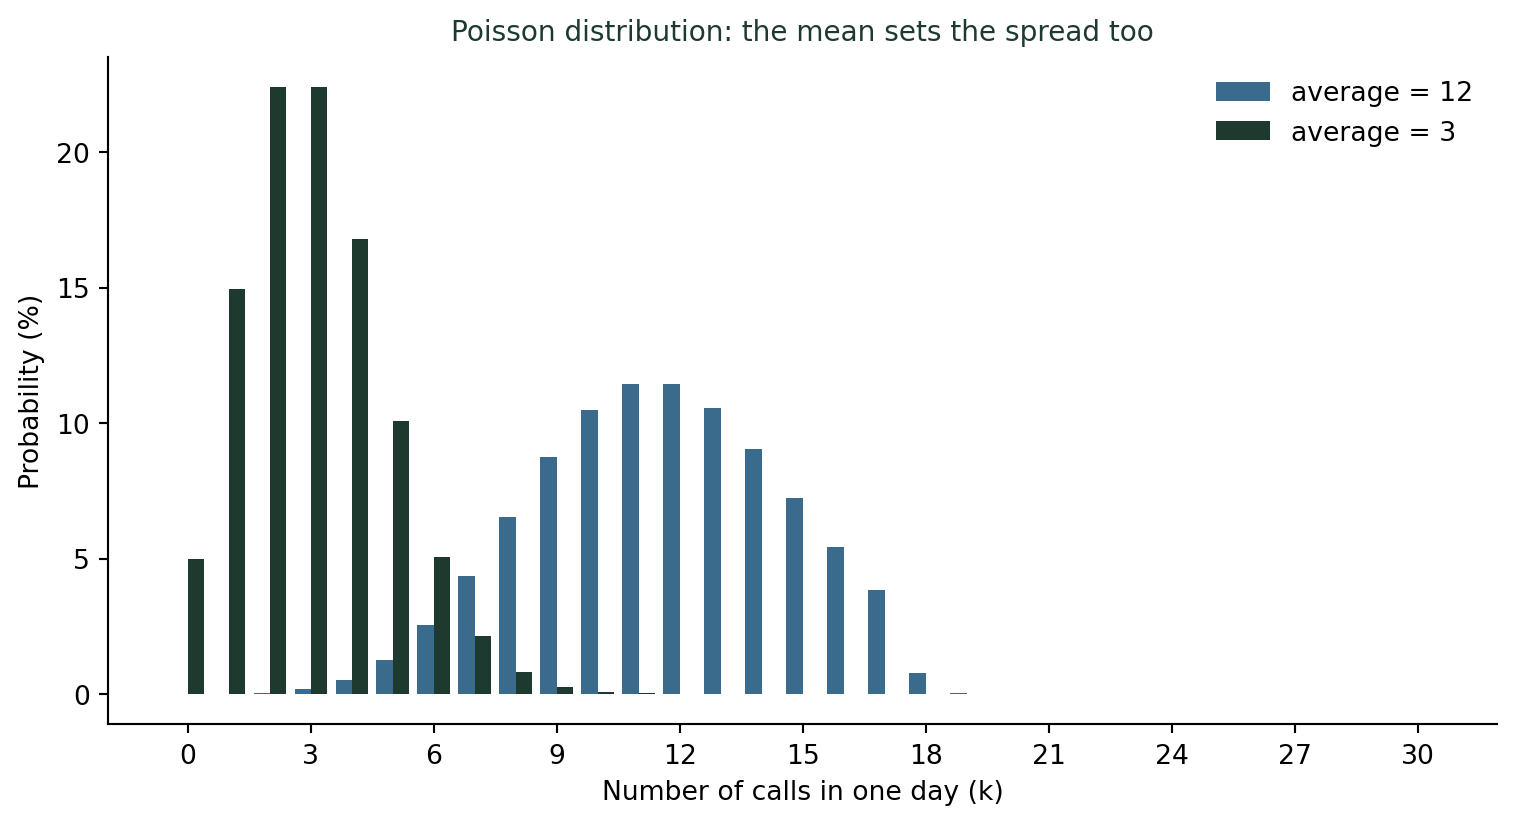
이다. 이 분포의 가장 중요한 특징은 평균과 분산이 모두 \(\lambda\)라는 점이다. 평균이 12이면 분산도 12, 표준편차는 약 3.5다. 그래서 평균 12통인 날의 “보통” 변동은 대략 8통에서 16통 사이에 있다.

Poisson probabilities of k calls per day when the average is 12 (blue-grey) and 3 (dark green). The larger average gives a wider, more symmetric spread around its mean, and the small average gives a skewed shape close to zero.

1년 365일 시뮬레이션으로 확인하기

이론이 실제 하루하루에 맞는지 확인해 보자. 평균 12통의 포아송 과정을 365일 동안 시뮬레이션하고, 날마다 걸려 온 전화 수의 히스토그램을 이론값과 겹쳐 본다.
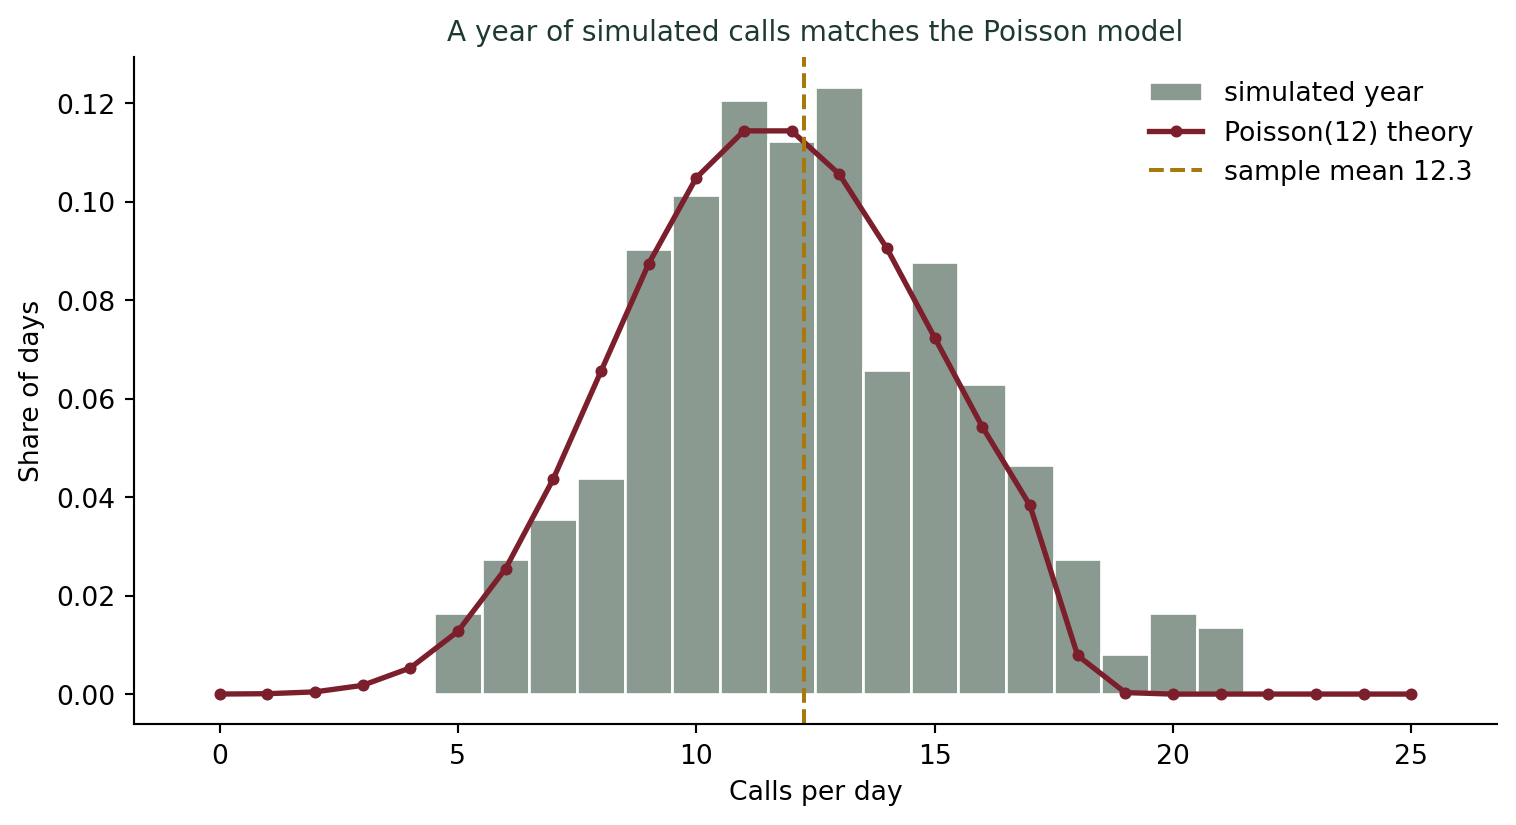
One simulated year (365 days) of calls from a Poisson process with average 12 per day. Histogram of daily counts (bars) with the theoretical Poisson probabilities (line). The two agree closely, so the day-to-day swings are what chance alone would produce.

시뮬레이션에서 날마다의 전화 수는 평균 근처에 모이되, 6통이나 18통인 날도 자주 나온다. 이 흔들림은 고객센터가 무언가를 잘못했다는 신호가 아니다. 평균이 12인 포아송 과정에서 기대되는 정상적인 모습이다.

포아송분포를 쓰는 조건

포아송분포가 맞으려면 세 가지 조건이 필요하다. 사건이 일정한 평균 속도로 일어나야 하고, 한 사건이 다음 사건의 발생에 영향을 주지 않아야 하며(독립), 같은 짧은 구간에 두 사건이 동시에 일어나지 않아야 한다. 전화 수는 대체로 이 조건에 가깝다. 그러나 점심시간에는 전화가 몰리고 월요일 아침에는 평균이 더 높다면, 하루 전체를 하나의 평균으로 보는 것은 무리다. 시간대별로 평균을 나누어 보아야 한다.

포아송 모형을 적용하기 전에 확인할 것
  1. 사건이 드물고 독립적인가? 한 번 일어난 사건이 다음 사건을 부추기면 포아송이 아니다.
  2. 평균이 일정한가? 요일이나 시간대에 따라 평균이 바뀌면 구간을 나눠야 한다.
  3. 분산이 평균과 비슷한가? 분산이 평균보다 훨씬 크면 과산포(overdispersion)이므로 다른 모형을 고려하라.
  4. “평균과 다른 날”을 기대 범위와 비교하라. 포아송이라면 평균 ± 2σ 밖은 드물다.

더 깊이: 포아송 과정과 포아송분포

강의노트 〈수리통계학 5. 유명분포 — 포아송분포〉는 포아송 과정의 조건과, 평균과 분산이 모두 \(\lambda\)인 포아송분포를 정의한다. 앞서 군집 착각 글에서 다룬 것도 같은 포아송 구조였다. 이번에는 같은 분포가 하루의 전화 수라는 일상의 숫자를 설명하는 데 쓰였다.

SDV 관점: 평균과 함께 “정상 변동의 폭”을 설계하라

포아송 모형으로 기대 변동을 계산하는 일은 요약과 추론(1~2단계)의 실전 응용이다. SDV(통계적 데이터 가치화) 관점에서 이 계산은 운영 데이터의 해석 기준을 만든다. 고객 문의, 주문 건수, 서버 요청 수는 모두 평균 주변에서 흔들린다. 그 흔들림이 포아송 범위 안이면 인력 배치와 재고를 평균 기준으로 조정하면 되지만, 범위를 벗어나면 원인을 찾아야 한다. 평균만 보고 날마다 반응하면 정상 변동을 문제로 착각해 쓸데없는 대응을 반복하게 된다. 평균과 함께 정상 변동의 폭을 제시하는 것이 데이터를 실제 운영의 가치로 바꾸는 방법이다. (SDV(데이터 가치화))

결론: 평균이 같아도 하루는 흔들린다

나는 학생들에게 날마다의 숫자가 흔들린다고 곧바로 원인을 찾으려 하지 말라고 말한다. 평균이 12인 전화는 어떤 날 18통이 걸려 오는 것이 당연하다. 포아송분포는 그 흔들림이 얼마나 자연스러운지를 알려주는 도구이고, 그 범위를 넘을 때에만 비로소 이야기할 거리가 생긴다.

참고 자료
  • 시뮬레이션 자료는 평균 12의 포아송 난수를 사용한 가상의 1년치 데이터다. 실제 고객센터의 전화 수 분포는 시간대와 계절에 따라 다를 수 있다.
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08