권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • AI_플랫폼(주식 매수 점수)
  • 유튜브
  1. 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가

목차

  • 윷이 나올 확률은 5분의 1일까
  • 표본공간: 일어날 수 있는 모든 일의 목록
  • 사건의 크기가 곧 확률이다
  • 더 깊이: 집합의 언어로 쓰는 확률
  • SDV 관점: 데이터 분석의 첫 질문은 “가능한 경우의 전체가 무엇인가”
  • 결론: 세기 전에 나열하라

(확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가

통계기초
확률
윷 네 개를 던지면 도·개·걸·윷·모 다섯 가지 결과가 나온다. 그렇다면 각각 20%일까? 아니다. 개는 37.5%, 윷과 모는 6.25%다. 확률을 계산하는 첫걸음은 ’무엇이 일어날 수 있는가’를 빠짐없이 나열하는 표본공간과 사건이라는 언어를 익히는 일이다.
Author

권세혁

Published

September 28, 2026

윷이 나올 확률은 5분의 1일까

설날 가족 윷놀이에서 누군가 “윷이 나올 확률은 다섯 가지 중 하나니까 20%지”라고 말했다면, 틀린 말이다. 결과의 종류가 다섯 가지(도·개·걸·윷·모)라는 것과, 다섯 결과가 같은 확률이라는 것은 전혀 다른 이야기다. 윷가락 하나가 평평한 면과 둥근 면이 나올 확률을 각각 50%라고 가정하면, 개는 37.5%, 도와 걸은 각각 25%, 윷과 모는 각각 6.25%다. 개가 윷보다 여섯 배 자주 나온다. 어떻게 이런 계산이 나올까? 답은 ’표본공간’을 제대로 세는 데 있다.

표본공간: 일어날 수 있는 모든 일의 목록

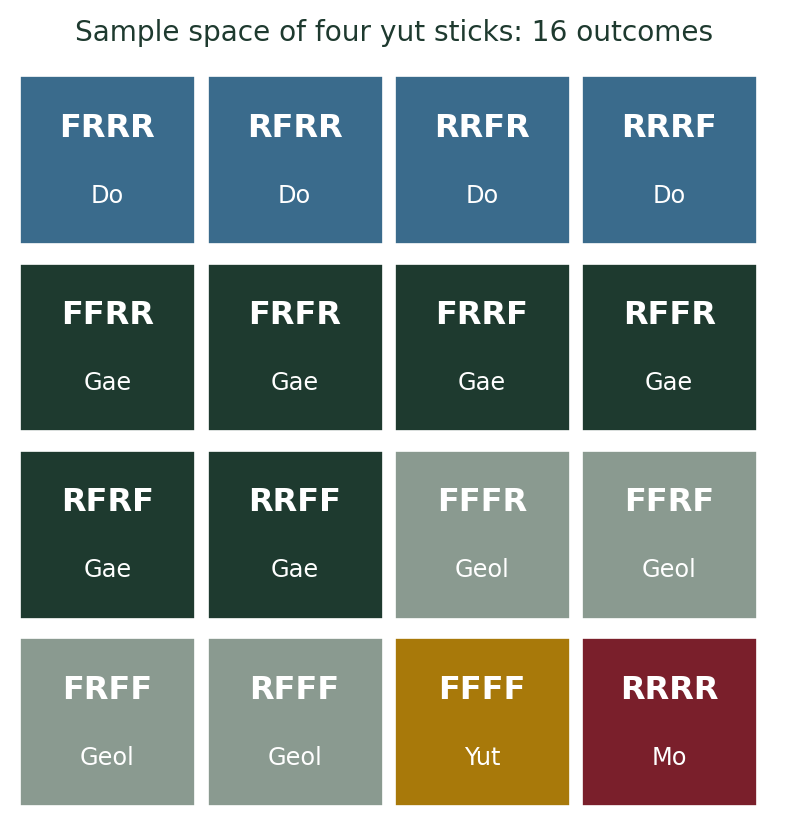
확률에서 가장 먼저 하는 일은 실험을 던져서 나올 수 있는 모든 결과의 집합, 곧 표본공간(sample space)을 적는 것이다. 윷가락 네 개를 구별해서 각각 평평한 면(F) 또는 둥근 면(R)이 나온다고 하면, 표본공간은 \(2^4=16\)가지다. 도·개·걸·윷·모는 이 16가지 결과를 ’평평한 면이 몇 개인가’로 묶어 이름 붙인 것에 지나지 않는다. 이렇게 표본공간의 일부분을 묶은 것을 사건(event)이라 부른다.

The 16 equally likely outcomes of throwing four yut sticks (F = flat side up, R = round side up), colored by the named result. The five results are events of very different sizes: 4, 6, 4, 1 and 1 outcomes.

사건의 크기가 곧 확률이다

모든 결과가 같은 가능성을 갖는다는 가정(균등가능성) 아래에서는 사건 \(A\)의 확률이 \(P(A)=|A|/|S|\), 곧 사건에 속한 결과의 수를 표본공간 전체의 수로 나눈 값이다. 윷은 FFFF 한 가지뿐이니 \(1/16=6.25\%\), 개는 평평한 면이 두 개인 \(\binom{4}{2}=6\)가지이니 \(6/16=37.5\%\)다. ’결과의 종류가 다섯 가지’는 사건의 이름이 다섯 개라는 뜻일 뿐, 표본공간의 원소가 다섯 개라는 뜻이 아니다.
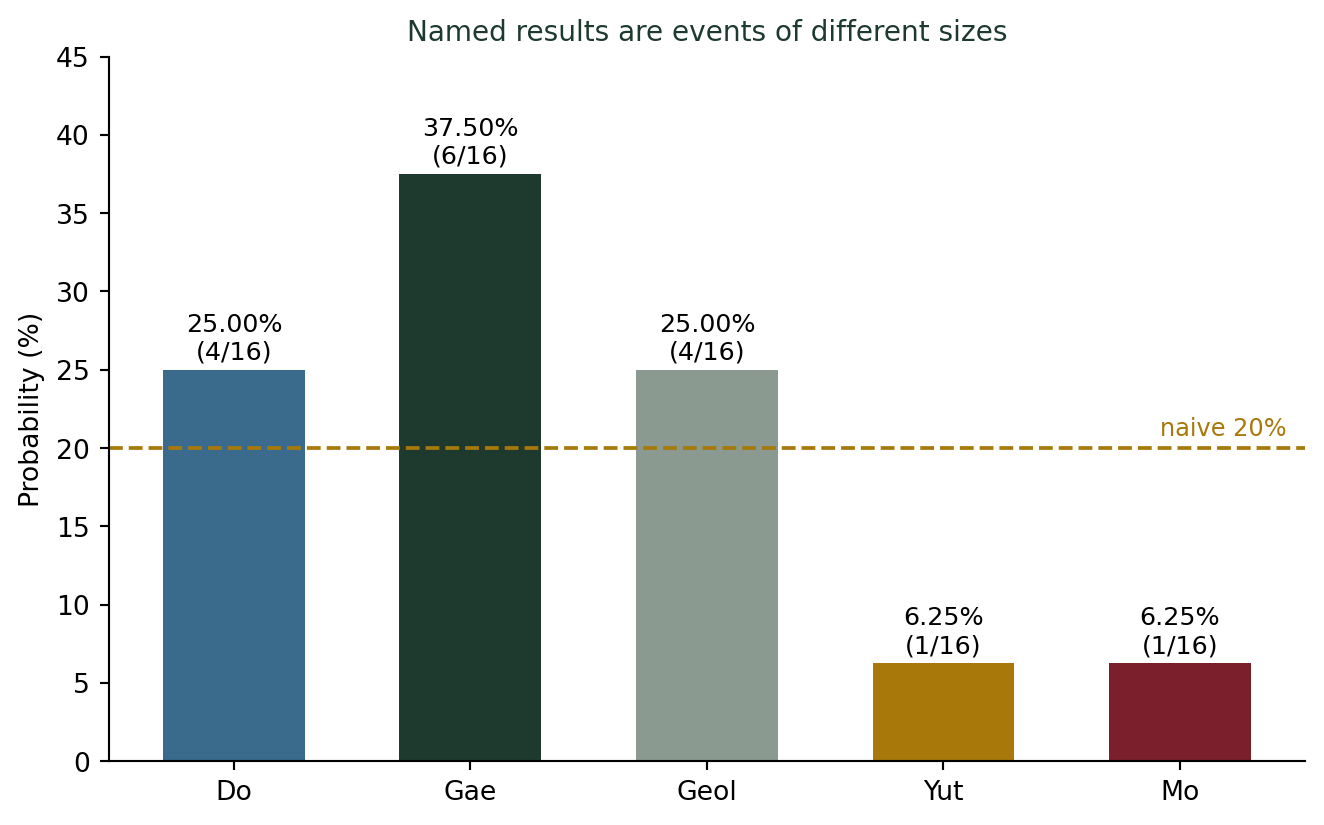
Probability of each yut result when each stick lands flat or round with probability 1/2, compared with the naive ‘1 in 5 = 20%’ guess (dashed line).

물론 실제 윷가락은 한쪽이 반원형이라 평평한 면과 둥근 면이 정확히 반반으로 나오지는 않는다. 여기서 계산한 값은 ’50 대 50’이라는 가정을 둔 이론값이며, 가정이 달라지면 표본공간의 각 원소 확률이 달라진다. 그래도 도·개·걸이 흔하고 윷·모가 귀하다는 큰 그림은 바뀌지 않는다.

확률 문제를 읽을 때 먼저 확인할 것
  1. 표본공간을 먼저 적어라. “무엇이 일어날 수 있는가”를 빠짐없이, 겹치지 않게 나열하는 일이 계산의 절반이다.
  2. 결과의 ’종류’와 ’가능성’을 혼동하지 마라. 종류가 다섯이라고 각각 \(1/5\)인 것은 아니다.
  3. 사건은 표본공간의 부분집합이다. 사건을 ’결과들의 묶음’으로 그려보면 확률은 묶음의 크기 비교가 된다.
  4. 균등가능성 가정이 성립하는지 스스로 물어라. 성립하지 않으면 원소마다 확률을 따로 붙여야 한다.

더 깊이: 집합의 언어로 쓰는 확률

강의노트 〈수리통계학 1. 확률론 — 표본공간과 사건〉은 표본공간을 실험의 모든 가능한 결과의 집합으로 정의하고, 사건을 그 부분집합으로 다룬다. 합집합·교집합·여집합 같은 집합 연산이 곧 ‘또는’·‘그리고’·’아니다’의 언어가 된다는 점이 앞으로 두 주 동안 쓸 모든 도구의 바탕이다.

SDV 관점: 데이터 분석의 첫 질문은 “가능한 경우의 전체가 무엇인가”

표본공간을 정의하는 일은 요약과 추론(1~2단계)의 출발점이다. 제가 제안하는 SDV(통계적 데이터 가치화) 관점에서 이는 더 실용적인 뜻을 갖는다. “전환율 3%”, “불량률 0.5%” 같은 숫자는 ‘무엇을 한 번의 시도로 세었는가’, 곧 표본공간의 단위를 정해야 비로소 의미가 생긴다. 방문자 기준인지 세션 기준인지, 부품 기준인지 로트 기준인지에 따라 같은 데이터가 전혀 다른 확률을 만든다. 데이터에 가치를 더하는 첫 단계는 계산이 아니라, 숫자가 어떤 표본공간 위에서 정의됐는지를 못 박는 일이다. (SDV(데이터 가치화))

결론: 세기 전에 나열하라

나는 학생들에게 확률 문제 앞에서 계산기를 두드리기 전에 표본공간부터 종이에 적어보라고 말한다. 윷놀이의 개가 윷보다 여섯 배 흔한 이유는 신비로운 것이 아니라, 개라는 사건에 속한 결과가 여섯 개이고 윷에는 하나뿐이라는 단순한 세기의 문제다. 확률은 결국 ’얼마나 많은 경우가 그 사건에 해당하는가’를 세는 언어다.

참고 자료
  • 윷가락 확률 ‘개 > 걸 = 도 > 윷 = 모’ 順 — 문화일보
  • 윷놀이 — 위키백과
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08