권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • AI_플랫폼(주식 매수 점수)
  • 유튜브
  1. 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고

목차

  • 규칙 목록 대신 확률로 배우는 필터
  • 단어 하나로 믿음을 바꾸기
  • 단어마다 얼마나 무게가 있는가
  • 학습은 곧 갱신이다
  • 더 깊이: 베이즈 규칙
  • SDV 관점: 데이터는 한 번 분석하고 끝나지 않는다
  • 결론: 믿음은 증거를 만나면 바뀌어야 한다

(조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신

통계기초
확률
2002년 폴 그레이엄은 ’스팸 계획(A Plan for Spam)’에서 단어 하나의 등장으로 메일이 스팸일 확률을 계산하는 방법을 제안했다. 메일 한 통에 나온 단어들이 차례로 확률을 밀어 올리거나 내린다. 스팸 필터는 규칙을 외우지 않고, 증거가 들어올 때마다 믿음을 고쳐 가며 배운다.
Author

권세혁

Published

October 8, 2026

규칙 목록 대신 확률로 배우는 필터

초기의 스팸 필터는 “무료”, “당첨” 같은 단어가 들어 있으면 차단하는 규칙 목록이었다. 스패머들은 금방 철자를 바꾸었고, 규칙은 끝없이 늘어났다. 2002년 프로그래머 폴 그레이엄은 다른 길을 제안했다. 메일 속 단어들이 스팸일 확률을 베이즈 정리로 계산하고, 사용자가 스팸을 표시할 때마다 그 확률을 갱신하자는 것이다. 이 방식을 나이브 베이즈(naive Bayes) 필터라고 부른다. 여기서 핵심은 규칙이 고정되지 않고 증거가 들어올수록 믿음이 바뀌는 것이다.

단어 하나로 믿음을 바꾸기

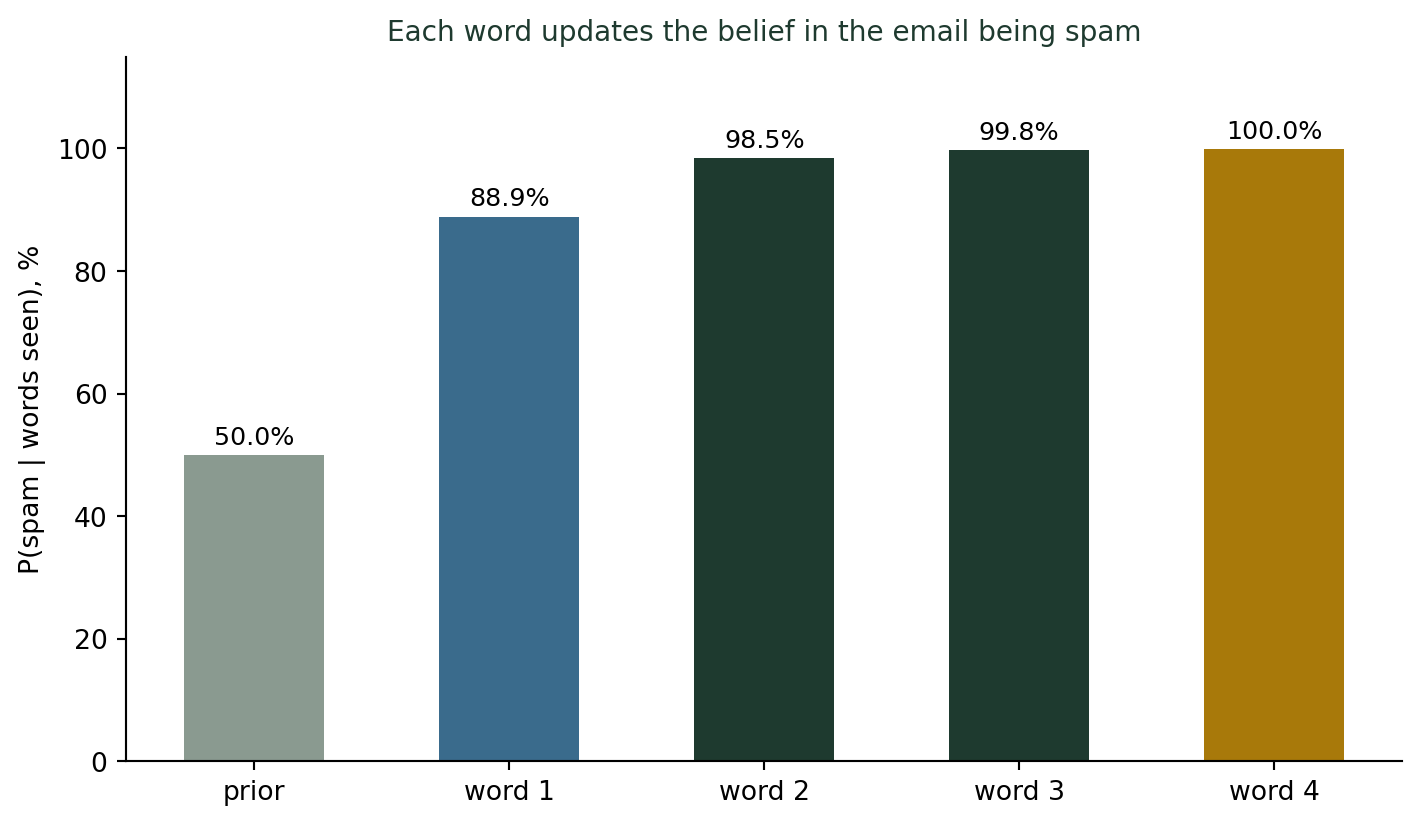
메일이 스팸일 사전확률을 50%라고 하자. 어떤 단어 “무료”가 스팸에는 80%의 확률로 나타나고, 정상 메일에는 10%만 나타난다고 가정한다. 메일에 “무료”가 들어 있다면 베이즈 정리에 따라

\[P(\text{스팸}\mid\text{무료})=\frac{P(\text{무료}\mid\text{스팸})P(\text{스팸})}{P(\text{무료}\mid\text{스팸})P(\text{스팸})+P(\text{무료}\mid\text{정상})P(\text{정상})}=\frac{0.8\times0.5}{0.8\times0.5+0.1\times0.5}\approx88.9\%\]

이다. 메일 한 통에 단어 하나가 들어왔을 뿐인데 스팸일 확률이 50%에서 89%로 뛴다. 이 새로운 값이 다음 단어를 계산할 때의 출발점, 곧 새로운 사전확률이 된다.

Belief update for one email: starting from a 50% prior, each additional spam-indicating word (each with likelihood 0.8 in spam and 0.1 in normal mail) raises the probability that the email is spam. Certainty builds quickly, and no single word settles it.

단어마다 얼마나 무게가 있는가

모든 단어가 같은 힘을 갖지는 않는다. 어떤 단어는 스팸에서만 자주 나오고, 어떤 단어는 정상 메일에서도 흔하다. 필터는 각 단어가 스팸과 정상 메일을 얼마나 잘 구분하는지를 데이터에서 배운다. 아래 그림은 같은 사전확률에서 단어마다 다른 힘을 가진다는 점을 보여준다.
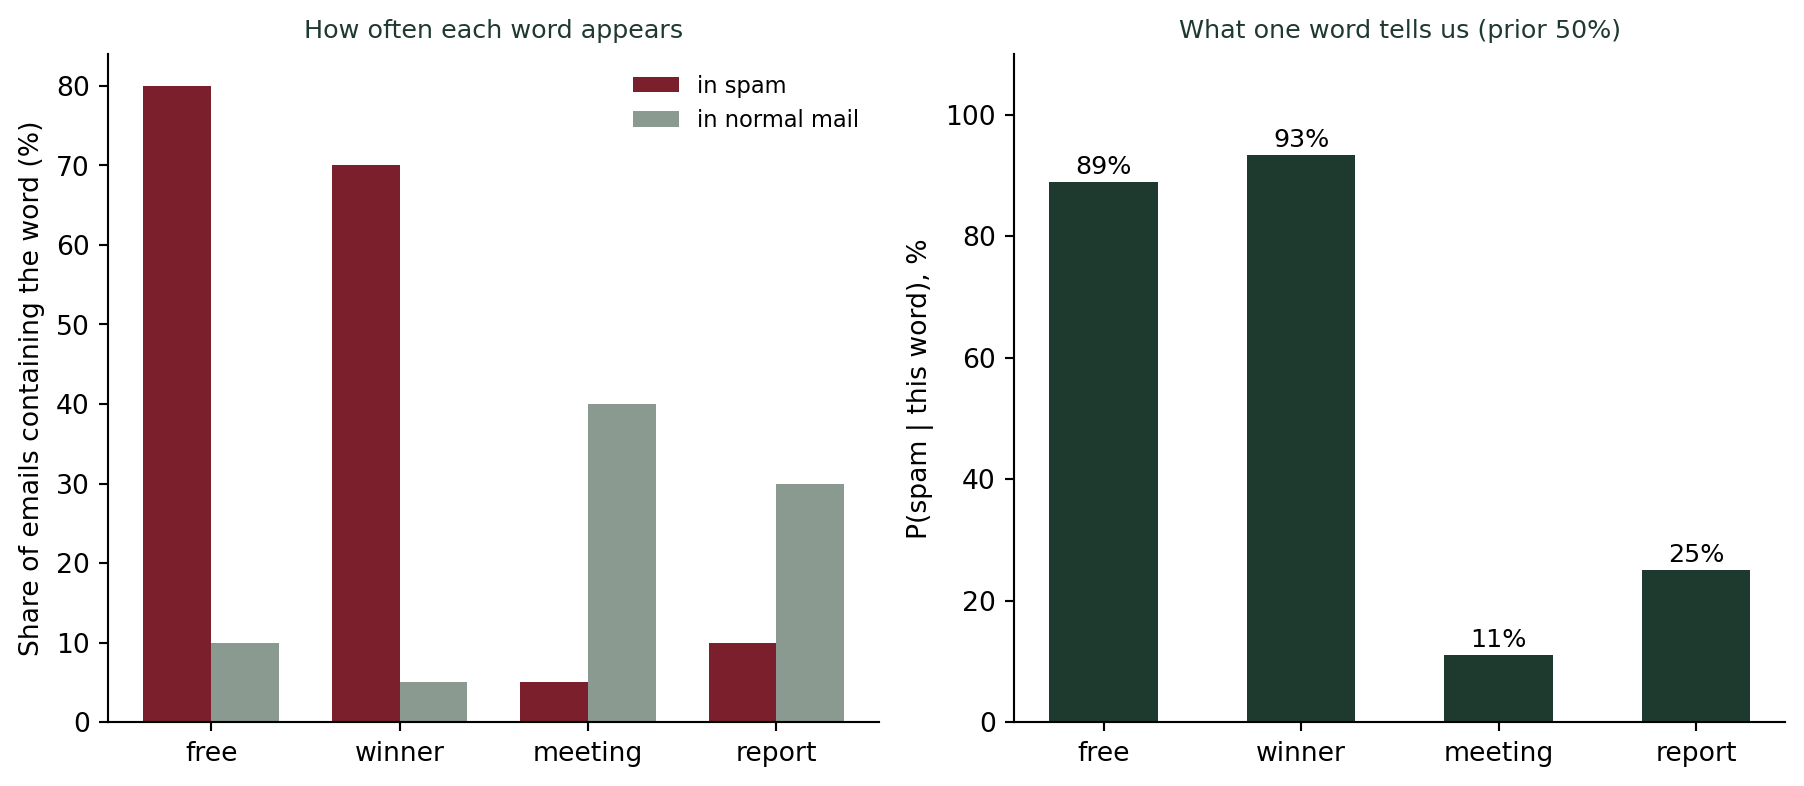
Illustrative word-level evidence: how often each word appears in spam versus normal mail, and the resulting probability that a single email containing it is spam (prior 50%). Words that appear mostly in spam move the belief the most.

학습은 곧 갱신이다

필터는 사용자가 스팸을 표시하거나 정상 메일을 구출할 때마다 각 단어의 확률을 조금씩 고친다. 이것은 베이즈 갱신의 전형적인 모습이다. 새로운 증거가 들어올 때마다 사전확률을 사후확률로 바꾸고, 그 사후확률이 다음 판단의 출발점이 된다. 그래서 스패머가 새로운 단어를 써도, 사용자의 몇 번의 표시만으로 필터는 빠르게 따라잡는다.

베이즈 갱신을 따라가는 법
  1. 사전확률을 먼저 적어라. 증거를 보기 전 믿음이 출발점이다.
  2. 증거가 각 가설에서 얼마나 자주 나타나는지 비교하라. 우도 \(P(\text{증거}\mid\text{가설})\)의 차이가 갱신의 힘이다.
  3. 사후확률을 다음 단계의 사전확률로 써라. 증거가 여러 개일 때 이 과정을 반복하면 된다.
  4. 독립 가정을 의심하라. 나이브 베이즈는 단어들이 독립이라고 가정하므로, 실제로 함께 나타나는 단어들은 힘을 과대평가할 수 있다.

더 깊이: 베이즈 규칙

강의노트 〈수리통계학 1. 확률론 — 베이즈 규칙〉은 \(P(A\mid B)=P(B\mid A)P(A)/P(B)\)와 전확률 법칙을 결합한 베이즈 규칙을 소개한다. 오늘 스팸 필터의 계산은 이 규칙을 증거 하나씩에 반복 적용한 것이다. 앞선 두 편에서 본 조건의 방향 문제가 여기서 실제 기계의 학습 과정이 된다.

SDV 관점: 데이터는 한 번 분석하고 끝나지 않는다

베이즈 갱신은 요약과 추론(1~2단계)을 넘어, 데이터가 쌓일수록 판단이 나아지는 구조를 설계하는 일이다. SDV(통계적 데이터 가치화) 관점에서 스팸 필터는 좋은 사례다. 한 번 만든 규칙은 환경이 바뀌면 쓸모가 없어지지만, 확률을 갱신하는 구조는 새로운 증거를 흡수하며 가치를 유지한다. 데이터 분석의 가치는 보고서 한 장이 아니라, 새 데이터가 들어올 때 판단을 고쳐 가는 절차에 있다. 그 절차를 설계하는 것이 AI 시대에 통계학자가 맡을 일이다. (SDV(데이터 가치화))

결론: 믿음은 증거를 만나면 바뀌어야 한다

나는 학생들에게 스팸 필터를 떠올리라고 말한다. 필터는 규칙을 외운 것이 아니라 메일을 받을 때마다 “이제 얼마나 스팸 같은가”를 다시 계산한다. 베이즈 갱신은 그 계산을 한 줄의 원칙으로 정리한다. 처음의 믿음은 출발점일 뿐이고, 증거가 믿음을 바꿀 때 비로소 배움이 일어난다.

참고 자료
  • Paul Graham, A Plan for Spam (2002) — paulgraham.com/spam.html
  • 앞의 계산 예시(단어별 출현 비율)는 설명을 위한 가상의 숫자다.
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08