(분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
통계기초
분포
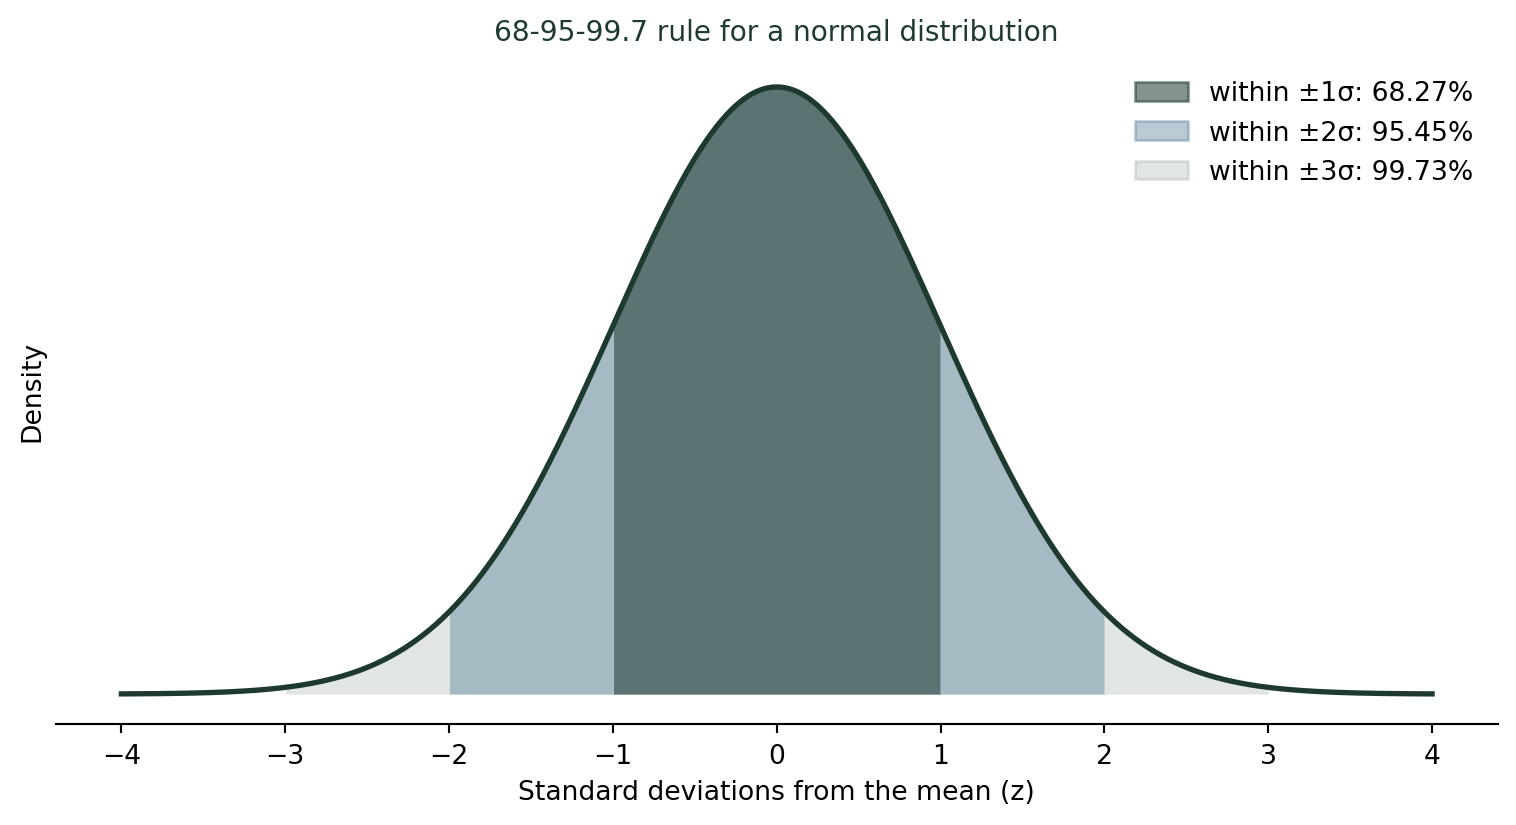
정규분포에서 평균 ± 1·2·3 표준편차 안에 들어갈 확률은 각각 68%, 95%, 99.7%다. 그러니 세 표준편차 밖은 370번에 한 번꼴이다. 이 숫자는 이상치를 판정하는 편리한 기준이 되지만, 정규분포가 아닌 데이터에서도 똑같이 쓰면 잘못된 경보를 울린다.
세 표준편차 밖은 드문 값일까
공장에서 생산되는 부품의 길이를 재서 평균이 10.00mm, 표준편차가 0.02mm라고 하자. 어느 날 10.07mm짜리 부품이 나왔다. 평균에서 0.07mm 떨어졌으니 표준편차의 3.5배다. 이 부품은 ’이상한 것’일까? 많은 현장에서 “3시그마 밖은 이상하다”는 규칙을 쓴다. 그 근거가 바로 정규분포의 68-95-99.7 법칙이다.
정규분포에서 세 구간의 확률
정규분포는 평균을 중심으로 대칭이다. 평균 ± 1σ 안에 들어갈 확률은 약 68.3%, ± 2σ 안에는 약 95.4%, ± 3σ 안에는 약 99.7%다. 따라서 어느 한쪽이든 3σ를 넘을 확률은 약 0.13%, 양쪽을 합하면 0.27%, 즉 약 370개 중 1개꼴이다.
이 법칙이 말해주지 않는 것
68-95-99.7 법칙은 데이터가 정규분포일 때만 성립한다. 그런데 정규분포가 아닌 데이터에 이 규칙을 그대로 적용하면, 실제보다 훨씬 많은 값이 “이상치”로 잡히거나, 반대로 진짜 이상치가 정상으로 넘어간다. 아래 그림은 정규분포와 꼬리가 긴 분포(로그정규분포)에서 평균 ± 3표준편차 밖에 떨어지는 비율을 비교한 것이다.
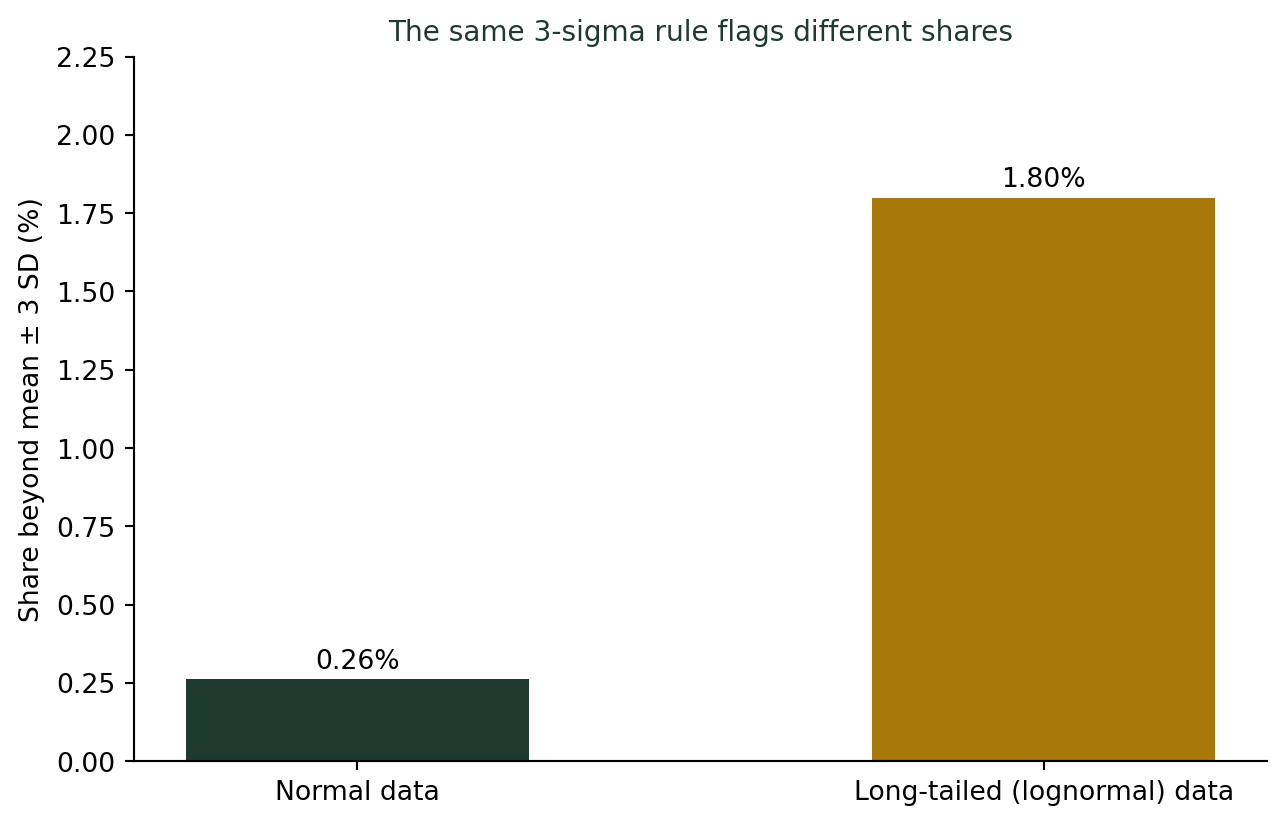
비율의 차이만 보면 정규분포의 0.27%와 로그정규분포의 값이 얼마나 다른지 바로 와닿지 않을 수 있다. 중요한 것은 그 차이가 경보의 빈도로 바뀐다는 점이다. 하루 1만 건의 거래를 감시하는 시스템에서 0.27%는 하루 27건이지만, 꼬리가 긴 데이터에서 실제 비율이 그보다 몇 배 높다면 경보는 하루 수백 건이 되어 담당자가 감당할 수 없게 된다.
분포에 상관없이 쓸 수 있는 보장: 체비셰프 부등식
분포 모양을 모를 때는 체비셰프 부등식이 안전한 하한을 준다. 평균에서 \(k\)표준편차 이상 떨어질 확률은 \(1/k^2\)를 넘지 않으므로, 어떤 분포에서든 평균 ± 3σ 안에 최소 \(1-1/9\approx88.9\%\)가 들어간다. 정규분포라면 99.7%이지만, 분포를 모르면 보장은 88.9%까지 떨어진다. 이 차이가 바로 정규분포 가정이 주는 이득과 위험의 크기다.
3σ 기준을 쓰기 전에 확인할 것
- 데이터의 분포를 먼저 그려보라. 정규분포가 아니면 68-95-99.7은 근사조차 되지 않는다.
- 이상치 판정을 확률로 바꿔 계산하라. 일일 건수와 곱해 실제 경보 횟수를 추정하라.
- 분포를 모르면 체비셰프로 하한을 잡아라. 보수적이지만 가정이 필요 없다.
- 이상치의 정의를 업무 비용과 연결하라. 놓치는 비용과 경보의 비용 중 무엇이 큰지에 따라 기준이 달라진다.
더 깊이: 체비셰프 부등식
강의노트 〈수리통계학 5. 확률분포함수 관련 부등식 — 체비셰프 부등식〉는 분포의 모양에 관계없이 평균에서 멀리 떨어진 값의 확률을 분산으로 상한을 잡는 부등식을 소개한다. 오늘 살펴본 “분포를 몰라도 88.9%는 보장된다”는 말이 바로 이 부등식의 결과다.
SDV 관점: 이상치 기준은 확률로 계산하고 비용으로 정하라
정규분포 기준으로 이상치를 판정하는 일은 요약과 추론(1~2단계)에 속한다. SDV(통계적 데이터 가치화) 관점에서 중요한 것은 기준 자체가 아니라 그 기준이 만들어낼 결과다. 품질 관리, 부정 거래 탐지, 서버 모니터링에서 “3σ 밖”이라는 규칙을 기계적으로 적용하면, 분포가 치우친 지표에서 경보가 폭주해 정작 중요한 신호가 묻힌다. 기준을 정할 때는 분포를 확인해 실제 경보율을 계산하고, 그 경보를 처리하는 비용과 놓쳤을 때의 손실을 함께 놓고 결정해야 데이터가 판단의 가치를 만든다. (SDV(데이터 가치화))
결론: 3σ는 정규분포의 규칙이지, 모든 데이터의 규칙이 아니다
나는 학생들에게 “3시그마 밖이면 이상하다”는 말을 들으면 두 가지를 되묻게 한다. 이 데이터는 정말 종 모양인가? 그리고 그 기준으로 하루에 몇 번 경보가 울리는가? 370번에 한 번이라는 숫자는 정규분포에서만 믿을 수 있는 숫자다.
참고 자료
- 68-95-99.7 법칙의 확률값(68.27%, 95.45%, 99.73%)은 표준정규분포의 이론값이다.
- 체비셰프 부등식의 보장은 강의노트의 정리를 기준으로 했다.