(분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
통계기초
분포
같은 평균 소득을 가진 두 사회가 있다. 한쪽은 모두가 비슷하게 벌고, 다른 한쪽은 소수가 대부분을 번다. 평균 한 숫자로는 둘을 구별할 수 없다. 이번 주에 다룬 정규분포, 로그정규분포, 포아송분포는 모두 같은 교훈을 준다. 평균을 읽기 전에 분포를 먼저 보라.
같은 평균, 전혀 다른 사회
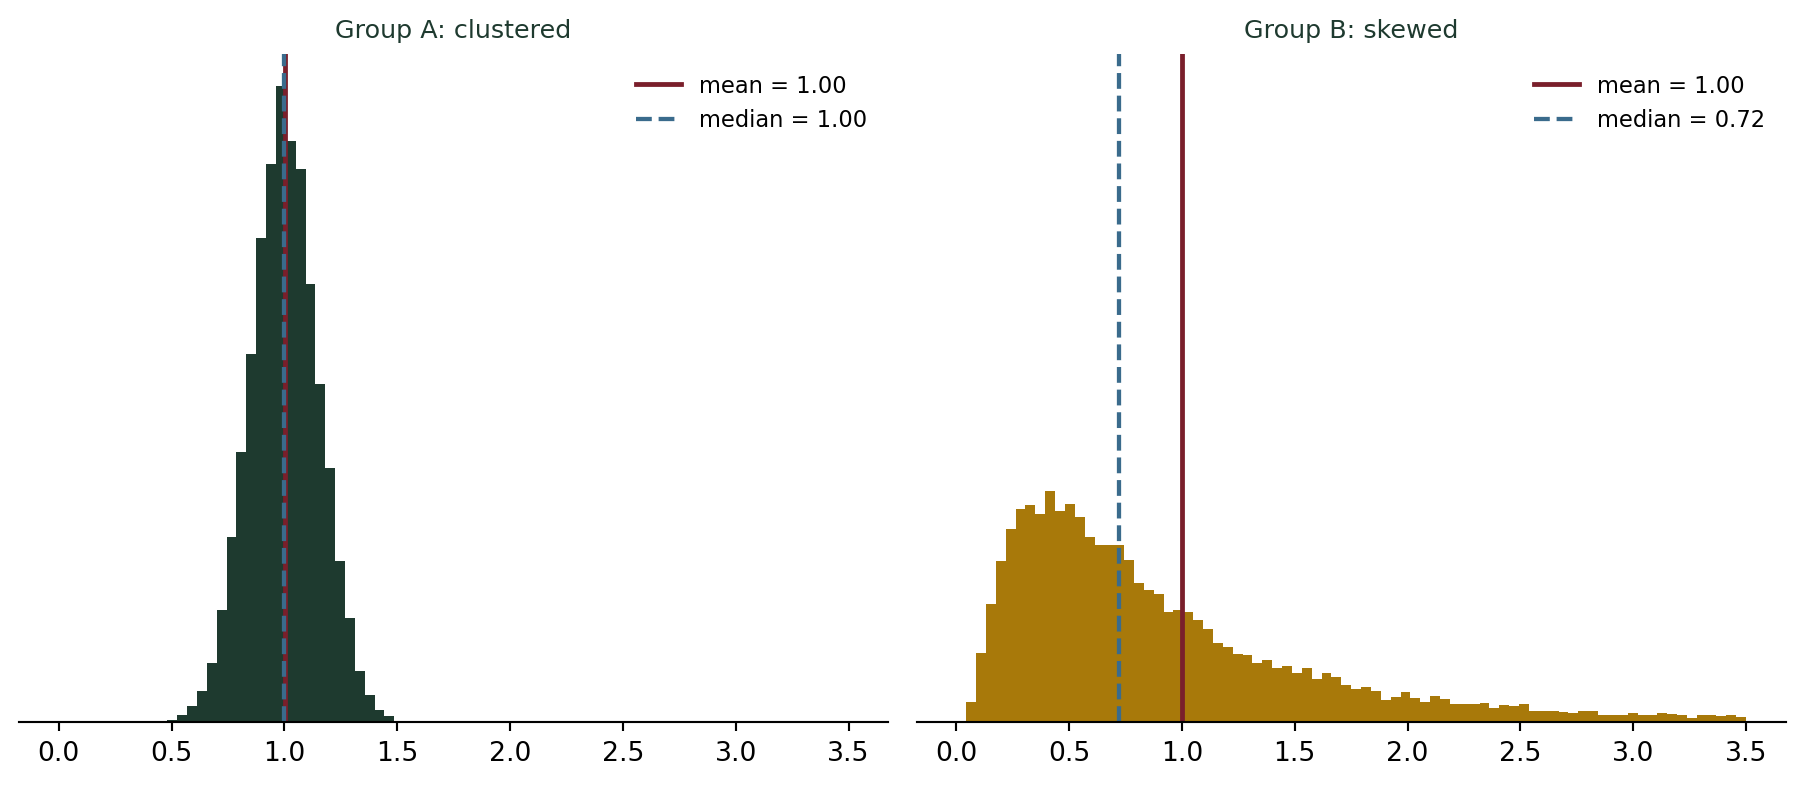
A 마을과 B 마을의 평균 소득이 모두 5,000만 원이라고 하자. A 마을은 대부분 4,000만 원에서 6,000만 원 사이에 몰려 있다. B 마을은 대부분 2,000만 원 근처에서 살고, 소수의 고소득 가구가 평균을 5,000만 원까지 끌어올린다. 뉴스가 “두 마을의 평균 소득이 같다”고 보도하면, 독자는 두 마을이 비슷하다고 믿는다. 그러나 B 마을 주민의 대부분은 평균보다 훨씬 가난하다. 평균은 같지만 분포는 전혀 다르다.
이번 주에 본 네 가지 분포
이번 주 다섯 편의 글은 서로 다른 모양의 분포를 하나씩 살펴보았다. 키는 대칭인 정규분포에 가까워 평균과 중앙값이 거의 같았다. 소득은 곱해져 만들어지는 로그정규분포라서 평균이 중앙값보다 28% 높았다. 3σ 밖의 이상치 비율은 분포 모양에 따라 몇 배씩 달라졌다. 하루 전화 수는 포아송분포를 따라 평균 주변에서 자연스럽게 흔들렸다. 같은 평균 한 숫자가 이렇게 다른 세계를 가릴 수 있다는 점이 핵심이다.
평균과 중앙값, 그리고 “보통의 사람”
두 집단의 평균은 같지만 중앙값은 다르다. 중앙값은 “한가운데 사람”의 값이라서, 치우친 분포에서는 “보통의 사람”을 더 잘 대변한다. 그래서 공식 통계가 소득을 발표할 때 평균과 함께 중앙값을 함께 제시하는 것이다. 평균을 읽을 때는 항상 “이 평균을 만들어낸 분포의 모양은 어떤가?”를 먼저 물어야 한다.
분포를 먼저 보는 습관
분포를 확인하는 일은 복잡한 계산이 아니다. 히스토그램 한 장, 평균과 중앙값 두 숫자, 그리고 “값이 더해져 만들어졌는가, 곱해져 만들어졌는가”라는 질문이면 충분하다. 이번 주 살펴본 모든 도구는 결국 이 습관을 위한 것이었다. 정규분포는 언제 믿을 수 있는지, 로그정규분포는 왜 소득을 로그로 보아야 하는지, 포아송분포는 날마다의 흔들림이 어디까지 정상인지를 알려준다.
평균을 해석하기 전에 확인할 것
- 히스토그램을 먼저 그려라. 숫자 하나보다 그림 한 장이 분포를 더 정확히 보여준다.
- 평균과 중앙값을 나란히 놓아라. 차이가 크면 평균이 소수의 극단값에 끌려가고 있다.
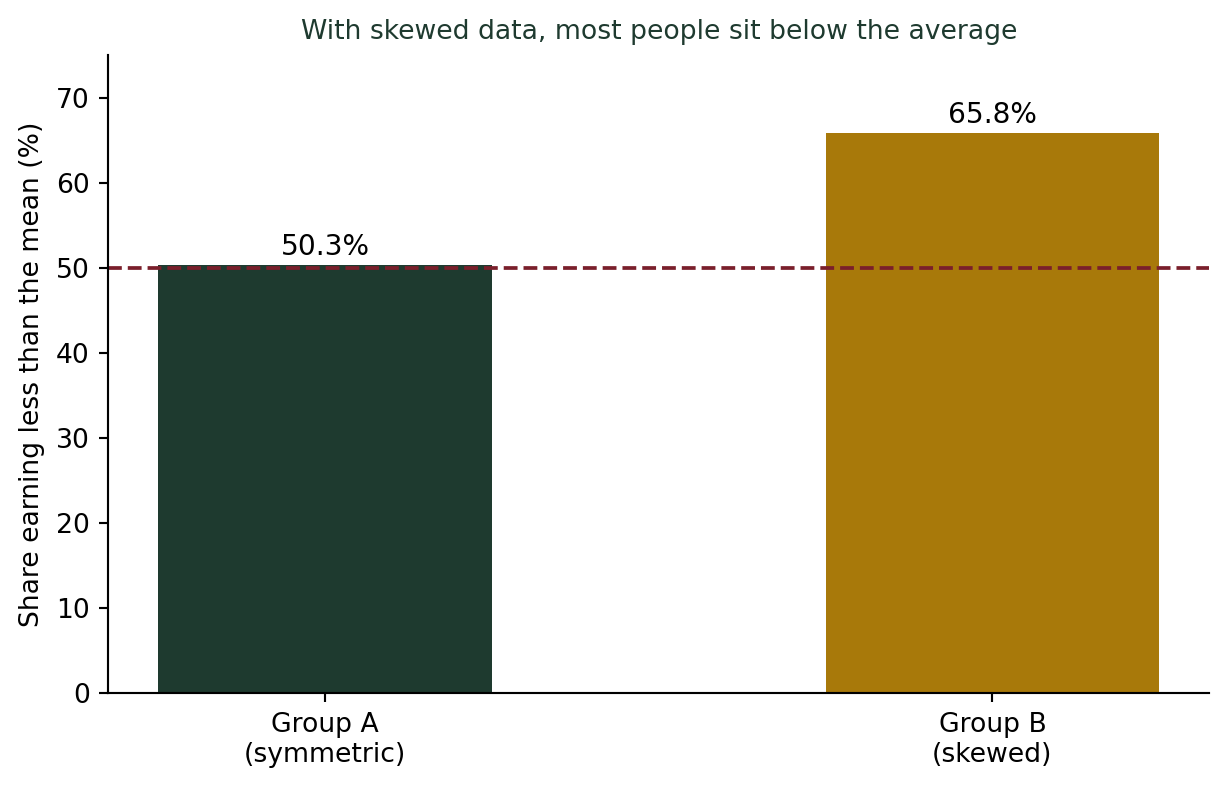
- “평균 이상인 사람은 몇 %인가”를 세어라. 치우친 분포에서는 대부분이 평균 아래에 있다.
- 분포의 폭을 함께 말하라. 표준편차나 분위수 없이 평균만 제시하면 절반의 정보만 전한 것이다.
더 깊이: 기대값과 분포의 관계
강의노트 〈수리통계학 2. 확률변수 — 기대값 정의〉는 확률변수의 기대값을 분포 전체에 가중한 평균으로 정의한다. 평균이 분포의 한 측면일 뿐임을 이해하는 것이 이번 주 이야기의 출발점이다. 평균은 분포의 무게중심을 말해줄 뿐, 그 무게중심 주변에 데이터가 어떻게 놓여 있는지는 말해주지 않는다.
SDV 관점: 평균 대신 분포를 제시하는 보고서가 가치를 만든다
분포를 읽는 일은 요약과 추론(1~2단계)을 넘어, 데이터를 결정의 근거로 바꾸는 SDV(통계적 데이터 가치화)의 출발점이다. 경영 보고서나 정책 자료에서 평균 하나만 제시하면, 듣는 사람은 “대표적인 값”을 떠올리지만 실제로 그 값에 해당하는 사람은 소수일 수 있다. 데이터에 가치를 더하는 통계학자는 평균과 함께 분포의 모양, 중앙값, 분위수, 변동의 폭을 보여준다. 그래야 의사결정자가 평균이 말해주는 것과 감추는 것을 함께 보고 판단할 수 있다. (SDV(데이터 가치화))
결론: 평균은 분포를 요약한 한 줄이다
나는 학생들에게 평균이라는 숫자를 보면 “그래서 분포는 어떻게 생겼는데?”라고 되묻게 한다. 같은 평균 5,000만 원도 두 마을의 삶은 전혀 다르다. 분포를 모르고 평균만 읽으면, 우리는 가장 중요한 이야기를 놓치게 된다.
참고 자료
- 두 집단의 비교는 같은 평균을 갖도록 맞춘 가상의 시뮬레이션 자료다.
- 이번 주 키·소득 사례의 기준값은 앞선 글(10월 13일)의 참고 자료를 따른다.