
(비율과 백분율의 함정) 취업률 69.3%, 숫자보다 먼저 분모를 보라
통계기초
기술통계
졸업생 4,417명 중 취업자 2,419명인 대학의 공시 취업률은 69.3%다. 그런데 졸업생 전체를 기준으로 다시 계산하면 55%다. 두 숫자 다 거짓말은 아니다. 분모가 다를 뿐이다.
“취업률 69.3%”라는 문장을 읽는 법
진로 상담을 겸하는 수업에서, 나는 매 학기 학생들에게 우리 학교 취업률 공시 자료를 보여준다. 어느 해 우리 학교의 취업률은 69.3%였다. 학생들 반응은 한결같다. “오, 10명 중 7명은 취업하네요?”
틀렸다고 말하기도, 맞았다고 말하기도 애매하다. 실제로 그해 이 학교의 졸업생은 4,417명, 취업자는 2,419명이었다. 2,419를 4,417로 나누면 55%다. 69.3%라는 숫자는 어디서 나온 걸까?
취업률의 분모에는 이미 뺄셈이 들어 있다
교육부와 대학알리미가 공시하는 대학 취업률은 이렇게 계산된다.
\[\text{취업률(\%)} = \frac{\text{취업자 수}}{\text{졸업자 수} - \text{진학자} - \text{입대자} - \text{외국인 유학생} - \text{취업불가능자}} \times 100\]
왜 이렇게 계산할까
대학원에 진학했거나, 군에 입대했거나, 본국으로 돌아간 외국인 유학생은 애초에 “취업 대상자”가 아니라고 보는 것이 이 통계의 설계 취지다. 아프거나 수감 중이어서 구직 자체가 불가능한 사람도 마찬가지로 분모에서 뺀다. 취업할 의사와 여건이 있는 사람만 놓고 취업 여부를 따지겠다는 논리다.
논리 자체는 이해할 만하다. 문제는 이 “제외”가 분모를 눈에 띄게 줄인다는 데 있다.
같은 졸업생 4,417명, 분모에 따라 달라지는 숫자
앞서 본 학교의 실제 구성을 뜯어보면 이렇다.
초록 막대(취업자 2,419명 + 아직 구직 중인 1,070명)는 분모에 남는다. 주황 막대(대학원 진학 751명, 귀국한 외국인 유학생 177명)는 분모에서 빠진다. 그 결과, 분모는 4,417명이 아니라 3,489명(4,417 − 751 − 177)이 된다.
\[\text{공시 취업률} = \frac{2{,}419}{3{,}489} \times 100 \approx 69.3\%\]

두 숫자 중 어느 쪽도 조작된 값이 아니다. 69.3%는 “취업 의사가 있는 사람 중 취업률”이라는 정의에 충실한 계산이고, 55%는 “졸업생 전체 중 취업 비율”이라는 정의에 충실한 계산이다. 분자(취업자 2,419명)는 똑같은데, 분모의 정의가 다르니 결과도 다르다.
“제외 대상”이 늘어날수록 분모는 더 작아진다
이 계산 방식이 논란이 되는 이유는, 대학이 진학률·입대율을 부풀리거나 “취업불가능자” 인정 범위를 넓게 잡을수록 분모가 작아지고 취업률은 자동으로 올라가기 때문이다. 실제로 대학 취업률 통계의 신뢰성 문제는 학내 언론에서도 여러 차례 지적됐다.
기사 원문이 짚은 지점
“69.3%의 취업률이 졸업자 100명 중 69명이 취업했다는 의미는 아니다.” 학내 언론이 이 통계를 다루며 강조한 문장이다. 취업률이라는 이름 자체가 “졸업생 중 몇 %가 취업했는가”를 뜻한다고 오해하기 쉽지만, 공시 지표는 애초에 다른 질문—“취업 대상자 중 몇 %가 취업했는가”—에 답하도록 설계되어 있다.
실업률도 같은 함정에 빠진다
취업률만 이런 구조를 가진 게 아니다. 매달 통계청이 발표하는 실업률도 계산식 안에 똑같은 “제외”가 들어 있다.
\[\text{실업률(\%)} = \frac{\text{실업자 수}}{\text{경제활동인구 수}} \times 100 = \frac{\text{실업자 수}}{\text{취업자 수} + \text{실업자 수}} \times 100\]
여기서 분모인 경제활동인구는 만 15세 이상 인구 전체가 아니다. 통계청 경제활동인구조사는 조사대상주간(매월 15일이 포함된 1주) 동안 수입이 있는 일을 했으면 취업자로, 일을 하지 않았지만 지난 4주간 적극적으로 구직활동을 했으면 실업자로 분류한다. 문제는 그다음이다. 일도 하지 않고 구직활동도 하지 않은 사람—전업주부, 재학생, 그리고 구직을 포기한 사람—은 비경제활동인구로 분류되어 분모에서 통째로 빠진다.
취업률과 정확히 같은 구조
- 취업률: 진학자·입대자·외국인 유학생 → 분모에서 제외
- 실업률: 구직단념자를 포함한 비경제활동인구 → 분모에서 제외
두 통계 모두 “제외 기준에 걸리는 사람이 많아질수록 분모가 작아지고, 비율은 통계상 나아진 것처럼 보인다”는 같은 취약점을 공유한다.
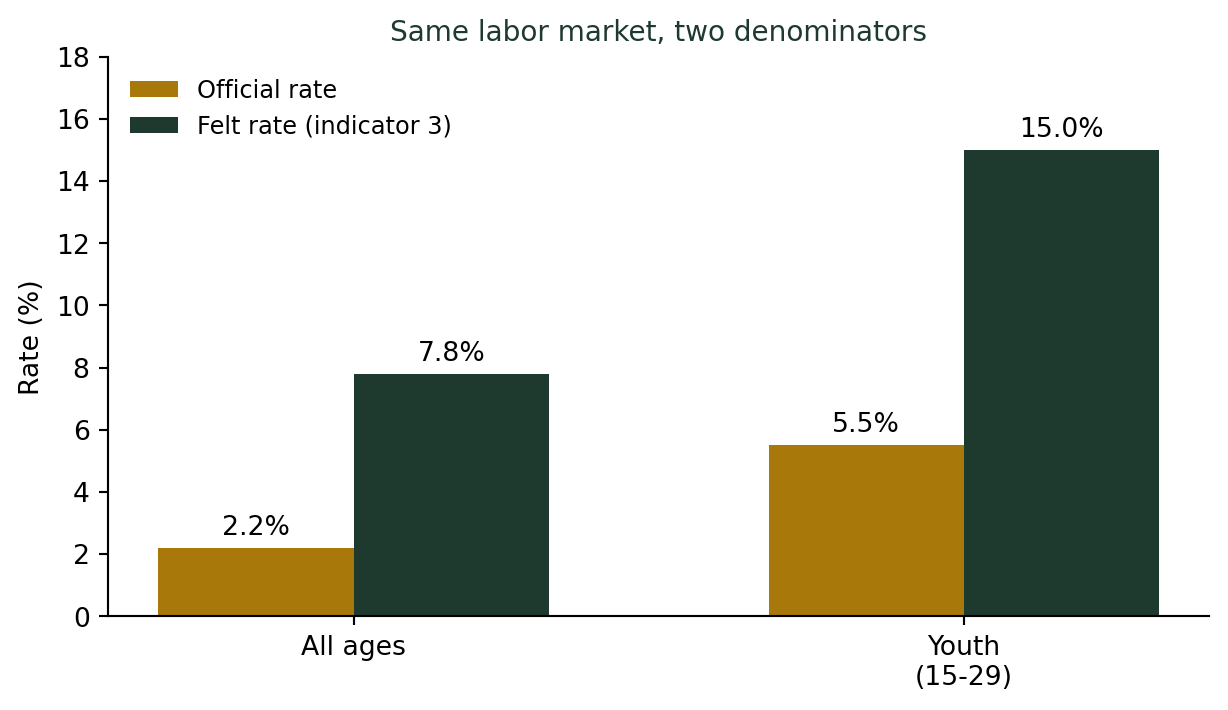
2025년 11월 고용동향을 보면 이 격차가 뚜렷하다. 그달 경제활동인구는 2,970만 6천 명, 실업자는 66만 1천 명으로 공식 실업률은 2.2%였다. 그런데 통계청이 함께 발표하는 고용보조지표3—시간관련 추가취업가능자와 구직단념자를 포함한 잠재경제활동인구까지 반영한, 이른바 “체감실업률”—은 같은 달 7.8%였다. 청년층(15~29세)만 떼어 보면 격차가 더 크다. 공식 청년 실업률은 5.5%인데, 체감실업률은 15%로 거의 세 배다.
“쉬었음” 인구가 늘면 실업률은 오히려 낮아진다
2025년 1월, 20·30대 중 “그냥 쉬었다”고 답한 인구가 72만 명으로 코로나19 이후 최대치를 기록했다. 이들은 구직활동을 하지 않았기 때문에 실업자가 아니라 비경제활동인구로 분류된다. 역설적으로, 구직을 포기하는 사람이 늘어날수록 분모(경제활동인구)가 줄면서 공식 실업률은 오히려 낮아지거나 제자리에 머무를 수 있다. 실제로 2025년 1월 청년층 체감실업률(고용보조지표3)은 16.4%까지 뛰어, 3년 11개월 만에 가장 큰 폭으로 상승했다.
앞서 본 취업률 69.3% 사례와 마찬가지로, 실업률 2.2%라는 숫자 자체가 거짓은 아니다. 다만 “일할 의사와 능력이 있고, 최근 4주간 실제로 구직활동을 한 사람”이라는 좁은 정의 위에 서 있는 숫자일 뿐이다. 체감지표와 공식지표 사이의 간극이 클수록, 분모에서 조용히 빠진 사람이 많다는 뜻이다.
더 깊이: “분모를 다시 정의한다”는 것의 의미
취업률처럼 분모에서 일부를 “제외”하는 방식은, 통계학적으로는 모집단을 재정의하는 것과 같다. 강의노트 〈조사방법론 1. 조사방법론 개요 — 모집단과 프레임〉에서는 조사가 실제로 답하려는 대상인 목표 모집단(target population)과, 조사 설계상 실제로 다루는 조사 모집단(survey population)이 항상 일치하지는 않는다고 설명한다. “졸업생 전체”가 우리 머릿속의 목표 모집단이라면, 취업률 계산에 쓰이는 “제외인정자를 뺀 졸업생”은 조사 설계자가 재정의한 조사 모집단인 셈이다. 이 차이를 모르고 숫자만 보면, 정의가 다른 두 모집단을 같은 것으로 착각하게 된다.
실업률은 이 문제를 지표 설계 단계에서부터 안고 있는 대표 사례이기도 하다. 강의노트 〈통계학의 개념 — 확률 해석의 함정〉은 “측정 지표 오해”를 다루며 정확히 이 사례를 든다. “실업률은 구직 포기자를 제외하므로 과소 추정될 수 있다”는 것이다. 지표 이름이 측정 대상을 정확히 알려준다고 믿는 순간, 우리는 그 지표가 설계 단계에서 이미 빼놓은 사람들을 잊어버린다.
이번 챕터를 관통한 한 문장
비율 통계, 숫자보다 먼저 분모를 보라
이 챕터에서 다룬 사례들은 형태는 달랐지만 결국 같은 질문으로 수렴한다.
- “매출 200% 성장” → 기준값(원래 매출)이 얼마였나?
- “지지율 3%p 상승” → %와 %p, 어느 쪽 분모 위의 이야기인가?
- “위험이 2배” → 상대위험도인가, 원래 발생 확률(절대위험도)인가?
- “인구 1만 명당 범죄율” → 분모(인구)를 반영했는가, 건수만 봤는가?
- “양성 판정 시 감염 확률” → 분모가 되는 유병률은 얼마인가?
- “취업률 69.3%” → 분모에서 누가 빠졌는가?
- “실업률 2.2%” → 구직을 포기한 사람도 분모에 남아 있는가?
분자만 보고 놀라거나 안심하지 마라. 비율을 보면 언제나 먼저 물어야 할 것은 “분모는 무엇인가”다.
나는 이 학교 취업률 통계를 보여줄 때마다 학생들에게 같은 숙제를 낸다. “다음에 어디서든 %를 보면, 3초만 멈춰서 분모를 찾아보세요.” 분모를 찾는 3초가, 숫자에 속지 않는 가장 짧고 확실한 방법이다.