권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • 데이터 플랫폼
  • 유튜브
  1. 📖 (위험 인식과 승부의 확률) 숫자로 검증한 홈어드밴티지 — 홈그라운드의 이점
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고
  • 📖 (위험과 불확실성을 이해하는 법) 비 올 확률 60%는 무슨 뜻인가? — 확률적 예보 읽는 법
  • 📖 (위험과 불확실성을 이해하는 법) 100년 빈도 홍수는 100년에 한 번만 오는가? — 재현빈도의 오해
  • 📖 (위험과 불확실성을 이해하는 법) 보험회사는 어떻게 사고를 예측하는가? — 기대손실
  • 📖 (위험과 불확실성을 이해하는 법) 발생 가능성은 낮지만 피해가 큰 사건을 어떻게 볼 것인가? — 저확률·고피해 리스크
  • 📖 (위험과 불확실성을 이해하는 법) 위험은 확률과 피해 크기의 결합이다 — 위험 평가의 원칙
  • 📖 (확률의 뒷이야기) 문을 바꾸면 정말 유리할까 — 몬티홀 문제
  • 📖 (확률의 뒷이야기) 시행이 많아질수록 진짜 확률에 가까워지는 이유 — 큰 수의 법칙
  • 📖 (확률의 뒷이야기) 벼락 맞을 확률과 나란히 놓아보면 — 로또 1등의 확률
  • 📖 (확률의 뒷이야기) 그럴듯하게 느껴지는 이유 — 혈액형 성격론과 바넘 효과
  • 📖 (확률의 뒷이야기) 우연과 확증편향 사이 — 징크스는 통계적으로 존재할까
  • 📖 (위험 인식과 승부의 확률) 무엇이 더 위험한지 확률로 따져보면 — 비행기 vs 자동차
  • 📖 (위험 인식과 승부의 확률) 절대적 숫자와 상대적 숫자 — 백신 부작용 확률 읽는 법
  • 📖 (위험 인식과 승부의 확률) 확률적 행운이 바꾼 삶 — 복권 당첨자들의 그 후
  • 📖 (위험 인식과 승부의 확률) 먼저 차는 팀이 유리한 이유 — 승부차기의 심리 확률
  • 📖 (위험 인식과 승부의 확률) 숫자로 검증한 홈어드밴티지 — 홈그라운드의 이점

목차

  • “집에서 하면 왠지 더 잘한다”는 느낌, 사실일까
  • 팀마다 홈어드밴티지의 크기가 다르다
  • 반 시즌 성적만 보면 과장되기 쉽다
  • 더 깊이: 승률 차이가 통계적으로 유의한가
  • SDV 관점: “느낌”을 “검증된 패턴”으로 바꾸는 것이 가치화다
  • 결론: 이번 주를 닫으며 — 위험과 승부도 결국 표본의 문제다

(위험 인식과 승부의 확률) 숫자로 검증한 홈어드밴티지 — 홈그라운드의 이점

통계기초
확률
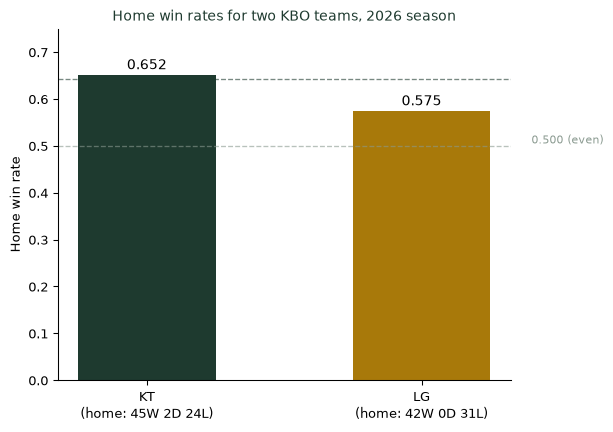
KBO 2026시즌 KT는 홈에서 승률 0.652, 원정을 포함한 전체 승률은 0.642였다. 겨우 1%포인트 차이로 보이지만, 팀마다 그 격차는 다르다. 홈어드밴티지가 ’느낌’이 아니라 숫자로도 존재하는지, 그리고 그 크기는 팀마다 왜 다른지 살펴본다.
Author

권세혁

Published

November 6, 2026

“집에서 하면 왠지 더 잘한다”는 느낌, 사실일까

프로야구를 보다 보면 “역시 홈에서는 뭔가 다르다”는 말을 자주 듣는다. 익숙한 구장, 응원하는 관중, 이동 피로가 없는 몸 상태 — 홈에서 경기하는 팀이 유리할 것 같다는 느낌은 직관적이다. 그런데 이 느낌은 숫자로도 확인될까? 2026시즌 KBO 공식 기록을 보면, KT는 전체 142경기에서 88승 49패 5무(승률 0.642)를 기록했는데, 그중 홈경기 성적만 떼어보면 45승 2무 24패로 승률이 약 0.652였다. 원정 승률보다 약간 높다.

Two KBO teams’ 2026-season win rates, split by home and away games. Both teams won more often at home than their overall season average, though the size of the home edge differs between them.

팀마다 홈어드밴티지의 크기가 다르다

흥미로운 점은 홈어드밴티지의 크기가 팀마다, 시기마다 다르다는 것이다. 스포츠경향 보도에 따르면 LG는 2026시즌 전반기에만 홈경기 승률을 0.698(30승 13패)까지 끌어올렸다. 통산(역대 누적) 기준으로 보면 삼성의 홈 승률은 0.568, LG는 0.531이라는 집계도 있다(공식 기록이 아닌 커뮤니티 집계이므로 참고치로만 다룬다). 시즌 전체로 보면 LG의 홈 승률은 약 0.575 수준이었다. 같은 “홈어드밴티지”라는 말이 팀과 시기에 따라 전혀 다른 크기로 나타난다는 뜻이다.
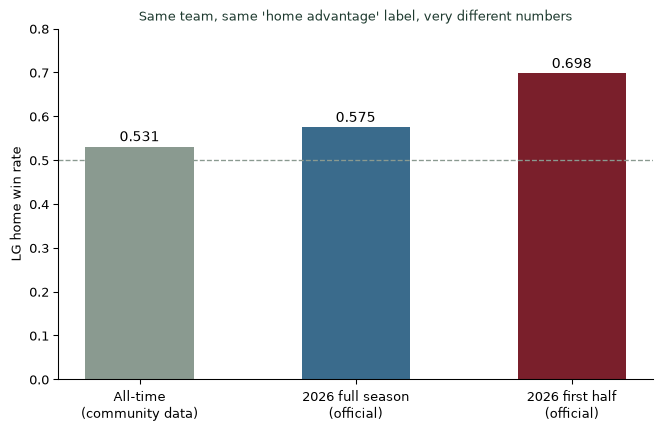
The same team’s home win rate measured over different windows: LG’s all-time historical home win rate (community-compiled, 0.531), its full 2026-season home win rate (official, 0.575), and its first-half-2026-only home win rate (0.698). The ‘home advantage’ for one team varies substantially depending on which stretch of games you measure.

반 시즌 성적만 보면 과장되기 쉽다

LG의 전반기 홈 승률(0.698)과 전체 시즌 홈 승률(0.575)이 크게 차이 나는 이유는, 반 시즌은 표본이 작아서 우연한 연승이 비율에 큰 영향을 주기 때문이다. 앞서 큰 수의 법칙 글에서 본 것과 같은 원리다. 30경기 안팎의 전반기 성적은 표본이 작아 흔들림이 크고, 142경기 전체 시즌이나 수십 년 누적 통산 기록으로 갈수록 그 흔들림은 가라앉는다. “우리 팀 홈에서 진짜 잘한다”는 말을 검증하려면, 반드시 얼마나 많은 경기를 봤는지를 함께 확인해야 한다.

홈어드밴티지 통계를 읽을 때
  1. 측정 구간을 확인하라. 반 시즌, 한 시즌, 통산 기록은 서로 다른 숫자를 준다.
  2. 표본이 작을수록 극단적인 승률이 나오기 쉽다는 걸 기억하라. 전반기만의 0.698은 우연이 섞였을 가능성이 크다.
  3. 공식 기록과 커뮤니티 집계를 구분하라. 출처가 다르면 집계 기준도 다를 수 있다.
  4. “홈에서 유리하다”는 말을 들으면 원정 성적과 나란히 비교하라. 비교 없이는 그 차이가 큰지 작은지 판단할 수 없다.

더 깊이: 승률 차이가 통계적으로 유의한가

강의노트 〈수리통계학 7. 가설검정 — 유의확률〉은 관찰된 차이가 우연만으로 설명되는지를 판단하는 유의확률(p-value) 개념을 다룬다. “홈 승률이 원정보다 1%포인트 높다”는 관찰이 실제 홈어드밴티지를 반영하는지, 아니면 142경기라는 표본에서 우연히 생긴 차이인지는 이 틀로 검증해야 한다. 전반기 30경기만으로 “0.698”이라는 숫자를 내세우는 것은, 유의성 검증 없이 작은 표본의 결과를 과도하게 해석하는 전형적인 예다.

SDV 관점: “느낌”을 “검증된 패턴”으로 바꾸는 것이 가치화다

홈어드밴티지를 숫자로 검증하는 일은 요약과 추론(1~2단계)이지만, 제가 제안하는 SDV(통계적 데이터 가치화) 관점에서는 “다들 그렇게 느낀다”는 직관을 데이터로 확인하거나 반박하는 과정 자체가 가치를 만든다. 구단이 선수 기용이나 마케팅 전략을 “홈에서는 다르다”는 막연한 느낌에 기대어 정하기보다, 충분한 표본과 유의성 검증을 거친 숫자에 기대어 결정할 때 그 데이터는 비로소 결정의 근거가 된다. 통계학자의 역할은 느낌을 부정하는 것이 아니라, 그 느낌이 데이터로도 유지되는지를 가려내는 것이다. (SDV(데이터 가치화))

결론: 이번 주를 닫으며 — 위험과 승부도 결국 표본의 문제다

나는 학생들에게 홈어드밴티지가 존재하느냐고 물으면, “그래서 몇 경기를 보고 하는 말인가요?”로 되묻게 한다. 이번 주 다룬 비행기와 자동차, 백신 부작용, 복권 당첨자, 승부차기, 그리고 오늘의 홈어드밴티지는 모두 같은 질문으로 수렴한다. 무엇을 기준으로, 얼마나 많은 사례로 비교했는가. 위험 인식도 승부의 확률도, 결국 그 질문에 얼마나 정직하게 답하느냐에 달려 있다.

참고 자료
  • 2026시즌 KBO 팀별 경기 기록(KT, LG의 홈/전체 성적)은 KBO 공식 기록 페이지를 참고했다: KBO 팀 순위 — koreabaseball.com
  • LG의 2026시즌 전반기 홈 승률(0.698)은 다음 기사를 참고했다: 홈어드밴티지 실체 있다? 없다?···LG, 홈승률은 만드는 것이다 — 스포츠경향
  • 삼성·LG의 통산 홈 승률(0.568, 0.531)은 커뮤니티 집계 자료를 참고했으며 공식 통계와는 집계 기준이 다를 수 있다.
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08