권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • 데이터 플랫폼
  • 유튜브
  1. 📖 (확률의 뒷이야기) 우연과 확증편향 사이 — 징크스는 통계적으로 존재할까
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고
  • 📖 (위험과 불확실성을 이해하는 법) 비 올 확률 60%는 무슨 뜻인가? — 확률적 예보 읽는 법
  • 📖 (위험과 불확실성을 이해하는 법) 100년 빈도 홍수는 100년에 한 번만 오는가? — 재현빈도의 오해
  • 📖 (위험과 불확실성을 이해하는 법) 보험회사는 어떻게 사고를 예측하는가? — 기대손실
  • 📖 (위험과 불확실성을 이해하는 법) 발생 가능성은 낮지만 피해가 큰 사건을 어떻게 볼 것인가? — 저확률·고피해 리스크
  • 📖 (위험과 불확실성을 이해하는 법) 위험은 확률과 피해 크기의 결합이다 — 위험 평가의 원칙
  • 📖 (확률의 뒷이야기) 문을 바꾸면 정말 유리할까 — 몬티홀 문제
  • 📖 (확률의 뒷이야기) 시행이 많아질수록 진짜 확률에 가까워지는 이유 — 큰 수의 법칙
  • 📖 (확률의 뒷이야기) 벼락 맞을 확률과 나란히 놓아보면 — 로또 1등의 확률
  • 📖 (확률의 뒷이야기) 그럴듯하게 느껴지는 이유 — 혈액형 성격론과 바넘 효과
  • 📖 (확률의 뒷이야기) 우연과 확증편향 사이 — 징크스는 통계적으로 존재할까

목차

  • 수능 전날 미역국을 먹으면 정말 미끄러질까
  • 아무 관계가 없어도, 작은 표본에서는 “맞아떨어진다”
  • 표본이 커지면 우연한 “패턴”은 사라진다
  • 기억은 맞아떨어진 사례만 남긴다
  • 더 깊이: 이항분포로 보는 “우연한 차이”
  • SDV 관점: “효과가 있어 보인다”는 보고는 표본 크기부터 확인하라
  • 결론: 이번 주를 닫으며 — 뒷이야기는 결국 표본과 확률의 문제다

(확률의 뒷이야기) 우연과 확증편향 사이 — 징크스는 통계적으로 존재할까

통계기초
확률
수능 전날 미역국을 먹으면 미끄러진다는 말은 한국에서 가장 널리 퍼진 징크스 중 하나다. 그런데 작은 표본에서는 아무 관계가 없는 두 사건도 우연히 ‘맞아떨어지는’ 경우가 흔하다. 징크스가 끈질기게 살아남는 이유를 이항분포로 들여다본다.
Author

권세혁

Published

October 30, 2026

수능 전날 미역국을 먹으면 정말 미끄러질까

“수능 전날에는 미역국을 먹지 않는다.” 미역이 미끈거려서 시험에 “미끄러진다”는 이 징크스는 한국에서 모르는 사람이 거의 없을 정도로 널리 퍼져 있다. 물론 미역국의 성분이 뇌 기능이나 시험 결과에 영향을 줄 과학적 근거는 없다. 그런데도 이런 징크스는 몇 세대를 거쳐 사라지지 않고 이어진다. 왜 근거 없는 믿음이 이렇게 끈질기게 살아남을까? 답의 절반은 심리학(확증편향)에, 나머지 절반은 통계학(작은 표본에서의 우연)에 있다.

아무 관계가 없어도, 작은 표본에서는 “맞아떨어진다”

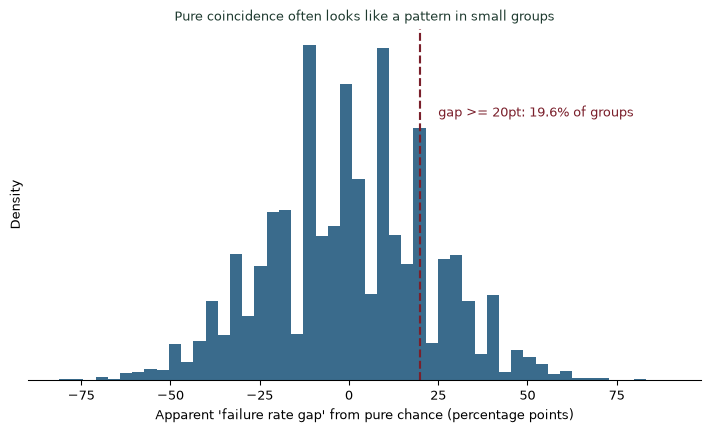
미역국을 먹었는지와 시험 결과 사이에 실제로는 아무 관계가 없다고 가정해 보자. 무작위로 20명을 뽑아, 각자 “미역국을 먹었는가”와 “시험을 못 봤는가”를 동전 던지듯 독립적으로 결정한다고 하자. 이 완전히 무관한 두 사건 사이에서도, 우연히 “미역국 먹은 사람 중에 시험 못 본 비율이 더 높게” 나오는 경우가 얼마나 자주 생길까?

10,000 simulated groups of 20 people, where eating seaweed soup and failing the exam are generated completely independently (50% each, no real connection). The horizontal axis shows the gap in ‘failure rate’ between soup-eaters and non-eaters that shows up purely by chance. A gap of 20 percentage points or more - enough to feel like ‘proof’ of the jinx - appears in a large share of small-sample groups.

시뮬레이션 결과, 두 사건이 완전히 무관해도 20명짜리 집단에서는 꽤 자주 20%포인트 넘는 “차이”가 우연히 나타난다. 누군가 이 우연한 집단 하나를 보고 “거봐, 미역국 먹은 애들이 더 많이 떨어졌잖아”라고 말하면, 듣는 사람은 그럴듯하다고 느낀다.

표본이 커지면 우연한 “패턴”은 사라진다

이 우연한 차이는 표본이 커질수록 빠르게 사라진다. 앞서 큰 수의 법칙에서 본 것과 같은 원리다.
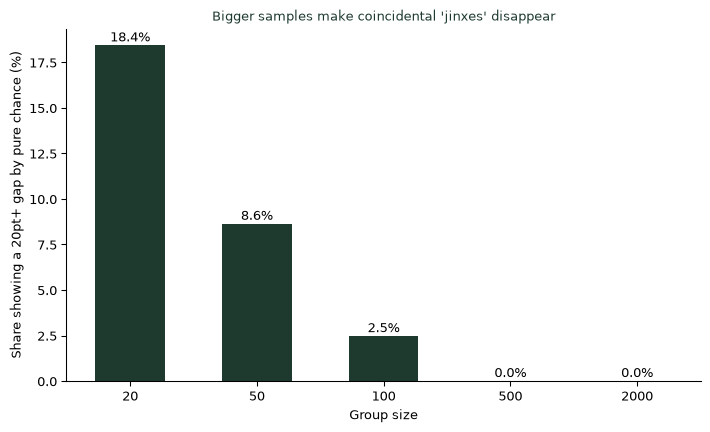
The same simulation repeated at different group sizes. As the sample grows from 20 to 2,000, the share of groups showing a ‘suspicious’ 20-point gap purely by chance collapses toward zero - exactly as the law of large numbers predicts.

징크스는 보통 “내 친구가 미역국 먹고 떨어졌어” 같은 한두 건의 작은 표본(심지어 표본 크기 1)에서 시작된다. 만약 전국의 모든 수험생을 조사한다면, 미역국과 시험 결과 사이의 우연한 “차이”는 거의 사라질 것이다. 하지만 아무도 그렇게 큰 규모로 검증하지 않기 때문에, 작은 표본에서 우연히 생긴 “패턴”이 계속 입에서 입으로 전해진다.

기억은 맞아떨어진 사례만 남긴다

여기에 심리학적 요인이 더해진다. 미역국을 먹고도 시험을 잘 본 사람은 “징크스가 틀렸다”고 굳이 말하고 다니지 않는다. 반면 미역국을 먹고 시험을 망친 사람의 이야기는 “그러게 왜 먹었어”라며 더 잘 회자된다. 이렇게 징크스에 들어맞는 사례만 선택적으로 더 잘 기억되고 더 자주 공유되는 현상이 확증편향이다. 작은 표본의 우연(통계)과 맞아떨어지는 사례만 기억하는 경향(심리)이 합쳐지면, 근거 없는 믿음도 세대를 거쳐 살아남는다.

징크스를 마주할 때 확인할 것
  1. 그 “증거”가 몇 명/몇 번의 사례에 근거하는지 물어라. 표본이 작을수록 우연한 “맞아떨어짐”이 흔하다.
  2. 반대 사례는 없는지 찾아보라. 미역국을 먹고도 잘 본 사람은 기억에서 쉽게 빠진다.
  3. 표본을 키우면 그 패턴이 사라지는지 생각해보라. 전국 단위로 보면 대부분의 징크스는 통계적으로 유의하지 않다.
  4. 징크스를 지키는 행동 자체가 해롭지 않다면, 굳이 반박할 필요는 없다. 다만 “통계적으로 증명됐다”고 믿지는 말아야 한다.

더 깊이: 이항분포로 보는 “우연한 차이”

강의노트 〈수리통계학 5. 유명분포 — 이항분포〉는 성공 확률이 \(p\)로 고정된 독립시행을 \(n\)번 반복했을 때 성공 횟수의 분포를 이항분포로 정의한다. 오늘 시뮬레이션에서 “미역국을 먹은 사람 중 몇 명이 떨어졌는가”는 정확히 이항분포를 따르는 확률변수이고, 표본이 작을수록 이 확률변수의 흔들림(표준편차)이 비율 자체보다 커지기 쉬워 우연한 “차이”가 쉽게 발생한다.

SDV 관점: “효과가 있어 보인다”는 보고는 표본 크기부터 확인하라

징크스의 통계적 정체를 파악하는 일은 요약과 추론(1~2단계)을 넘어, SDV(통계적 데이터 가치화) 관점에서 모든 “효과가 있었다”는 보고를 검증하는 절차와 직결된다. 신제품 캠페인 후 매출이 늘었다거나, 특정 조치 후 이탈률이 줄었다는 보고도, 표본(기간·대상)이 작으면 미역국 징크스와 똑같은 우연일 수 있다. 데이터에 가치를 더하려면, “효과가 있어 보인다”는 결론을 내리기 전에 그 효과가 우연히 나타날 확률이 얼마인지부터 계산해야 한다. 표본을 늘리거나 반복 검증을 거치지 않은 “효과”는, 좋은 징크스 이야기와 다르지 않다. (SDV(데이터 가치화))

결론: 이번 주를 닫으며 — 뒷이야기는 결국 표본과 확률의 문제다

나는 학생들에게 징크스를 비웃지 말고, 그것이 왜 끈질긴지를 통계로 설명해 보라고 말한다. 이번 주 다룬 몬티홀 문제, 큰 수의 법칙, 로또와 벼락, 바넘 효과, 그리고 오늘의 징크스는 모두 하나의 메시지로 모인다. 직관과 기억은 작은 표본과 선택적 기억에 쉽게 속지만, 충분히 큰 표본과 정직한 계산은 결국 우연과 진짜 패턴을 갈라낸다.

참고 자료
  • 수능 전날 미역국을 먹지 않는 풍습은 한국에서 널리 알려진 문화적 속설이며, 과학적 인과관계가 입증된 바는 없다.
  • 시뮬레이션 수치는 설명을 위한 가상의 자료다.
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08