권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • 데이터 플랫폼
  • 유튜브
  1. 📖 (우연을 다루는 더 깊은 생각) 우연과 필연 사이 — 확률적 사고를 마무리하며
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고
  • 📖 (위험과 불확실성을 이해하는 법) 비 올 확률 60%는 무슨 뜻인가? — 확률적 예보 읽는 법
  • 📖 (위험과 불확실성을 이해하는 법) 100년 빈도 홍수는 100년에 한 번만 오는가? — 재현빈도의 오해
  • 📖 (위험과 불확실성을 이해하는 법) 보험회사는 어떻게 사고를 예측하는가? — 기대손실
  • 📖 (위험과 불확실성을 이해하는 법) 발생 가능성은 낮지만 피해가 큰 사건을 어떻게 볼 것인가? — 저확률·고피해 리스크
  • 📖 (위험과 불확실성을 이해하는 법) 위험은 확률과 피해 크기의 결합이다 — 위험 평가의 원칙
  • 📖 (확률의 뒷이야기) 문을 바꾸면 정말 유리할까 — 몬티홀 문제
  • 📖 (확률의 뒷이야기) 시행이 많아질수록 진짜 확률에 가까워지는 이유 — 큰 수의 법칙
  • 📖 (확률의 뒷이야기) 벼락 맞을 확률과 나란히 놓아보면 — 로또 1등의 확률
  • 📖 (확률의 뒷이야기) 그럴듯하게 느껴지는 이유 — 혈액형 성격론과 바넘 효과
  • 📖 (확률의 뒷이야기) 우연과 확증편향 사이 — 징크스는 통계적으로 존재할까
  • 📖 (위험 인식과 승부의 확률) 무엇이 더 위험한지 확률로 따져보면 — 비행기 vs 자동차
  • 📖 (위험 인식과 승부의 확률) 절대적 숫자와 상대적 숫자 — 백신 부작용 확률 읽는 법
  • 📖 (위험 인식과 승부의 확률) 확률적 행운이 바꾼 삶 — 복권 당첨자들의 그 후
  • 📖 (위험 인식과 승부의 확률) 먼저 차는 팀이 유리한 이유 — 승부차기의 심리 확률
  • 📖 (위험 인식과 승부의 확률) 숫자로 검증한 홈어드밴티지 — 홈그라운드의 이점
  • 📖 (우연을 다루는 더 깊은 생각) 오늘 날씨가 내일 날씨에 미치는 영향 — 마르코프 체인 쉽게 이해하기
  • 📖 (우연을 다루는 더 깊은 생각) 복잡한 사건을 가지 치듯 풀어내기 — 확률나무 그려보기
  • 📖 (우연을 다루는 더 깊은 생각) 컴퓨터로 확률을 추정하는 법 — 몬테카를로 시뮬레이션이란
  • 📖 (우연을 다루는 더 깊은 생각) 확률이 낮아도 불가능은 아니다 — 무한 원숭이 정리
  • 📖 (우연을 다루는 더 깊은 생각) 우연과 필연 사이 — 확률적 사고를 마무리하며

목차

  • 우연과 필연, 그 사이 어딘가
  • 8주 동안 배운 것들을 한 장으로
  • 8주의 여정을 돌아보며
  • 우연은 계산으로 길들일 수 있다, 완전히는 아니지만
  • 더 깊이: 이 챕터가 기댄 하나의 틀, 조건부확률
  • SDV 관점: 확률적 사고는 데이터 가치화의 첫 번째 언어다
  • 결론: 우연과 필연 사이에서, 다음 장으로

(우연을 다루는 더 깊은 생각) 우연과 필연 사이 — 확률적 사고를 마무리하며

통계기초
확률
1970년 생물학자 자크 모노는 《우연과 필연》에서 생명의 진화를 우연과 필연의 긴장으로 설명했다. 지난 8주, 40편의 글로 다룬 확률의 세계도 결국 같은 긴장이었다. 생일 문제부터 몬테카를로 시뮬레이션까지, 우연을 계산 가능한 언어로 바꾸는 여정을 돌아본다.
Author

권세혁

Published

November 13, 2026

우연과 필연, 그 사이 어딘가

1970년 프랑스의 분자생물학자 자크 모노는 《우연과 필연(Le Hasard et la Nécessité)》이라는 책에서, 생명의 진화가 순수한 우연(무작위 돌연변이)과 필연(자연선택이라는 법칙) 사이의 긴장 속에서 일어난다고 설명했다. 지난 8주, 40편에 걸친 이 “확률과 우연의 세계” 챕터도 결국 같은 질문을 다른 얼굴로 반복해 왔다. 겉보기에 순전히 운처럼 보이는 일도, 계산해보면 필연에 가까운 구조를 갖고 있다는 것이다.

8주 동안 배운 것들을 한 장으로

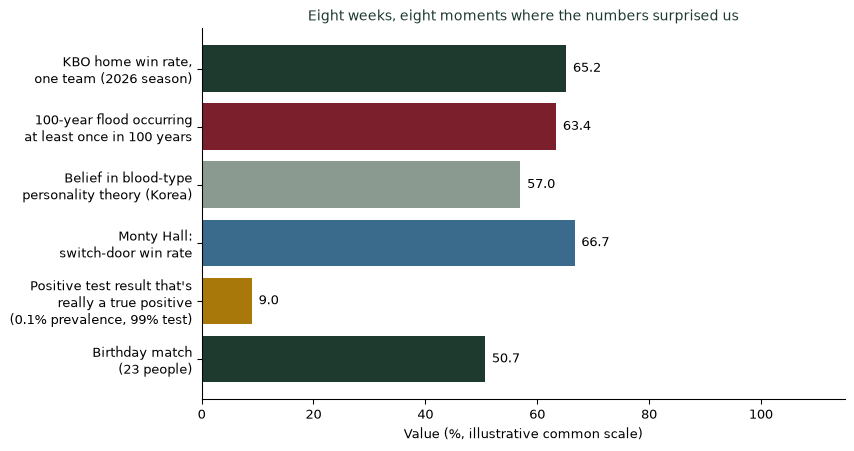
생일이 겹칠 확률이 50%를 넘는 것도(23명), 로또 1등과 번개가 연간 기준으로는 거의 같은 확률을 갖는 것도(1/814만 vs 1/834만), 몬티홀 문제에서 문을 바꾸면 승률이 두 배가 되는 것도(66.7%), 여론조사가 1,000명으로 ±3.1%포인트의 오차를 갖는 것도 — 모두 “느낌”이 아니라 계산으로 답이 정해지는 문제였다.

A recap of eight headline numbers from this chapter’s weeks, each one a moment where careful calculation overturned or sharpened a first intuition. From a 50.7% chance of a shared birthday among 23 people to a 66.7% win rate from switching doors in the Monty Hall problem.

이 숫자들의 공통점은, 처음 직관으로 짐작한 값과 실제로 계산한 값이 달랐다는 것이다. 23명이 모이면 “설마 생일이 겹칠까”라고 생각하지만 실제로는 절반 넘게 겹친다. 몬티홀 문제에서는 “반반이겠지”라고 생각하지만 바꾸는 쪽이 두 배 유리하다. 확률적 사고를 배운다는 것은, 이 간극을 메우는 계산법을 익히는 일이었다.

8주의 여정을 돌아보며
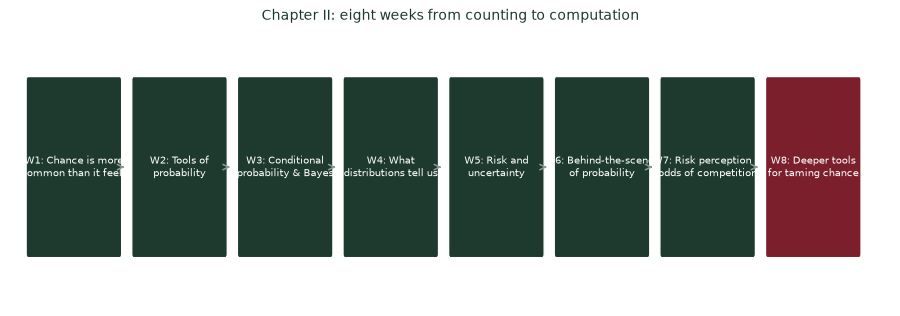
The eight-week arc of this chapter, from the basic tools of probability to the deeper machinery of chance. Each week built on the last: counting and independence gave way to distributions, then to risk, then to the psychology of chance, and finally to the computational tools (Markov chains, Monte Carlo) used to tame it all.

1주차는 생일 문제와 로또 명당처럼 “우연이 생각보다 흔하다”는 사실로 시작했다. 2주차에서는 표본공간, 여사건, 독립, 기댓값이라는 기본 도구를 갖췄다. 3주차는 기저율과 베이즈 규칙으로 “조건이 바뀌면 확률도 바뀐다”는 것을 배웠다. 4주차는 정규분포·포아송분포 같은 분포의 모양을 살폈고, 5주차는 그 분포를 위험과 불확실성에 적용했다. 6주차는 몬티홀 문제와 바넘 효과처럼 확률이 직관을 배신하는 순간들을, 7주차는 위험 인식과 승부의 확률을 다뤘다. 그리고 이번 8주차에서는 마르코프 체인과 몬테카를로 시뮬레이션이라는, 더 깊은 계산 도구로 마무리했다.

우연은 계산으로 길들일 수 있다, 완전히는 아니지만

이 챕터 전체를 관통하는 메시지가 있다면 이것이다. 우연처럼 보이는 것의 상당수는 사실 계산 가능한 구조를 갖고 있다. 생일이 겹치는 것, 승부차기에서 먼저 차는 쪽이 유리한 것, 여론조사 오차가 표본 크기의 제곱근에 반비례하는 것 — 이들은 신비로운 운이 아니라 셀 수 있고 예측할 수 있는 패턴이었다. 그러나 동시에, 무한 원숭이 정리가 보여주듯 “확률이 0이 아니다”와 “현실적으로 일어난다”는 전혀 다른 이야기라는 것도 배웠다. 확률적 사고란 우연을 완전히 없애는 것이 아니라, 우연과 필연 사이 어디쯤에 우리가 서 있는지를 정확히 아는 일이다.

8주를 통과하며 남은 질문들
  1. “이게 우연인가, 구조인가”를 항상 먼저 물어라. 계산해보면 생각보다 많은 “우연”이 구조로 설명된다.
  2. 직관과 계산이 다를 때는 계산을 믿어라. 몬티홀 문제가 보여준 것처럼, 숙련된 사람도 직관만으로는 틀릴 수 있다.
  3. “확률이 0이 아니다”와 “현실적으로 가능하다”를 구분하라. 무한 원숭이 정리가 남긴 경고다.
  4. 다음 장으로 넘어갈 준비: 확률에서 추정으로. 지금까지는 “참값을 안다고 가정하고” 확률을 계산했다면, 다음 장부터는 “참값을 모를 때 데이터로 어떻게 추정할 것인가”를 다룬다.

더 깊이: 이 챕터가 기댄 하나의 틀, 조건부확률

강의노트 〈수리통계학 1. 확률론 — 조건부 확률〉은 이 챕터 전체에서 가장 자주 돌아온 개념이다. 베이즈 규칙도, 마르코프 성질도, 확률나무도 모두 \(P(A\mid B)\)라는 하나의 정의에서 뻗어 나온 가지였다. 8주의 여정을 하나의 수식으로 요약한다면, 바로 이 조건부확률의 정의다.

SDV 관점: 확률적 사고는 데이터 가치화의 첫 번째 언어다

8주간 다룬 확률적 사고는 제가 제안하는 SDV(통계적 데이터 가치화)의 가장 밑바탕에 있는 언어다. 요약(1단계)과 추론(2단계)은 확률이라는 공통 언어 없이는 성립하지 않고, 그 위에 쌓이는 학습(3단계)·융합(4단계)·가치화(5단계) 역시 결국 “불확실성을 숫자로 다루는 능력”에서 출발한다. AI가 아무리 계산을 빠르게 대신해 주더라도, 그 계산이 무엇을 묻고 있는지, 그 답이 어떤 조건 위에 서 있는지를 판단하는 것은 여전히 사람의 몫이다. 이 챕터에서 다진 확률적 사고는, 앞으로 이어질 추정과 검정, 그리고 데이터 가치화의 모든 단계를 받치는 토대다. (SDV(데이터 가치화))

결론: 우연과 필연 사이에서, 다음 장으로

나는 학생들에게 이 챕터를 마치며 이렇게 말한다. 세상에 완전한 우연도, 완전한 필연도 드물다. 대부분의 일은 그 둘 사이 어딘가에 있고, 확률은 바로 그 “사이”를 측정하는 도구다. 8주 동안 우리는 그 도구를 여러 각도에서 써 봤다. 다음 장에서는 이 도구를 들고, “참값을 모를 때 데이터로 무엇을 말할 수 있는가”라는 새로운 질문으로 넘어간다.

참고 자료
  • 자크 모노(Jacques Monod), 《우연과 필연(Le Hasard et la Nécessité)》(1970) — 생명의 진화를 우연과 필연의 긴장으로 설명한 고전.
  • 이번 글의 “8주 요약” 차트에 쓰인 숫자들은 모두 이 챕터의 앞선 글들에서 이미 계산되고 출처를 밝힌 값을 다시 인용한 것이다.
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08