권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • 데이터 플랫폼
  • 유튜브
  1. 📖 (위험과 불확실성을 이해하는 법) 100년 빈도 홍수는 100년에 한 번만 오는가? — 재현빈도의 오해
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고
  • 📖 (위험과 불확실성을 이해하는 법) 비 올 확률 60%는 무슨 뜻인가? — 확률적 예보 읽는 법
  • 📖 (위험과 불확실성을 이해하는 법) 100년 빈도 홍수는 100년에 한 번만 오는가? — 재현빈도의 오해
  • 📖 (위험과 불확실성을 이해하는 법) 보험회사는 어떻게 사고를 예측하는가? — 기대손실
  • 📖 (위험과 불확실성을 이해하는 법) 발생 가능성은 낮지만 피해가 큰 사건을 어떻게 볼 것인가? — 저확률·고피해 리스크
  • 📖 (위험과 불확실성을 이해하는 법) 위험은 확률과 피해 크기의 결합이다 — 위험 평가의 원칙

목차

  • “100년 만의 폭우”가 왜 이렇게 자주 올까
  • 100년을 기다리면 반드시 한 번은 올까
  • 평균 100년, 그런데 절반은 69년 안에 온다
  • 설계 기준으로서의 재현빈도
  • 더 깊이: 기하분포와 대기 시간
  • SDV 관점: 평균 재현기간 대신 전체 확률 곡선을 제시하라
  • 결론: “100년 빈도”는 약속이 아니라 확률이다

(위험과 불확실성을 이해하는 법) 100년 빈도 홍수는 100년에 한 번만 오는가? — 재현빈도의 오해

통계기초
확률
’100년 만의 폭우’가 몇 년 만에 또 온다. 재현기간 100년은 100년을 기다려야 한다는 뜻이 아니라, 해마다 발생 확률이 1%라는 뜻이다. 매년 같은 확률로 주사위를 던지면, 100년 안에 한 번이라도 올 확률은 63%나 된다.
Author

권세혁

Published

October 20, 2026

“100년 만의 폭우”가 왜 이렇게 자주 올까

뉴스에서 “100년 빈도 폭우”라는 말을 몇 년 간격으로 반복해서 듣는다면, 통계가 틀렸다고 느낄 수 있다. 그러나 재현기간(recurrence interval) 100년이라는 말은 “100년에 정확히 한 번 온다”는 뜻이 아니다. 올바른 뜻은 해마다 그 정도 규모의 사건이 발생할 확률이 1%라는 것이다. 매년 똑같이 1%의 확률을 가진 주사위를 던지는 셈이므로, 작년에 왔다고 올해 확률이 낮아지지 않는다. 동전에 “기억”이 없는 것과 같은 이치다.

100년을 기다리면 반드시 한 번은 올까

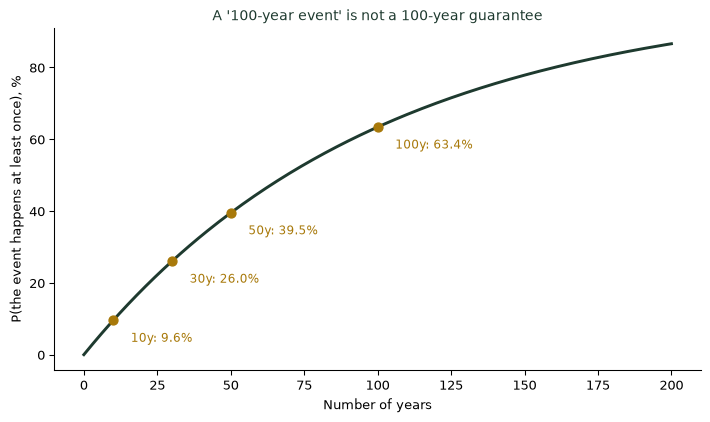
그렇다면 100년을 기다리면 이 사건이 반드시 한 번은 일어날까? 매년 독립적으로 1%의 확률을 가진다고 하면, 100년 안에 한 번도 일어나지 않을 확률은 \((1-0.01)^{100}\approx36.6\%\)다. 따라서 적어도 한 번 일어날 확률은 약 63.4%이고, 100년을 기다려도 세 번 중 한 번 넘게는 한 번도 겪지 않을 수 있다. 반대로 10년만 지나도 이미 9.6%의 확률로 그 사건을 겪는다.

Probability that a ‘100-year’ event (1% chance each year, independent across years) occurs at least once within a given span of years. Even over 100 years, there is only a 63.4% chance of seeing it at least once - and a 9.6% chance already within just 10 years.

평균 100년, 그런데 절반은 69년 안에 온다

재현기간 100년은 “평균적으로 100년에 한 번”이라는 뜻이다. 그런데 이 평균은 분포의 꼬리에 끌려 올라간 값이다. 매년 독립적으로 1%의 확률을 갖는 사건의 대기 시간은 기하분포를 따르고, 그 평균은 정확히 100년이지만 중앙값은 약 69년이다. 절반의 경우, 100년을 다 기다리기 전에 이미 사건이 일어난다는 뜻이다. 평균과 중앙값이 벌어지는 것은 이번 달에 본 소득 분포의 치우침과 같은 이유다 — 드물게 아주 오래 기다리는 경우가 평균을 끌어올린다.
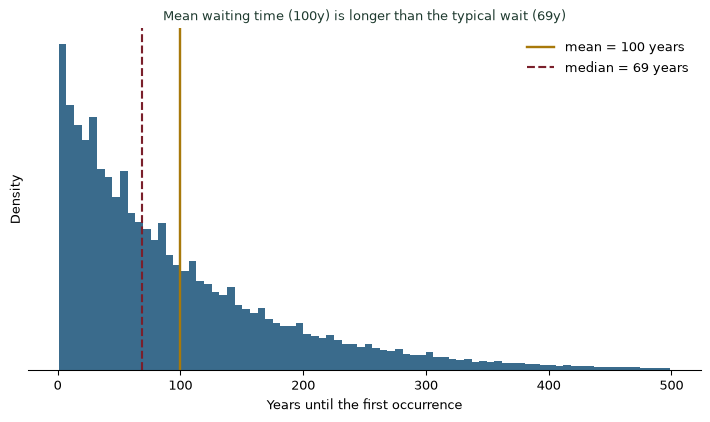
Simulated waiting times until a ‘100-year event’ first occurs (geometric distribution, 1% chance per year). The mean waiting time is 100 years, but the median - the typical experience - is only about 69 years, because a long right tail of rare, very long waits pulls the mean upward.

설계 기준으로서의 재현빈도

국가하천의 제방은 보통 100~200년 빈도, 지방하천과 소하천은 50~200년 빈도로 설계된다. 이는 “그 규모의 홍수를 막을 수 있도록” 만들었다는 뜻이지, 그 홍수가 100년에 한 번만 온다고 보장한다는 뜻이 아니다. 최근에는 기후변화로 과거 기준의 “극단적인” 사건이 더 자주 관측된다는 연구도 나온다. 해수면 상승 연구 중에는 과거 100년에 한 번꼴이던 극단적 현상이 최근에는 평균 8년에 한 번꼴로 나타난다고 보고한 사례도 있다. 이런 변화가 사실이라면, 과거 자료로 추정한 “100년 빈도”라는 숫자 자체를 주기적으로 다시 계산해야 한다는 뜻이 된다.

재현빈도를 읽을 때 확인할 것
  1. “100년에 한 번”을 “매년 1%”로 바꿔 읽어라. 그래야 독립성과 무기억성이 분명해진다.
  2. 평균 대기시간과 중앙값 대기시간을 구분하라. 평균이 중앙값보다 길다는 것은 분포가 치우쳐 있다는 뜻이다.
  3. 설계 기준과 발생 보장을 혼동하지 마라. 설계빈도는 목표치이지 약속이 아니다.
  4. 과거 통계가 현재에도 유효한지 의심하라. 기후나 환경이 바뀌면 “100년 빈도”의 실제 확률도 바뀐다.

더 깊이: 기하분포와 대기 시간

강의노트 〈수리통계학 5. 유명분포 — 기하분포〉는 매 시행마다 확률 \(p\)로 성공하는 독립적인 시행에서, 첫 성공까지 걸리는 시행 횟수를 기하분포로 정의한다. 평균은 \(1/p\), 즉 \(p=0.01\)이면 100이다. 오늘 살펴본 “100년 빈도” 홍수의 평균 대기시간이 바로 이 공식의 결과이며, 지난주 “적어도 하나”의 확률 계산과 같은 뿌리에서 나온 질문이다.

SDV 관점: 평균 재현기간 대신 전체 확률 곡선을 제시하라

재현기간을 정확히 해석하는 일은 요약과 추론(1~2단계)이며, SDV(통계적 데이터 가치화) 관점에서는 재난 대비와 설비 투자의 우선순위를 정하는 문제다. “100년에 한 번”이라는 말만 전달하면 의사결정자는 당장의 위험을 과소평가하기 쉽다. 데이터에 가치를 더하는 보고는 평균 재현기간 한 숫자 대신, 앞으로 10년·30년·50년 안에 발생할 누적 확률 곡선을 함께 제시한다. 그래야 투자 결정이 “먼 미래의 일”이 아니라 “내 임기 안에 벌어질 수 있는 일”로 제대로 평가된다. (SDV(데이터 가치화))

결론: “100년 빈도”는 약속이 아니라 확률이다

나는 학생들에게 “100년 만의 사건”이라는 말을 들으면 “그래서 올해 확률은 몇 %인가”로 바꿔 생각하라고 말한다. 매년 1%의 확률로 반복되는 제비뽑기라면, 100년 안에 세 번 중 두 번 가까이는 그 사건을 만난다. 재현빈도는 안심시키는 숫자가 아니라, 매년 다시 던져지는 확률이다.

참고 자료
  • 재현기간의 정의와 100년 누적 확률(약 63%)은 다음을 참고했다: What is a 100-year Flood? — American Rivers, 홍수 — 위키백과
  • 국내 하천 설계빈도(국가하천 100~200년 등)와 기후변화로 인한 극단현상 빈도 증가 사례는 다음을 참고했다: 일상화된 ‘100년 빈도’ 강우…홍수방어 목표는 현실과 괴리 — 뉴스핌
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08