권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • 데이터 플랫폼
  • 유튜브
  1. 📖 (표본은 어떻게 전체를 말하는가) 전 국민을 조사하지 않아도 되는 이유 — 표본조사
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고
  • 📖 (위험과 불확실성을 이해하는 법) 비 올 확률 60%는 무슨 뜻인가? — 확률적 예보 읽는 법
  • 📖 (위험과 불확실성을 이해하는 법) 100년 빈도 홍수는 100년에 한 번만 오는가? — 재현빈도의 오해
  • 📖 (위험과 불확실성을 이해하는 법) 보험회사는 어떻게 사고를 예측하는가? — 기대손실
  • 📖 (위험과 불확실성을 이해하는 법) 발생 가능성은 낮지만 피해가 큰 사건을 어떻게 볼 것인가? — 저확률·고피해 리스크
  • 📖 (위험과 불확실성을 이해하는 법) 위험은 확률과 피해 크기의 결합이다 — 위험 평가의 원칙
  • 📖 (확률의 뒷이야기) 문을 바꾸면 정말 유리할까 — 몬티홀 문제
  • 📖 (확률의 뒷이야기) 시행이 많아질수록 진짜 확률에 가까워지는 이유 — 큰 수의 법칙
  • 📖 (확률의 뒷이야기) 벼락 맞을 확률과 나란히 놓아보면 — 로또 1등의 확률
  • 📖 (확률의 뒷이야기) 그럴듯하게 느껴지는 이유 — 혈액형 성격론과 바넘 효과
  • 📖 (확률의 뒷이야기) 우연과 확증편향 사이 — 징크스는 통계적으로 존재할까
  • 📖 (위험 인식과 승부의 확률) 무엇이 더 위험한지 확률로 따져보면 — 비행기 vs 자동차
  • 📖 (위험 인식과 승부의 확률) 절대적 숫자와 상대적 숫자 — 백신 부작용 확률 읽는 법
  • 📖 (위험 인식과 승부의 확률) 확률적 행운이 바꾼 삶 — 복권 당첨자들의 그 후
  • 📖 (위험 인식과 승부의 확률) 먼저 차는 팀이 유리한 이유 — 승부차기의 심리 확률
  • 📖 (위험 인식과 승부의 확률) 숫자로 검증한 홈어드밴티지 — 홈그라운드의 이점
  • 📖 (우연을 다루는 더 깊은 생각) 오늘 날씨가 내일 날씨에 미치는 영향 — 마르코프 체인 쉽게 이해하기
  • 📖 (우연을 다루는 더 깊은 생각) 복잡한 사건을 가지 치듯 풀어내기 — 확률나무 그려보기
  • 📖 (우연을 다루는 더 깊은 생각) 컴퓨터로 확률을 추정하는 법 — 몬테카를로 시뮬레이션이란
  • 📖 (우연을 다루는 더 깊은 생각) 확률이 낮아도 불가능은 아니다 — 무한 원숭이 정리
  • 📖 (우연을 다루는 더 깊은 생각) 우연과 필연 사이 — 확률적 사고를 마무리하며
  • 📖 (표본은 어떻게 전체를 말하는가) 국 한 숟가락으로 냄비 전체의 맛을 알 수 있을까? — 표본조사의 비유
  • 📖 (표본은 어떻게 전체를 말하는가) 전 국민을 조사하지 않아도 되는 이유 — 표본조사
  • 📖 (표본은 어떻게 전체를 말하는가) 표본이 크면 언제나 정확할까? — 표본 크기의 함정
  • 📖 (표본은 어떻게 전체를 말하는가) 빅데이터가 대표성 문제를 해결하지 못하는 이유 — 많다고 대표성이 생기진 않는다
  • 📖 (표본은 어떻게 전체를 말하는가) 표본의 크기보다 뽑는 방법이 중요하다 — 표본추출 방법의 중요성

목차

  • 5년에 한 번만 다 세고, 나머지는 표본으로 본다
  • 왜 0.18%로 충분할까
  • 전수조사가 필요한 순간도 있다
  • 더 깊이: 모집단과 데이터의 관계
  • SDV 관점: 전수조사의 환상보다 설계된 표본이 더 가치 있다
  • 결론: 다 세지 않아도 알 수 있다

(표본은 어떻게 전체를 말하는가) 전 국민을 조사하지 않아도 되는 이유 — 표본조사

통계기초
표본조사
한국의 실업률은 매달 발표되지만, 5천만 명 전체에게 전화를 거는 게 아니다. 통계청(국가데이터처)은 전국 약 3만 6천 가구, 전체 가구의 0.18%만 조사해 그 수치를 낸다. 전수조사와 표본조사는 왜 둘 다 필요하고, 왜 대부분의 통계는 후자로 충분할까?
Author

권세혁

Published

November 17, 2026

5년에 한 번만 다 세고, 나머지는 표본으로 본다

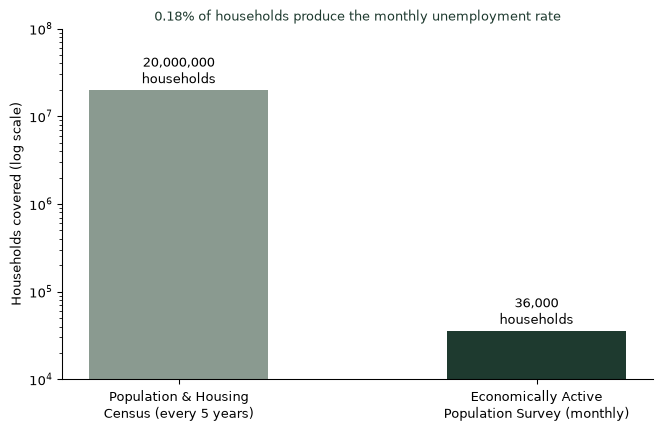
한국의 모든 가구와 인구를 하나하나 빠짐없이 세는 조사가 있다. 인구주택총조사다. 이 조사는 5년마다 한 번, 국내에 거주하는 모든 사람을 대상으로 한다. 그런데 “실업률이 몇 %다”, “물가가 몇 % 올랐다” 같은 수치는 매달, 심지어 매주 발표된다. 5천만 명을 매달 다시 다 조사하는 걸까? 아니다. 매달 발표되는 실업률은 경제활동인구조사라는 표본조사에서 나온다. 국가데이터처(옛 통계청)는 전국 1,791개 조사구에서 약 3만 6천 가구를 뽑아 매달 조사한다. 전국 가구 수가 약 2천만 가구라는 점을 생각하면, 이는 전체의 약 0.18%에 불과하다.

Korea’s Population and Housing Census (a full enumeration, conducted every 5 years) versus the monthly Economically Active Population Survey (a sample survey): the sample covers only about 0.18% of the roughly 20 million households nationwide, yet it produces the monthly unemployment rate the whole country relies on.

왜 0.18%로 충분할까

지난주 다룬 큰 수의 법칙이 답이다. 표본이 무작위로(또는 알려진 체계적 방식으로) 뽑히기만 하면, 표본 비율은 표본 크기가 커질수록 모집단의 실제 비율에 빠르게 가까워진다. 중요한 것은 “몇 퍼센트를 조사했는가”가 아니라 “표본이 모집단을 고르게 대표하는가”다. 실제로 표본 크기와 오차의 관계를 계산해보면, 표본을 1,000명에서 3만 6천 명으로 늘려도 오차가 그렇게까지 더 줄지는 않는다 — 이미 충분히 작아진 오차를 조금 더 줄이는 데는 훨씬 큰 표본이 필요하다는, 10월에 다룬 여론조사 글의 결론과 같은 원리다.
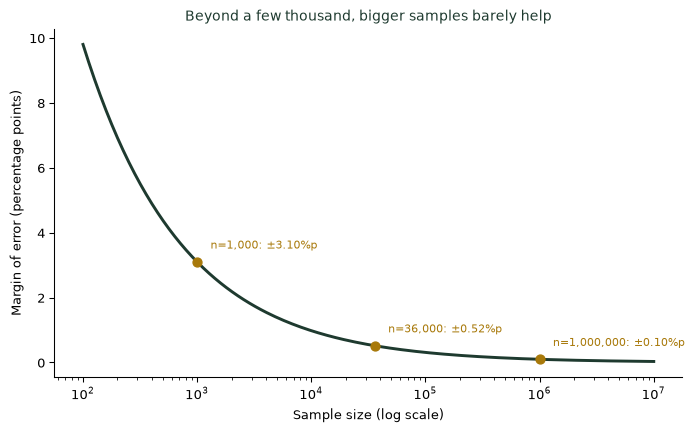
Margin of error for a proportion estimate (95% confidence) as sample size grows from 100 to 10 million, regardless of the population size (fixed at roughly 50 million). Past a few thousand respondents, adding millions more barely tightens the estimate further - which is why a 36,000-household sample is enough, and a full census of 20 million households is not needed every month.

전수조사가 필요한 순간도 있다

그렇다고 전수조사가 필요 없다는 뜻은 아니다. 인구주택총조사처럼 동 단위, 리 단위의 아주 세밀한 지역별 숫자가 필요하거나, 법적으로 “빠짐없이” 세야 하는 선거인명부 같은 경우에는 표본조사로 대신할 수 없다. 표본조사는 “전국 평균이 얼마인가”를 묻는 질문에는 강하지만, “우리 동네에 몇 명이 사는가”처럼 아주 작은 단위를 묻는 질문에는 답하기 어렵다. 그래서 두 방법은 경쟁 관계가 아니라, 서로 다른 질문에 쓰이는 보완 관계다.

전수조사와 표본조사를 구분하는 법
  1. 질문의 단위를 확인하라. 전국 평균이면 표본조사로 충분하고, 동네 단위의 숫자가 필요하면 전수조사가 필요할 수 있다.
  2. “몇 퍼센트를 조사했는가”에 집착하지 마라. 중요한 것은 비율이 아니라 표본이 뽑힌 방식이다.
  3. 얼마나 자주 필요한지 생각하라. 매달 필요한 숫자를 5년마다 하는 전수조사로 대신할 수는 없다.
  4. 표본조사의 결과에는 항상 오차 범위가 따라온다는 것을 기억하라. 전수조사와 달리 표본조사는 “추정”이다.

더 깊이: 모집단과 데이터의 관계

강의노트 〈수리통계학 4. 표본분포 — 데이터와 모집단〉은 우리가 실제로 손에 쥐는 데이터(표본)와, 알고 싶지만 전부 들여다볼 수 없는 모집단의 관계를 정의한다. 경제활동인구조사의 3만 6천 가구는 데이터이고, 전국 2천만 가구의 고용 상태는 우리가 알고 싶은 모집단이다. 표본조사의 모든 이론은 이 둘을 잇는 다리를 놓는 작업이다.

SDV 관점: 전수조사의 환상보다 설계된 표본이 더 가치 있다

전수조사와 표본조사를 구분하는 일은 요약과 추론(1~2단계)의 기초이며, SDV(통계적 데이터 가치화) 관점에서는 데이터 수집에 들어가는 비용과 얻는 가치를 저울질하는 문제다. “모든 고객에게 설문을 돌리자”는 제안은 그럴듯해 보이지만, 응답률이 낮고 특정 성향의 고객만 응답하면 오히려 잘 설계된 작은 표본보다 못한 결과를 낳는다. 데이터에 가치를 더하는 일은 “다 조사했다”는 안심이 아니라, “제대로 설계된 일부로도 충분히 믿을 만하다”는 근거를 만드는 데 있다. (SDV(데이터 가치화))

결론: 다 세지 않아도 알 수 있다

나는 학생들에게 매달 발표되는 실업률을 보면 “저게 몇 명을 조사한 결과인지” 떠올려보라고 말한다. 3만 6천 가구, 전체의 0.18%가 5천만 명의 고용 상태를 매달 알려준다. 전 국민을 조사하지 않아도 되는 이유는 게을러서가 아니라, 잘 설계된 표본이 그만큼 강력하기 때문이다.

참고 자료
  • 경제활동인구조사의 표본 규모(전국 1,791개 조사구, 약 3만 6천 가구)는 국가통계포털(KOSIS) 메타데이터를 참고했다.
  • 전국 가구 수(약 2천만 가구)는 근사값이다.
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08