(표본은 어떻게 전체를 말하는가) 표본이 크면 언제나 정확할까? — 표본 크기의 함정
통계기초
표본조사
1936년 미국 대선을 앞두고 한 잡지사는 240만 명에게 설문해 ’랜던 후보 압승’을 예측했다. 그런데 갤럽은 겨우 5만 명을 조사해 정반대 결과를 맞혔다. 표본이 48배나 작았는데 오히려 더 정확했던 이유는, 표본의 크기가 아니라 뽑는 방식에 있었다.
240만 명을 조사하고도 완전히 틀렸다
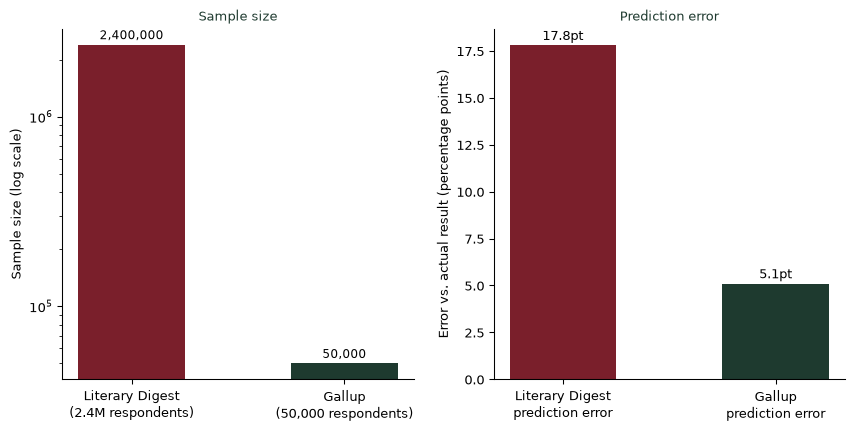
1936년 미국 대선을 앞두고, 당시 유력 잡지였던 《리터러리 다이제스트(Literary Digest)》는 무려 1,000만 명에게 설문지를 보내 240만 명의 응답을 받았다. 이 거대한 표본을 근거로 잡지는 공화당의 알프 랜던 후보가 57%, 현직 대통령 프랭클린 루스벨트가 43%를 얻어 랜던이 압승할 것이라 예측했다. 그런데 실제 선거 결과는 루스벨트가 60.8%를 얻어 압도적으로 승리했다. 240만 명이라는 거대한 표본이 완전히 빗나간 것이다.
5만 명짜리 작은 표본이 더 정확했다
같은 해, 신생 여론조사 기관을 운영하던 조지 갤럽은 겨우 5만 명을 조사해 루스벨트의 승리를 정확히 예측했다(그의 추정치는 55.7%로, 실제 득표율보다는 낮았지만 승자는 정확히 맞혔다). 표본 크기는 리터러리 다이제스트의 약 48분의 1에 불과했는데도, 갤럽의 예측이 훨씬 정확했다.
리터러리 다이제스트의 예측 오차는 약 18%포인트에 달했지만, 갤럽의 오차는 5%포인트에 그쳤다. 표본이 48배 작았는데도 오차는 오히려 훨씬 작았다.
무엇이 잘못됐을까 — 명단 자체가 편향되어 있었다
문제는 표본의 크기가 아니라 누구를 조사했는가에 있었다. 리터러리 다이제스트는 설문 대상을 전화번호부, 자동차 등록 명단, 잡지 구독자 명단, 클럽 회원 명단에서 뽑았다. 대공황이 한창이던 1936년, 전화기와 자동차를 가진 사람들은 사회 전체에서 상대적으로 부유한 계층에 치우쳐 있었다. 게다가 설문지를 보낸 1,000만 명 중 응답한 사람은 24%뿐이었다 — 이 역시 특정 성향(불만이 많거나, 시간 여유가 있는 사람)의 사람들이 더 적극적으로 응답했을 가능성을 키웠다. 표본이 아무리 커도, 애초에 뽑힌 사람들의 구성 자체가 전체 유권자와 다르면 그 편향은 표본을 키운다고 사라지지 않는다. 오히려 크기가 클수록 “이렇게 큰 조사가 틀릴 리 없다”는 잘못된 확신만 키운다.
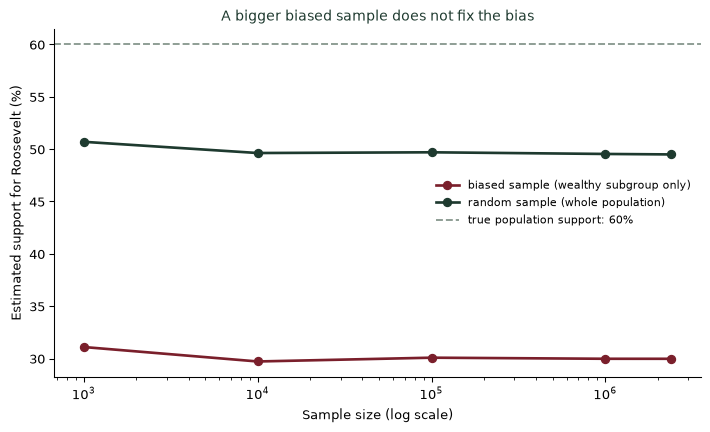
빨간 선(편향된 표본)은 아무리 표본 크기가 커져도 참값(60%)에 다가가지 않고 30% 근처에 머문다. 반면 짙은 초록 선(무작위 표본)은 표본이 커질수록 참값에 가까워진다. 표본 크기를 늘리는 것은 무작위성이 보장된 표본의 오차를 줄여줄 뿐, 편향 자체를 줄여주지는 않는다.
표본 크기를 믿기 전에 확인할 것
- 표본이 어떻게 뽑혔는지부터 물어라. 크기보다 먼저 확인해야 할 질문이다.
- “무응답자”가 누구인지 생각하라. 응답하지 않은 사람들이 특정 성향으로 치우쳐 있다면 편향이 숨어 있다.
- 크기와 정확도를 동일시하지 마라. 편향된 표본은 커질수록 “확신을 주는 틀린 답”이 될 뿐이다.
- 작지만 잘 설계된 표본을 더 신뢰하라. 1936년의 교훈은 지금도 유효하다.
더 깊이: 확률표본의 성질
강의노트 〈수리통계학 4. 표본분포 — 확률표본 성질〉은 제대로 된 확률표본이 갖춰야 할 성질(독립성, 동일분포)을 정의한다. 리터러리 다이제스트의 표본은 애초에 모집단 전체에서 뽑힌 것이 아니라, 전화와 자동차를 가진 부유층이라는 부분집합에서만 뽑혔다 — 확률표본의 정의 자체를 만족하지 못한 것이다. 크기를 키운다고 이 근본적인 결함이 고쳐지지는 않는다.
SDV 관점: 큰 데이터보다 설계가 옳은 데이터가 가치 있다
표본 크기와 편향을 구분하는 일은 요약과 추론(1~2단계)의 핵심이며, SDV(통계적 데이터 가치화) 관점에서는 “데이터가 많으면 믿을 만하다”는 흔한 착각을 바로잡는 문제다. 수백만 건의 로그 데이터, 수십만 명의 앱 사용자 데이터도, 애초에 특정 성향의 사용자만 모은 것이라면 그 규모는 신뢰의 근거가 되지 못한다. 데이터를 가치 있는 결정으로 바꾸려면, 양을 늘리기 전에 그 데이터가 누구를, 어떻게 대표하고 있는지부터 검증해야 한다. (SDV(데이터 가치화))
결론: 크기보다 먼저 물어야 할 질문
나는 학생들에게 “이 조사는 몇 명을 대상으로 했는가”라는 질문보다 “그 몇 명이 누구인가”라는 질문이 먼저라고 말한다. 1936년의 교훈은 90년이 지난 지금도 그대로다. 표본이 크다는 사실은 안심할 이유가 아니라, 오히려 그 큰 표본이 어떻게 뽑혔는지를 더 의심해야 할 이유다.
참고 자료
- 1936년 리터러리 다이제스트 여론조사의 표본 규모, 예측치, 응답률(24%), 갤럽의 예측치와 결과는 다음을 참고했다: The Literary Digest — 위키백과(영문), 1936 election: Case Study I — University of Pennsylvania
- 두 번째 시뮬레이션(부유층 비중, 지지율 가정)은 편향의 작동 방식을 보여주기 위한 가상의 설명용 수치다.