권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • 데이터 플랫폼
  • 유튜브
  1. 📖 (우연을 다루는 더 깊은 생각) 복잡한 사건을 가지 치듯 풀어내기 — 확률나무 그려보기
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고
  • 📖 (위험과 불확실성을 이해하는 법) 비 올 확률 60%는 무슨 뜻인가? — 확률적 예보 읽는 법
  • 📖 (위험과 불확실성을 이해하는 법) 100년 빈도 홍수는 100년에 한 번만 오는가? — 재현빈도의 오해
  • 📖 (위험과 불확실성을 이해하는 법) 보험회사는 어떻게 사고를 예측하는가? — 기대손실
  • 📖 (위험과 불확실성을 이해하는 법) 발생 가능성은 낮지만 피해가 큰 사건을 어떻게 볼 것인가? — 저확률·고피해 리스크
  • 📖 (위험과 불확실성을 이해하는 법) 위험은 확률과 피해 크기의 결합이다 — 위험 평가의 원칙
  • 📖 (확률의 뒷이야기) 문을 바꾸면 정말 유리할까 — 몬티홀 문제
  • 📖 (확률의 뒷이야기) 시행이 많아질수록 진짜 확률에 가까워지는 이유 — 큰 수의 법칙
  • 📖 (확률의 뒷이야기) 벼락 맞을 확률과 나란히 놓아보면 — 로또 1등의 확률
  • 📖 (확률의 뒷이야기) 그럴듯하게 느껴지는 이유 — 혈액형 성격론과 바넘 효과
  • 📖 (확률의 뒷이야기) 우연과 확증편향 사이 — 징크스는 통계적으로 존재할까
  • 📖 (위험 인식과 승부의 확률) 무엇이 더 위험한지 확률로 따져보면 — 비행기 vs 자동차
  • 📖 (위험 인식과 승부의 확률) 절대적 숫자와 상대적 숫자 — 백신 부작용 확률 읽는 법
  • 📖 (위험 인식과 승부의 확률) 확률적 행운이 바꾼 삶 — 복권 당첨자들의 그 후
  • 📖 (위험 인식과 승부의 확률) 먼저 차는 팀이 유리한 이유 — 승부차기의 심리 확률
  • 📖 (위험 인식과 승부의 확률) 숫자로 검증한 홈어드밴티지 — 홈그라운드의 이점
  • 📖 (우연을 다루는 더 깊은 생각) 오늘 날씨가 내일 날씨에 미치는 영향 — 마르코프 체인 쉽게 이해하기
  • 📖 (우연을 다루는 더 깊은 생각) 복잡한 사건을 가지 치듯 풀어내기 — 확률나무 그려보기
  • 📖 (우연을 다루는 더 깊은 생각) 컴퓨터로 확률을 추정하는 법 — 몬테카를로 시뮬레이션이란
  • 📖 (우연을 다루는 더 깊은 생각) 확률이 낮아도 불가능은 아니다 — 무한 원숭이 정리
  • 📖 (우연을 다루는 더 깊은 생각) 우연과 필연 사이 — 확률적 사고를 마무리하며

목차

  • 두 공장, 두 가지 불량률
  • 가지를 치며 모든 경우를 펼치기
  • 나무를 거꾸로 읽으면 베이즈 규칙이 된다
  • 더 깊이: 강의노트의 구슬 뽑기 확률나무
  • SDV 관점: 나무로 그려보면 숨어 있던 우선순위가 드러난다
  • 결론: 복잡한 확률 문제는 일단 그려라

(우연을 다루는 더 깊은 생각) 복잡한 사건을 가지 치듯 풀어내기 — 확률나무 그려보기

통계기초
확률
두 공장에서 부품을 들여오는 회사가 있다. 공장마다 불량률이 다르고 납품 비중도 다르다면, 전체 불량률과 ’이 불량품이 어느 공장 것인가’를 동시에 계산해야 한다. 공식을 외우는 대신, 가지를 치며 그려보면 답이 눈에 보인다.
Author

권세혁

Published

November 10, 2026

두 공장, 두 가지 불량률

어느 회사가 부품의 60%를 A공장에서, 40%를 B공장에서 납품받는다고 하자. A공장의 불량률은 2%, B공장의 불량률은 5%다. 이 회사가 받는 부품 전체의 불량률은 얼마일까? 그리고 불량품 하나가 발견됐을 때, 그것이 A공장 것일 확률은 얼마일까? 이런 문제는 식으로 바로 풀려고 하면 헷갈리기 쉽다. 이럴 때 가장 확실한 방법은 확률나무(probability tree)를 그려보는 것이다.

가지를 치며 모든 경우를 펼치기

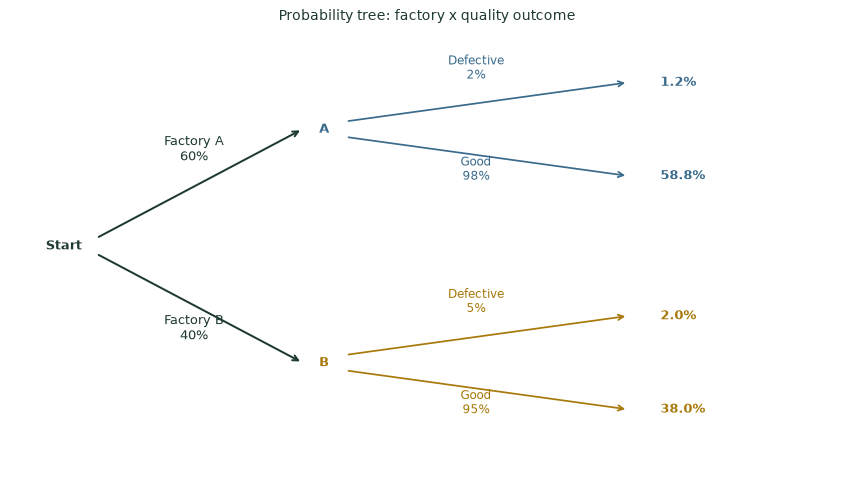
확률나무는 한 사건이 일어나는 과정을 단계별로 가지처럼 펼쳐 그린 그림이다. 첫 번째 가지는 “어느 공장에서 왔는가”(A 60% / B 40%), 두 번째 가지는 그 공장에서 “불량인가 정상인가”(A는 불량 2% / 정상 98%, B는 불량 5% / 정상 95%)다. 각 끝가지의 확률은 그 경로를 따라오는 동안의 확률을 모두 곱한 값이다.

A probability tree for parts from two factories. The first branch splits by factory (A: 60%, B: 40%); each factory branch then splits into defective/good. Multiplying along each path gives the probability of reaching that end point - for example, A and defective: 0.6 x 0.02 = 0.012 (1.2%).

끝가지 네 개의 확률을 모두 더하면 1(100%)이 되고, “불량”으로 끝나는 두 가지(A·불량 1.2%, B·불량 2.0%)만 더하면 전체 불량률 3.2%가 나온다. 전확률 법칙을 공식으로 외우지 않아도, 나무를 보면 “가지를 따라 곱하고, 같은 결과로 끝나는 가지를 더한다”는 규칙이 저절로 보인다.

나무를 거꾸로 읽으면 베이즈 규칙이 된다

이제 반대로 물어보자. 불량품 하나가 발견됐다면, 그것이 A공장 것일 확률은 얼마일까? 나무에서 “불량”으로 끝나는 두 가지(A·불량 1.2%, B·불량 2.0%)만 남기고, 그 안에서 A가 차지하는 비중을 구하면 된다.
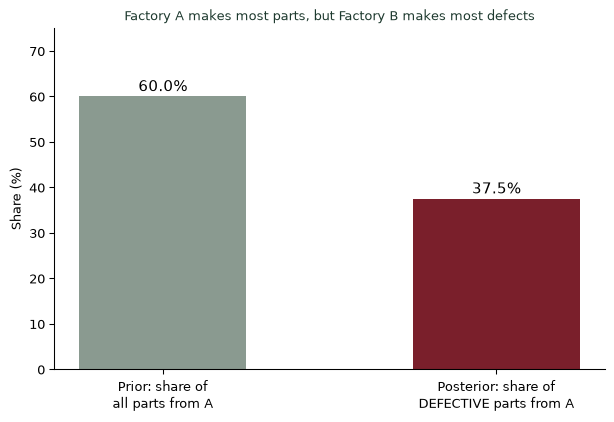
Reading the same tree backward: among all the ways to end up with a defective part (1.2% via Factory A, 2.0% via Factory B), what share came from each factory? Even though Factory B supplies fewer parts overall (40% vs 60%), it produces the majority of defects (62.5%) because its defect rate is so much higher.

A공장이 전체 부품의 60%를 차지하는데도, 불량품만 놓고 보면 A공장 것은 37.5%에 불과하고 오히려 B공장 것이 62.5%로 더 많다. 납품 비중은 낮아도 불량률이 훨씬 높은 B공장이, 불량품이라는 “조건” 안에서는 더 큰 비중을 차지하게 된 것이다. 품질 관리 담당자가 불량품을 발견했을 때 어느 공장부터 점검해야 할지, 나무 하나로 바로 답이 나온다.

확률나무를 그리는 법
  1. 첫 단계부터 끝까지 가지를 빠짐없이 나눠라. 한 단계에서 나올 수 있는 모든 경우를 나열해야 한다.
  2. 각 가지를 따라가며 확률을 곱하라. 경로 하나의 확률은 그 경로 위 모든 가지의 곱이다.
  3. 같은 결과로 끝나는 가지는 더하라. “전체 불량률”처럼 여러 경로가 같은 결과에 이르면 그 확률들을 합친다.
  4. 나무를 거꾸로 읽으면 베이즈 갱신이 된다. 특정 결과로 끝나는 가지들 안에서 비중을 다시 계산하면 사후확률이 나온다.

더 깊이: 강의노트의 구슬 뽑기 확률나무

강의노트 〈수리통계학 1. 확률론 — 베이즈 규칙〉에는 노랑·초록 두 주머니에서 구슬을 뽑는 예제가 확률나무 그림과 함께 실려 있다. 주사위 결과에 따라 어느 주머니에서 뽑을지가 정해지고, 그 주머니 안에서 빨강·파랑 구슬이 나올 확률이 다시 갈라지는 구조는 오늘 다룬 공장·불량품 예제와 정확히 같은 모양이다. 전확률 법칙과 베이즈 규칙은 결국 이 나무를 “앞으로 읽는가, 거꾸로 읽는가”의 차이일 뿐이다.

SDV 관점: 나무로 그려보면 숨어 있던 우선순위가 드러난다

확률나무로 복잡한 사건을 분해하는 일은 요약과 추론(1~2단계)의 실전 도구이며, SDV(통계적 데이터 가치화) 관점에서는 자원을 어디에 먼저 투입할지 결정하는 데 직접 쓰인다. “불량품의 몇 %가 B공장 것인가”라는 질문에 나무로 답하면, 전체 매입량은 적어도 품질 점검 인력을 B공장에 더 투입해야 한다는 결론이 자연스럽게 나온다. 복잡한 사건을 말로 설명하기보다 나무로 그려 보여주면, 데이터 안에 숨어 있던 우선순위가 누구에게나 명확하게 전달된다. (SDV(데이터 가치화))

결론: 복잡한 확률 문제는 일단 그려라

나는 학생들에게 확률 문제가 두 단계 이상 얽히면 공식부터 찾지 말고 나무부터 그리라고 말한다. 전확률 법칙도, 베이즈 규칙도 결국 같은 나무를 앞으로 읽느냐 거꾸로 읽느냐의 차이다. 가지를 치고, 곱하고, 더하는 세 동작만 기억하면 아무리 복잡한 사건도 눈으로 풀린다.

참고 자료
  • 공장 A·B의 납품 비중과 불량률(각각 60%/2%, 40%/5%)은 확률나무의 사용법을 보여주기 위한 가상의 설명용 수치다.
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08