권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • 데이터 플랫폼
  • 유튜브
  1. 📖 (위험 인식과 승부의 확률) 확률적 행운이 바꾼 삶 — 복권 당첨자들의 그 후
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고
  • 📖 (위험과 불확실성을 이해하는 법) 비 올 확률 60%는 무슨 뜻인가? — 확률적 예보 읽는 법
  • 📖 (위험과 불확실성을 이해하는 법) 100년 빈도 홍수는 100년에 한 번만 오는가? — 재현빈도의 오해
  • 📖 (위험과 불확실성을 이해하는 법) 보험회사는 어떻게 사고를 예측하는가? — 기대손실
  • 📖 (위험과 불확실성을 이해하는 법) 발생 가능성은 낮지만 피해가 큰 사건을 어떻게 볼 것인가? — 저확률·고피해 리스크
  • 📖 (위험과 불확실성을 이해하는 법) 위험은 확률과 피해 크기의 결합이다 — 위험 평가의 원칙
  • 📖 (확률의 뒷이야기) 문을 바꾸면 정말 유리할까 — 몬티홀 문제
  • 📖 (확률의 뒷이야기) 시행이 많아질수록 진짜 확률에 가까워지는 이유 — 큰 수의 법칙
  • 📖 (확률의 뒷이야기) 벼락 맞을 확률과 나란히 놓아보면 — 로또 1등의 확률
  • 📖 (확률의 뒷이야기) 그럴듯하게 느껴지는 이유 — 혈액형 성격론과 바넘 효과
  • 📖 (확률의 뒷이야기) 우연과 확증편향 사이 — 징크스는 통계적으로 존재할까
  • 📖 (위험 인식과 승부의 확률) 무엇이 더 위험한지 확률로 따져보면 — 비행기 vs 자동차
  • 📖 (위험 인식과 승부의 확률) 절대적 숫자와 상대적 숫자 — 백신 부작용 확률 읽는 법
  • 📖 (위험 인식과 승부의 확률) 확률적 행운이 바꾼 삶 — 복권 당첨자들의 그 후
  • 📖 (위험 인식과 승부의 확률) 먼저 차는 팀이 유리한 이유 — 승부차기의 심리 확률
  • 📖 (위험 인식과 승부의 확률) 숫자로 검증한 홈어드밴티지 — 홈그라운드의 이점

목차

  • 출처를 아무도 찾지 못한 “70%”
  • 수천, 수만 명을 추적한 최근 연구는 다른 이야기를 한다
  • 표본이 커지자 이야기가 더 정교해졌다
  • 더 깊이: 작은 표본이 만드는 과장된 결론
  • SDV 관점: 극적인 통념일수록 원 자료로 돌아가 검증해야 가치가 생긴다
  • 결론: 무서운 통념일수록 출처를 캐물어라

(위험 인식과 승부의 확률) 확률적 행운이 바꾼 삶 — 복권 당첨자들의 그 후

통계기초
확률
’로또 당첨자 70%는 파산한다’는 말을 한 번쯤 들어봤을 것이다. 그런데 이 수치의 출처를 추적한 사람은 아무도 찾지 못했다. 반면 617가구, 3,000명, 7만 6,859명을 몇 년에서 20년 넘게 추적한 최근 연구들은 전혀 다른 결론을 보여준다.
Author

권세혁

Published

November 4, 2026

출처를 아무도 찾지 못한 “70%”

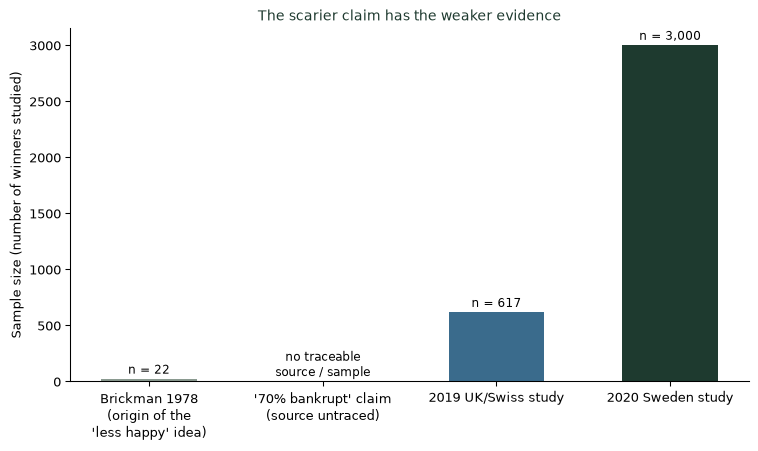
“로또 당첨자 70%는 결국 파산한다.” 이 통계는 한국에서도 미국에서도 자주 인용된다. 그런데 이 수치를 추적해보면 흥미로운 사실이 나온다. 이 “70%”는 2001년 미국의 한 금융교육 심포지엄에서 누군가 언급했다는 이야기가 출처로 돌아다니지만, 정작 누가 언제 어떤 자료로 그렇게 말했는지는 확인된 바가 없다. 복권 당첨자와 관련해 실제로 존재하는 학술 연구는 1978년 미국 심리학자 필립 브릭먼의 연구인데, 이마저도 당첨자 22명, 사고 피해자 29명이라는 극히 작은 표본으로 “당첨자가 생각보다 덜 행복하다”는 결론을 낸 것이었다. 이렇게 작은 표본에서 나온 조심스러운 결론이, 세월이 흐르며 “70% 파산”이라는 더 단정적이고 더 무서운 숫자로 부풀려져 퍼진 것으로 보인다.

수천, 수만 명을 추적한 최근 연구는 다른 이야기를 한다

최근 들어 훨씬 큰 표본으로 당첨자를 추적한 연구들이 나왔다. 2019년 영국 워릭대·스위스 취리히대 공동 연구는 당첨금이 수천 유로에서 수백만 유로에 이르는 617가구를 분석해, 당첨이 전반적인 삶의 만족도를 끌어올리며 당첨금이 클수록 그 효과도 크다는 결론을 냈다. 2020년 스웨덴 스톡홀름대 등의 연구는 당첨자 3,000명을 5년에서 22년에 걸쳐 추적했는데, 행복도 상승 효과가 10년이 지나도 사라지지 않았고, 당첨자들이 돈을 한꺼번에 탕진했다는 증거도 찾지 못했다. 오히려 상금을 수년에 걸쳐 천천히 쓰는 경향이 나타났다.

Sample sizes behind the competing claims about lottery winners. The widely repeated ‘70% go bankrupt’ figure traces back to an unsourced 2001 claim; the one real academic study from that era (Brickman 1978) used only 22 winners. Recent, much larger studies (2019 UK/Swiss: 617 households; 2020 Sweden: 3,000 winners) find sustained gains in life satisfaction instead.

표본이 커지자 이야기가 더 정교해졌다

표본이 커지면서 연구 결과도 “모두에게 똑같이 좋다/나쁘다”는 단순한 결론에서 벗어나 더 세밀해졌다. 뉴욕대·바르셀로나대 연구진이 스웨덴 복권 구매자 7만 6,859명을 분석한 결과, 당첨 후 가족 관계 변화는 소득 수준과 성별에 따라 달랐다. 저소득 남성에게서는 뚜렷한 변화가 나타났지만, 고소득 남성은 거의 변화가 없었다. 여성 당첨자의 경우, 연구진은 당첨이 이혼을 “만들어낸” 것이 아니라 이미 어려움을 겪던 결혼에서 여성이 떠나는 시점을 앞당긴 것으로 해석했다.
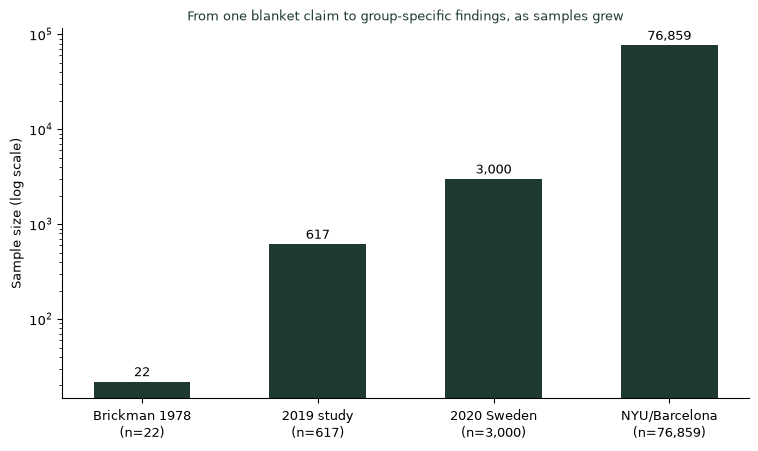
As lottery-winner studies moved from small samples to very large ones, the conclusions shifted from a single blanket claim (‘winners are unhappy’ or ‘winners go bankrupt’) to a more nuanced, group-specific picture - exactly what larger samples make possible.

물론 이 연구들은 대부분 유럽, 특히 스웨덴처럼 사회복지 제도가 탄탄한 나라에서 이뤄졌다. 세금 구조와 복지 체계가 다른 한국 당첨자에게 그대로 적용하기는 어렵다는 점은 분명히 해두어야 한다.

“당첨자의 그 후” 이야기를 읽을 때
  1. “몇 퍼센트가 파산한다”는 말을 들으면 원 출처를 찾아보라. 출처가 불분명한 통계는 그 자체로 의심할 이유가 된다.
  2. 표본 크기를 확인하라. 22명의 결론과 76,859명의 결론은 신뢰도가 다르다.
  3. 나라와 시대가 다르면 그대로 적용하지 마라. 유럽의 연구 결과가 한국에 그대로 맞으리라는 보장은 없다.
  4. 무서운 숫자일수록 더 꼼꼼히 검증하라. 극적인 주장일수록 출처가 부실한 경우가 많다.

더 깊이: 작은 표본이 만드는 과장된 결론

강의노트 〈수리통계학 4. 표본분포 — 확률수렴〉은 표본이 커질수록 표본 통계량이 참값에 가까워진다는 큰 수의 법칙을 다룬다. 지난주 여론조사 글에서 본 것과 같은 원리가 여기서도 작동한다. 22명이라는 작은 표본에서 나온 결론은 우연에 크게 흔들릴 수 있지만, 수천~수만 명을 추적한 최근 연구의 결론은 그보다 훨씬 믿을 만하다.

SDV 관점: 극적인 통념일수록 원 자료로 돌아가 검증해야 가치가 생긴다

통념의 출처와 표본 크기를 추적하는 일은 요약과 추론(1~2단계)을 넘어, SDV(통계적 데이터 가치화) 관점에서 조직 내에 떠도는 “다들 그렇게 알고 있는” 통계를 검증하는 절차와 같다. “70% 파산”처럼 출처 없이 떠도는 숫자는 회사 안에서도 흔하다 — “고객의 80%는 이탈한다”, “신규 프로젝트의 90%는 실패한다” 같은 말들이 실제로는 누구도 검증하지 않은 채 반복되는 경우가 많다. 데이터에 가치를 더하는 통계학자의 역할은, 이런 통념을 들었을 때 “그 숫자는 어디서 왔고, 몇 명을 조사한 결과인가”를 가장 먼저 되묻는 것이다. (SDV(데이터 가치화))

결론: 무서운 통념일수록 출처를 캐물어라

나는 학생들에게 “다들 그렇다고 하더라”는 통계를 들으면 가장 먼저 “그거 누가, 몇 명을 조사해서 한 말이에요?”라고 물으라고 말한다. “로또 당첨자 70%가 파산한다”는 말은 출처를 추적할수록 흐려지지만, 수천 명을 수십 년간 추적한 최근 연구들은 오히려 “행운은 생각보다 오래, 좋은 쪽으로 남는다”는 더 차분한 결론을 보여준다.

참고 자료
  • “70% 파산” 통계의 불분명한 출처, 1978년 브릭먼 연구(당첨자 22명)는 다음 기사를 참고했다: “당첨자 70%는 파산한대요”…로또의 저주 믿습니까? — 아시아경제
  • 2019년 영국 워릭대·스위스 취리히대 연구(617가구), 2020년 스웨덴 연구(3,000명, 5~22년 추적), 뉴욕대·바르셀로나대 연구(스웨덴 복권 구매자 76,859명)는 위 기사에서 소개된 연구 결과를 인용했다.
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08