권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • 데이터 플랫폼
  • 유튜브
  1. 📖 (위험 인식과 승부의 확률) 절대적 숫자와 상대적 숫자 — 백신 부작용 확률 읽는 법
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고
  • 📖 (위험과 불확실성을 이해하는 법) 비 올 확률 60%는 무슨 뜻인가? — 확률적 예보 읽는 법
  • 📖 (위험과 불확실성을 이해하는 법) 100년 빈도 홍수는 100년에 한 번만 오는가? — 재현빈도의 오해
  • 📖 (위험과 불확실성을 이해하는 법) 보험회사는 어떻게 사고를 예측하는가? — 기대손실
  • 📖 (위험과 불확실성을 이해하는 법) 발생 가능성은 낮지만 피해가 큰 사건을 어떻게 볼 것인가? — 저확률·고피해 리스크
  • 📖 (위험과 불확실성을 이해하는 법) 위험은 확률과 피해 크기의 결합이다 — 위험 평가의 원칙
  • 📖 (확률의 뒷이야기) 문을 바꾸면 정말 유리할까 — 몬티홀 문제
  • 📖 (확률의 뒷이야기) 시행이 많아질수록 진짜 확률에 가까워지는 이유 — 큰 수의 법칙
  • 📖 (확률의 뒷이야기) 벼락 맞을 확률과 나란히 놓아보면 — 로또 1등의 확률
  • 📖 (확률의 뒷이야기) 그럴듯하게 느껴지는 이유 — 혈액형 성격론과 바넘 효과
  • 📖 (확률의 뒷이야기) 우연과 확증편향 사이 — 징크스는 통계적으로 존재할까
  • 📖 (위험 인식과 승부의 확률) 무엇이 더 위험한지 확률로 따져보면 — 비행기 vs 자동차
  • 📖 (위험 인식과 승부의 확률) 절대적 숫자와 상대적 숫자 — 백신 부작용 확률 읽는 법
  • 📖 (위험 인식과 승부의 확률) 확률적 행운이 바꾼 삶 — 복권 당첨자들의 그 후
  • 📖 (위험 인식과 승부의 확률) 먼저 차는 팀이 유리한 이유 — 승부차기의 심리 확률
  • 📖 (위험 인식과 승부의 확률) 숫자로 검증한 홈어드밴티지 — 홈그라운드의 이점

목차

  • “4배 위험하다”는 말, 틀린 말은 아니다
  • 작은 숫자의 세계에서는 배수가 쉽게 부풀려진다
  • 신고 건수와 인과성 확정은 다르다
  • 더 깊이: 이상반응 신고율은 조건부확률이다
  • SDV 관점: 비율과 절대값을 동시에 공개하는 것이 신뢰를 만든다
  • 결론: 배수 뒤에 숨은 절대값을 항상 확인하라

(위험 인식과 승부의 확률) 절대적 숫자와 상대적 숫자 — 백신 부작용 확률 읽는 법

통계기초
확률
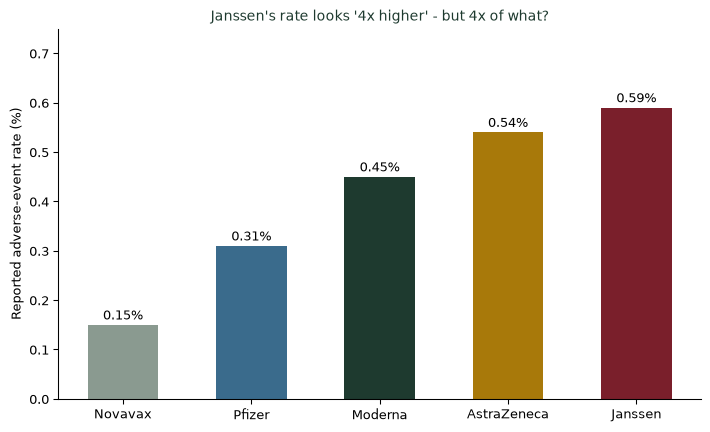
’이 백신은 저 백신보다 이상반응이 4배 많다’는 말은 사실이면서도 오해를 부른다. 질병관리청 집계로 보면 얀센 0.59%, 노바백스 0.15% — 배수로는 4배지만, 둘 다 1%가 채 안 되는 작은 숫자다. 상대위험과 절대위험을 함께 읽어야 하는 이유를 백신 신고율로 다시 살펴본다.
Author

권세혁

Published

November 3, 2026

“4배 위험하다”는 말, 틀린 말은 아니다

이 시리즈 8월 글 “위험이 두 배 증가했다는 뉴스는 얼마나 위험한가”에서 가공육과 대장암을 예로 상대위험과 절대위험의 차이를 다룬 적이 있다. 이번에는 더 민감한 주제인 백신으로 같은 원리를 다시 짚어본다. 질병관리청이 2022년 6월까지 집계한 코로나19 백신 이상반응 신고율은 전체 접종(1억 2,530만 9,520건) 중 0.38%였다. 백신 종류별로는 얀센 0.59%, 아스트라제네카 0.54%, 모더나 0.45%, 화이자 0.31%, 노바백스 0.15%로 나타났다. 얀센의 신고율은 노바백스의 4배에 가깝다 — 이 문장 자체는 사실이다. 문제는 “4배”라는 말만 들었을 때 머릿속에 떠오르는 위험의 크기와, 실제 숫자(0.59% vs 0.15%)가 보여주는 위험의 크기가 전혀 다르다는 데 있다.

KDCA-reported adverse-event report rates by vaccine type (cumulative through June 2022). Janssen’s reported rate is nearly 4x Novavax’s - a dramatic-sounding ratio - but both numbers sit well under 1% in absolute terms.

작은 숫자의 세계에서는 배수가 쉽게 부풀려진다

두 비율이 모두 작을 때는, 약간의 차이만으로도 “몇 배”라는 표현이 쉽게 커진다. 0.15%가 0.2%p 늘어 0.35%가 되면 “2배 이상 증가”라고 쓸 수 있지만, 실제로는 1만 명 중 2명이 1만 명 중 3.5명이 된 것뿐이다. 이 글이 강조하려는 것은 백신이 안전한지 위험한지를 판단하라는 게 아니라, “몇 배”라는 말이 작은 절대값 위에서는 특히 과장되게 들린다는 점이다. 아래 그림은 같은 0.2%포인트의 차이가 기준값이 작을수록 얼마나 큰 “배수”로 보이는지 보여준다.
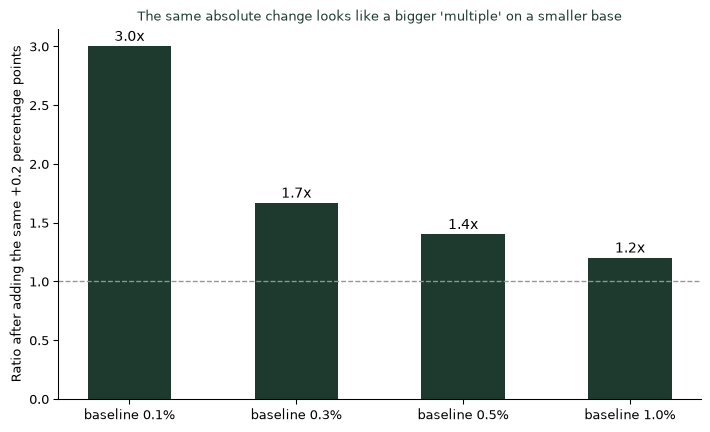
The same 0.2-percentage-point increase, expressed as a ratio, depending on the baseline rate it is added to. Against a small baseline (0.1%), a 0.2pp increase sounds like a 3x jump; against a larger baseline (1%), the identical 0.2pp increase is only a 1.2x change.

신고 건수와 인과성 확정은 다르다

또 하나 짚어야 할 것은, 질병관리청이 밝힌 이상반응 “신고” 건수는 백신 때문이라고 확정된 사례가 아니라는 점이다. 보도자료도 “인과성이 확정된 것을 의미하지 않는다”고 명시한다. 2022년 6월 기준 피해보상 신청 7만 8,462건 중 실제로 보상이 결정된 것은 1만 8,458건(약 23.5%)이었다. 즉 신고율 0.38%라는 숫자조차도, 그 전부가 “백신 때문에 생긴 부작용”이라고 확정된 것은 아니다. 절대위험·상대위험을 구분하는 것만큼이나, “신고된 것”과 “확인된 것”을 구분하는 일도 중요하다.

부작용 확률 보도를 읽는 법
  1. “몇 배”라는 말을 보면 바로 절대값을 찾아보라. 0.15%와 0.59%처럼, 둘 다 작은 숫자일 수 있다.
  2. 기준값(분모)이 작을수록 배수는 쉽게 커진다는 걸 기억하라. 같은 차이라도 기준이 작으면 더 극적으로 보인다.
  3. “신고”와 “인과성 확정”을 구분하라. 신고율은 상한에 가까운 숫자이지, 실제 부작용 발생률의 확정치가 아니다.
  4. 상대위험과 절대위험을 항상 같이 제시하라. 하나만 말하면 그림의 절반을 가린 것이다.

더 깊이: 이상반응 신고율은 조건부확률이다

강의노트 〈수리통계학 1. 확률론 — 조건부 확률〉의 정의로 쓰면, 신고율은 \(P(\text{이상반응 신고}\mid\text{해당 백신 접종})\)이라는 조건부확률이다. “얀센이 노바백스보다 위험하다”는 비교는 사실 두 조건부확률의 비율, 곧 \(P(\cdot\mid\text{얀센})/P(\cdot\mid\text{노바백스})\)을 말하는 것이다. 비율만 보면 차이가 커 보이지만, 두 조건부확률 자체가 모두 1%에 못 미친다는 사실은 비율만으로는 드러나지 않는다.

SDV 관점: 비율과 절대값을 동시에 공개하는 것이 신뢰를 만든다

상대위험과 절대위험을 함께 읽는 습관은 요약과 추론(1~2단계)의 기본이며, SDV(통계적 데이터 가치화) 관점에서는 공중보건처럼 신뢰가 핵심인 영역에서 특히 중요하다. “이상반응이 4배 많다”는 숫자만 공개하면 불안을 키우고, “0.38%만 신고됐다”는 숫자만 공개하면 과소평가로 보일 수 있다. 데이터를 가치 있는 의사결정으로 연결하려면 절대값과 상대값, 신고와 인과성 확정을 모두 투명하게 나란히 제시해야 한다. 그래야 정책 결정자도, 일반 시민도 같은 숫자를 보고 같은 수준의 이해에 도달할 수 있다. (SDV(데이터 가치화))

결론: 배수 뒤에 숨은 절대값을 항상 확인하라

나는 학생들에게 “몇 배 위험하다”는 보도를 보면 반사적으로 “그래서 원래 숫자는 몇이었는데?”를 물으라고 말한다. 0.59%와 0.15%는 분명 4배 차이가 나지만, 둘 다 100명 중 1명이 채 안 되는 작은 숫자다. 상대위험과 절대위험을 함께 읽을 때에만 숫자가 제대로 된 크기로 보인다.

참고 자료
  • 코로나19 백신 이상반응 신고 통계(누적 47만 1,775건, 전체 접종의 0.38%, 백신별 신고율, 피해보상 신청·결정 건수)는 다음 자료를 참고했다: MEDI:GATE NEWS — 국가예방접종 이상반응 신고율, 코로나 백신 이상반응 1만8548건 보상 — 파이낸셜뉴스
  • 신고 사례가 백신과의 인과성이 확정된 것은 아니라는 점은 질병관리청 보도자료 설명을 따랐다.
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08