권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • 데이터 플랫폼
  • 유튜브
  1. 📖 (확률의 뒷이야기) 문을 바꾸면 정말 유리할까 — 몬티홀 문제
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고
  • 📖 (위험과 불확실성을 이해하는 법) 비 올 확률 60%는 무슨 뜻인가? — 확률적 예보 읽는 법
  • 📖 (위험과 불확실성을 이해하는 법) 100년 빈도 홍수는 100년에 한 번만 오는가? — 재현빈도의 오해
  • 📖 (위험과 불확실성을 이해하는 법) 보험회사는 어떻게 사고를 예측하는가? — 기대손실
  • 📖 (위험과 불확실성을 이해하는 법) 발생 가능성은 낮지만 피해가 큰 사건을 어떻게 볼 것인가? — 저확률·고피해 리스크
  • 📖 (위험과 불확실성을 이해하는 법) 위험은 확률과 피해 크기의 결합이다 — 위험 평가의 원칙
  • 📖 (확률의 뒷이야기) 문을 바꾸면 정말 유리할까 — 몬티홀 문제
  • 📖 (확률의 뒷이야기) 시행이 많아질수록 진짜 확률에 가까워지는 이유 — 큰 수의 법칙
  • 📖 (확률의 뒷이야기) 벼락 맞을 확률과 나란히 놓아보면 — 로또 1등의 확률
  • 📖 (확률의 뒷이야기) 그럴듯하게 느껴지는 이유 — 혈액형 성격론과 바넘 효과
  • 📖 (확률의 뒷이야기) 우연과 확증편향 사이 — 징크스는 통계적으로 존재할까

목차

  • 수학자 1,000명이 틀렸다고 반박한 문제
  • 세 문을 모두 펼쳐 보면 보인다
  • 10만 번 시뮬레이션으로 확인하기
  • 왜 반반이 아닌가 — 핵심은 진행자가 “알고 연다”는 것
  • 더 깊이: 베이즈 규칙으로 다시 풀기
  • SDV 관점: 직관이 멈추는 지점에서 계산이 가치를 만든다
  • 결론: 바꾸는 것이 항상 유리하다

(확률의 뒷이야기) 문을 바꾸면 정말 유리할까 — 몬티홀 문제

통계기초
확률
세 개의 문 중 하나에 자동차가 있다. 하나를 고른 뒤, 진행자가 염소가 있는 다른 문을 열어 보여주고 묻는다. ‘바꾸시겠습니까?’ 대부분의 사람은 ’바꾸나 안 바꾸나 반반 아니냐’고 생각하지만, 바꾸면 당첨 확률이 2배로 뛴다. 수학자들조차 처음엔 틀렸다고 반박했던 이 문제를 베이즈 규칙으로 풀어본다.
Author

권세혁

Published

October 26, 2026

수학자 1,000명이 틀렸다고 반박한 문제

1990년 미국 칼럼니스트 마릴린 보스 사반트가 독자 질문에 이렇게 답했다. “세 문 중 하나를 골랐다가, 염소가 있는 다른 문이 열린 뒤에는 반드시 바꾸는 것이 유리하다.” 이 답에 박사 학위를 가진 독자 수백 명이 항의 편지를 보냈다. “확률은 50:50이다, 당신이 틀렸다”는 내용이었다. 그러나 사반트의 답이 맞았다. 직접 세 가지 경우를 나열해 보면 왜 그런지 보인다.

세 문을 모두 펼쳐 보면 보인다

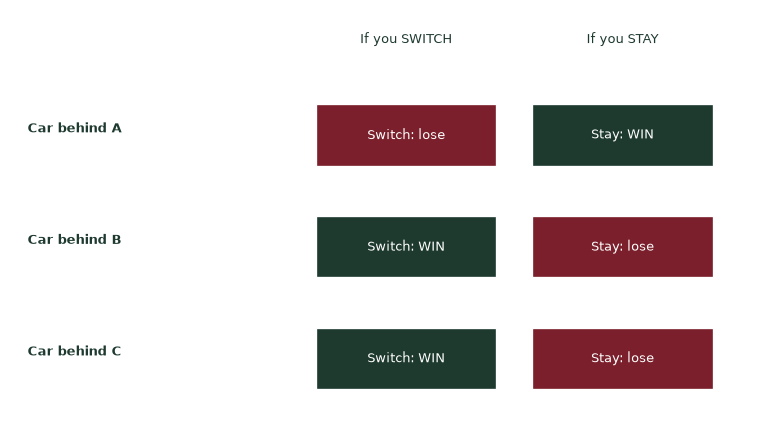
문 뒤에 자동차가 A, B, C 중 어느 문에 있든, 내가 처음에 A를 고른다고 하자. 진행자는 자동차가 없는 문을 반드시 하나 열어 보여준다(진행자는 답을 알고 있다는 것이 핵심 규칙이다).

All three possible locations of the car, when the player always picks Door A first. In 2 out of 3 cases, switching after the host reveals a goat wins the car; staying wins in only 1 out of 3 cases.

내가 처음 고른 문(A)에 자동차가 있을 확률은 1/3이다. 이 경우에만 “바꾸면” 진다. 반대로 자동차가 B나 C에 있을 확률은 합쳐서 2/3인데, 이 두 경우 모두 진행자가 염소 문을 열어 “남은 문”을 가리켜 주므로, 바꾸면 반드시 이긴다. 그래서 바꾸는 전략의 승률은 2/3, 그대로 있는 전략의 승률은 1/3이다.

10만 번 시뮬레이션으로 확인하기
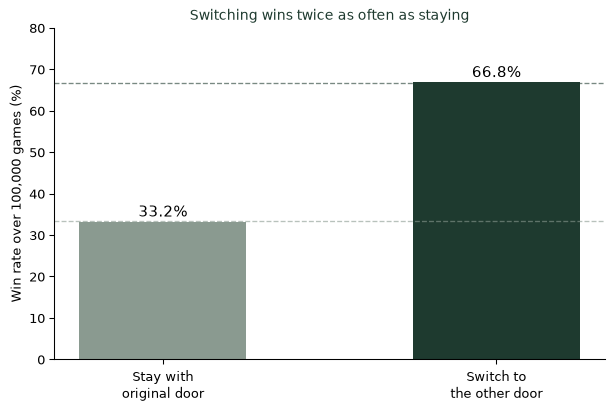
100,000 simulated games of the Monty Hall problem. Switching wins about 66.7% of the time, almost exactly double the 33.3% win rate from staying - matching the 2/3 vs 1/3 prediction exactly.

왜 반반이 아닌가 — 핵심은 진행자가 “알고 연다”는 것

사람들이 50:50이라고 착각하는 이유는 “문이 두 개 남았으니 반반”이라는 직관 때문이다. 그러나 이 직관이 놓치는 것은, 진행자가 무작위로 문을 연 게 아니라는 사실이다. 진행자는 답을 알고 있고, 항상 염소가 있는 문만 골라서 연다. 이 “알고 있다”는 정보가 조용히 확률을 내 쪽으로 옮겨준다. 내가 처음 고른 문은 그대로 1/3의 확률을 유지하지만, 나머지 두 문이 가졌던 2/3의 확률은 진행자가 열어준 문이 사라지면서 고스란히 “바꿀 수 있는 문” 하나에 몰린다.

몬티홀 문제를 이해하는 법
  1. 문이 몇 개 남았는지가 아니라, 누가 무엇을 알고 열었는지를 보라. 무작위로 연 것과 알고서 연 것은 전혀 다른 정보다.
  2. 극단적인 경우로 바꿔 생각해 보라. 문이 100개이고 내가 하나를 고른 뒤 진행자가 자동차 없는 98개를 열어준다면, 남은 한 문으로 바꾸는 게 유리하다는 게 훨씬 직관적으로 느껴진다.
  3. 직접 세 가지 경우를 나열해 보라. 공식을 외우기보다 표로 그려보면 가장 빨리 이해된다.
  4. “반반처럼 느껴진다”는 직관을 의심하라. 몬티홀 문제는 느낌과 계산이 가장 크게 엇갈리는 사례 중 하나다.

더 깊이: 베이즈 규칙으로 다시 풀기

강의노트 〈수리통계학 1. 확률론 — 베이즈 규칙〉의 틀로 다시 쓰면, “진행자가 문 B를 열었다”는 증거를 관찰한 뒤 “자동차가 A에 있을 확률”을 갱신하는 문제다. 사전확률은 각 문 1/3로 같지만, \(P(\text{진행자가 B를 염}\mid\text{자동차가 A})=1/2\)인 반면 \(P(\text{진행자가 B를 염}\mid\text{자동차가 C})=1\)이다(C에 있으면 진행자는 B를 열 수밖에 없다). 이 비대칭이 베이즈 갱신을 거치며 “바꾸면 2/3”라는 결론을 만든다.

SDV 관점: 직관이 멈추는 지점에서 계산이 가치를 만든다

몬티홀 문제를 둘러싼 논쟁은 요약과 추론(1~2단계)의 고전적 사례이면서, 제가 제안하는 SDV(통계적 데이터 가치화) 관점에서는 “직관과 계산이 충돌할 때 무엇을 믿을 것인가”라는 더 큰 질문을 던진다. 박사 학위를 가진 전문가들조차 직관만으로 틀린 결론에 도달했다는 사실은, 아무리 숙련된 의사결정자라도 데이터와 계산 없이 확률적 판단을 내리면 체계적으로 틀릴 수 있다는 경고다. 데이터에 가치를 더하는 통계학자의 역할은, 직관이 멈추는 지점에서 계산으로 한 걸음 더 나아가는 것이다. (SDV(데이터 가치화))

결론: 바꾸는 것이 항상 유리하다

나는 학생들에게 몬티홀 문제를 처음 설명할 때 바로 답을 주지 않는다. 대신 “문이 100개라면 어떨까”라고 되묻는다. 그러면 대부분 스스로 답에 가까워진다. 직관이 가장 자신 있게 틀리는 순간, 그 틀림을 깨는 것은 느낌이 아니라 세 줄의 표다.

참고 자료
  • 1990년 마릴린 보스 사반트의 “Ask Marilyn” 칼럼 논쟁은 몬티홀 문제를 대중에 널리 알린 계기로 폭넓게 알려져 있다.
  • 문제의 이름은 미국 게임쇼 “Let’s Make a Deal”의 진행자 몬티 홀(Monty Hall)에서 유래했다.
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08