권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • 데이터 플랫폼
  • 유튜브
  1. 📖 (우연을 다루는 더 깊은 생각) 확률이 낮아도 불가능은 아니다 — 무한 원숭이 정리
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고
  • 📖 (위험과 불확실성을 이해하는 법) 비 올 확률 60%는 무슨 뜻인가? — 확률적 예보 읽는 법
  • 📖 (위험과 불확실성을 이해하는 법) 100년 빈도 홍수는 100년에 한 번만 오는가? — 재현빈도의 오해
  • 📖 (위험과 불확실성을 이해하는 법) 보험회사는 어떻게 사고를 예측하는가? — 기대손실
  • 📖 (위험과 불확실성을 이해하는 법) 발생 가능성은 낮지만 피해가 큰 사건을 어떻게 볼 것인가? — 저확률·고피해 리스크
  • 📖 (위험과 불확실성을 이해하는 법) 위험은 확률과 피해 크기의 결합이다 — 위험 평가의 원칙
  • 📖 (확률의 뒷이야기) 문을 바꾸면 정말 유리할까 — 몬티홀 문제
  • 📖 (확률의 뒷이야기) 시행이 많아질수록 진짜 확률에 가까워지는 이유 — 큰 수의 법칙
  • 📖 (확률의 뒷이야기) 벼락 맞을 확률과 나란히 놓아보면 — 로또 1등의 확률
  • 📖 (확률의 뒷이야기) 그럴듯하게 느껴지는 이유 — 혈액형 성격론과 바넘 효과
  • 📖 (확률의 뒷이야기) 우연과 확증편향 사이 — 징크스는 통계적으로 존재할까
  • 📖 (위험 인식과 승부의 확률) 무엇이 더 위험한지 확률로 따져보면 — 비행기 vs 자동차
  • 📖 (위험 인식과 승부의 확률) 절대적 숫자와 상대적 숫자 — 백신 부작용 확률 읽는 법
  • 📖 (위험 인식과 승부의 확률) 확률적 행운이 바꾼 삶 — 복권 당첨자들의 그 후
  • 📖 (위험 인식과 승부의 확률) 먼저 차는 팀이 유리한 이유 — 승부차기의 심리 확률
  • 📖 (위험 인식과 승부의 확률) 숫자로 검증한 홈어드밴티지 — 홈그라운드의 이점
  • 📖 (우연을 다루는 더 깊은 생각) 오늘 날씨가 내일 날씨에 미치는 영향 — 마르코프 체인 쉽게 이해하기
  • 📖 (우연을 다루는 더 깊은 생각) 복잡한 사건을 가지 치듯 풀어내기 — 확률나무 그려보기
  • 📖 (우연을 다루는 더 깊은 생각) 컴퓨터로 확률을 추정하는 법 — 몬테카를로 시뮬레이션이란
  • 📖 (우연을 다루는 더 깊은 생각) 확률이 낮아도 불가능은 아니다 — 무한 원숭이 정리
  • 📖 (우연을 다루는 더 깊은 생각) 우연과 필연 사이 — 확률적 사고를 마무리하며

목차

  • 원숭이가 셰익스피어를 쓸 확률
  • “banana” 한 단어에도 3억 번이 필요하다
  • 우주의 나이보다 긴 시간이 필요하다
  • “확률 0이 아니다”와 “현실적으로 가능하다”는 다르다
  • 더 깊이: 베르누이 시행의 반복과 독립성
  • SDV 관점: “가능성 0이 아니다”는 설계의 출발점이지 결론이 아니다
  • 결론: 가능하다는 것과 기다릴 만하다는 것은 다르다

(우연을 다루는 더 깊은 생각) 확률이 낮아도 불가능은 아니다 — 무한 원숭이 정리

통계기초
확률
타자기 앞에 원숭이를 무한히 앉혀 두면, 언젠가는 셰익스피어 희곡을 한 글자도 틀리지 않고 쳐낸다는 ‘무한 원숭이 정리’. 수학적으로는 참이지만, 11글자짜리 단어 하나를 맞히는 데만 평균 3,670조 번의 시도가 필요하다. ’확률 0이 아니다’와 ’현실적으로 가능하다’는 전혀 다른 말이다.
Author

권세혁

Published

November 12, 2026

원숭이가 셰익스피어를 쓸 확률

타자기 앞에 원숭이를 앉혀 두고 자판을 무작위로 누르게 한다고 하자. 시간이 무한히 주어진다면, 이 원숭이는 언젠가 셰익스피어의 희곡을 단 한 글자도 틀리지 않고 쳐낼 수 있을까? 수학적으로 답은 “그렇다”다. 한 글자씩 완전히 무작위로 치는 한, 아무리 긴 문장이라도 그 문장과 정확히 일치할 확률은 0보다 크고, 무한히 많은 시도를 허용하면 그 사건은 확률 1로 언젠가 일어난다. 이것이 무한 원숭이 정리(infinite monkey theorem)다. 그런데 이 “언젠가”가 과연 얼마나 먼 미래인지 계산해보면, 이 정리의 진짜 의미가 드러난다.

“banana” 한 단어에도 3억 번이 필요하다

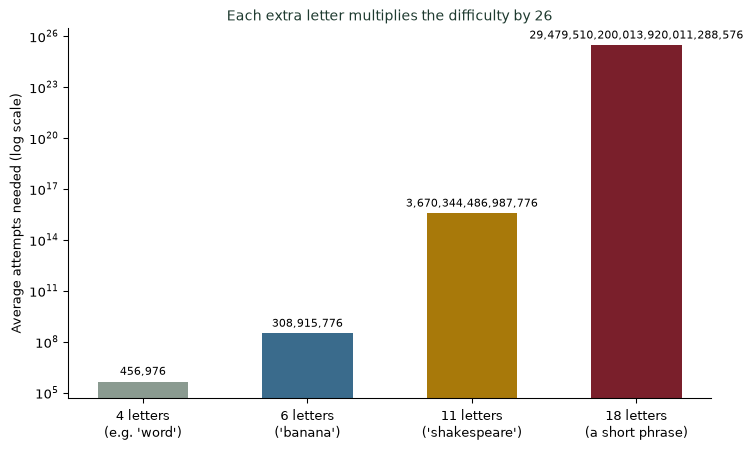
영어 알파벳 26자(공백 제외) 중 하나를 무작위로 치는 원숭이가 특정 단어를 맞힐 확률을 계산해보자. 4글자 단어는 \(26^{-4}\), 즉 평균 약 45만 7천 번을 시도해야 한 번 맞힌다. “banana”처럼 6글자면 평균 약 3억 번이 필요하다.

Average number of random keystrokes-worth of attempts needed before a monkey randomly types a specific target string, as the string length grows (log scale). Four letters already needs almost half a million tries; eleven letters needs over a quadrillion.

글자가 하나 늘어날 때마다 필요한 시도 횟수는 26배로 뛴다. 그래서 11글자짜리 단어 하나(“shakespeare”)를 맞히는 데만 평균 약 3,670조 번의 시도가 필요하다. 이것은 아직 한 “단어”일 뿐, 희곡 한 편이 아니다.

우주의 나이보다 긴 시간이 필요하다

18글자짜리 짧은 문장 하나를 맞히려면 평균 약 \(2.9\times10^{25}\)번의 시도가 필요하다. 이 숫자가 얼마나 큰지 가늠하기 위해, 우주의 나이(약 138억 년)를 초 단위로 환산한 값과 비교해보자.
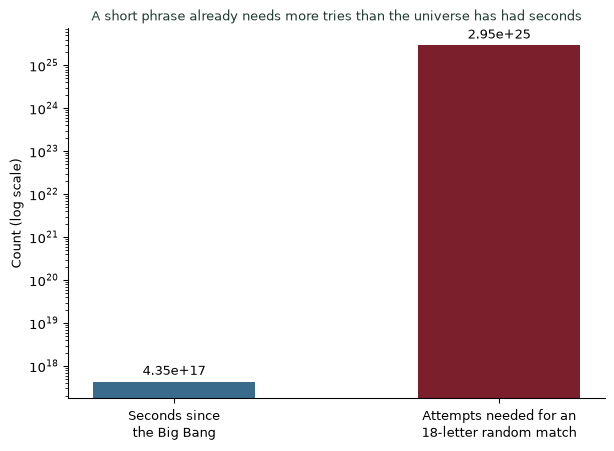
The number of attempts needed for an 18-letter random phrase to match a target, compared with the number of seconds since the Big Bang (the age of the universe). The required attempts outnumber the seconds in the universe’s entire history by a factor of about 68 million - and this is still just one short phrase, not a full play.

우주가 탄생한 순간부터 지금까지 흐른 모든 초를 다 합쳐도, 18글자짜리 문장 하나를 무작위로 맞히는 데 필요한 평균 시도 횟수에는 턱없이 못 미친다. 셰익스피어의 희곡 《햄릿》 전체(수만 자)를 맞히는 데 필요한 시도 횟수는 이보다도 비교할 수 없이 더 크다.

“확률 0이 아니다”와 “현실적으로 가능하다”는 다르다

무한 원숭이 정리가 주는 교훈은 역설적이다. 수학적으로는 이 사건이 “불가능하지 않다”(확률이 정확히 0은 아니다)는 것이 참이지만, 실제로 일어나기를 기대할 수 있는 시간 규모는 우주의 나이를 가볍게 뛰어넘는다. 이 시리즈 9월의 “희귀한 사건이 매일 뉴스에 나오는 이유”에서 다룬 다중 기회의 논리와 정반대의 교훈이다. 그 글에서는 기회(모집단)가 충분히 많으면 극히 드문 사건도 현실에서 자주 일어난다는 것을 보였다. 오늘은 그 “충분히 많은 기회”가 얼마나 비현실적으로 커야 하는지를 숫자로 보여준다. 확률이 0이 아니라는 수학적 사실과, 그 일이 실제로 일어날 가능성이 있다는 현실적 판단 사이에는 이렇게 큰 간극이 있을 수 있다.

“확률상 가능하다”는 말을 들으면
  1. “가능하다”가 “0이 아니다”라는 뜻인지, “현실적으로 기대할 만하다”는 뜻인지 구분하라. 둘은 전혀 다른 주장이다.
  2. 그 사건에 필요한 시도 횟수를 실제로 계산해보라. 자릿수만 세어봐도 현실성을 가늠할 수 있다.
  3. 비교 대상을 구체적인 물리량(시간, 인구, 우주의 나이)으로 바꿔보라. 추상적인 “아주 작은 확률”보다 훨씬 와닿는다.
  4. 무한 원숭이 정리는 경고이지 희망이 아니다. “언젠가는 된다”는 수학적 참이 “기다릴 가치가 있다”는 뜻은 아니다.

더 깊이: 베르누이 시행의 반복과 독립성

이 계산은 매 글자가 26가지 중 하나로, 이전 글자와 독립적으로 결정된다는 가정 위에 서 있다. 강의노트 〈수리통계학 1. 확률론 — 독립〉이 정의하는 독립사건의 곱셈 규칙 \(P(A\cap B)=P(A)P(B)\)을 글자 수만큼 반복해서 곱한 것이 바로 \(26^{-n}\)이라는 식이다. 독립사건이 하나씩 더해질 때마다 확률이 얼마나 빠르게 작아지는지, 이보다 극적으로 보여주는 예는 드물다.

SDV 관점: “가능성 0이 아니다”는 설계의 출발점이지 결론이 아니다

무한 원숭이 정리의 역설을 이해하는 일은 요약과 추론(1~2단계)을 넘어, SDV(통계적 데이터 가치화) 관점에서 리스크를 설계할 때의 균형 감각을 길러준다. “이론적으로 발생 가능하다”는 이유만으로 모든 극단적 시나리오에 무한한 자원을 투입할 수는 없다. 10월에 다룬 저확률·고피해 위험처럼, 현실적으로 의미 있는 시간·자원 범위 안에서 “일어날 법한” 위험과 “수학적으로만 가능한” 위험을 구분하는 것이 데이터를 가치 있는 결정으로 바꾸는 균형점이다. (SDV(데이터 가치화))

결론: 가능하다는 것과 기다릴 만하다는 것은 다르다

나는 학생들에게 “확률이 0은 아니니까 가능하다”는 말을 들으면 반드시 “그래서 몇 번을 시도해야 하는가”를 되묻게 한다. 원숭이가 셰익스피어를 쓸 확률은 0이 아니지만, 그 “언젠가”는 우리가 상상할 수 있는 어떤 시간 범위에도 들어오지 않는다. 수학의 참과 현실의 가능성은 이렇게 멀리 떨어져 있을 수 있다.

참고 자료
  • 무한 원숭이 정리는 에밀 보렐(1913)이 처음 논의한 것으로 널리 알려진 확률론의 고전적 사고실험이다.
  • 우주의 나이(약 138억 년)는 천문학계에서 일반적으로 인용되는 근사값이다.
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08