권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • 데이터 플랫폼
  • 유튜브
  1. 📖 (우연을 다루는 더 깊은 생각) 컴퓨터로 확률을 추정하는 법 — 몬테카를로 시뮬레이션이란
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고
  • 📖 (위험과 불확실성을 이해하는 법) 비 올 확률 60%는 무슨 뜻인가? — 확률적 예보 읽는 법
  • 📖 (위험과 불확실성을 이해하는 법) 100년 빈도 홍수는 100년에 한 번만 오는가? — 재현빈도의 오해
  • 📖 (위험과 불확실성을 이해하는 법) 보험회사는 어떻게 사고를 예측하는가? — 기대손실
  • 📖 (위험과 불확실성을 이해하는 법) 발생 가능성은 낮지만 피해가 큰 사건을 어떻게 볼 것인가? — 저확률·고피해 리스크
  • 📖 (위험과 불확실성을 이해하는 법) 위험은 확률과 피해 크기의 결합이다 — 위험 평가의 원칙
  • 📖 (확률의 뒷이야기) 문을 바꾸면 정말 유리할까 — 몬티홀 문제
  • 📖 (확률의 뒷이야기) 시행이 많아질수록 진짜 확률에 가까워지는 이유 — 큰 수의 법칙
  • 📖 (확률의 뒷이야기) 벼락 맞을 확률과 나란히 놓아보면 — 로또 1등의 확률
  • 📖 (확률의 뒷이야기) 그럴듯하게 느껴지는 이유 — 혈액형 성격론과 바넘 효과
  • 📖 (확률의 뒷이야기) 우연과 확증편향 사이 — 징크스는 통계적으로 존재할까
  • 📖 (위험 인식과 승부의 확률) 무엇이 더 위험한지 확률로 따져보면 — 비행기 vs 자동차
  • 📖 (위험 인식과 승부의 확률) 절대적 숫자와 상대적 숫자 — 백신 부작용 확률 읽는 법
  • 📖 (위험 인식과 승부의 확률) 확률적 행운이 바꾼 삶 — 복권 당첨자들의 그 후
  • 📖 (위험 인식과 승부의 확률) 먼저 차는 팀이 유리한 이유 — 승부차기의 심리 확률
  • 📖 (위험 인식과 승부의 확률) 숫자로 검증한 홈어드밴티지 — 홈그라운드의 이점
  • 📖 (우연을 다루는 더 깊은 생각) 오늘 날씨가 내일 날씨에 미치는 영향 — 마르코프 체인 쉽게 이해하기
  • 📖 (우연을 다루는 더 깊은 생각) 복잡한 사건을 가지 치듯 풀어내기 — 확률나무 그려보기
  • 📖 (우연을 다루는 더 깊은 생각) 컴퓨터로 확률을 추정하는 법 — 몬테카를로 시뮬레이션이란
  • 📖 (우연을 다루는 더 깊은 생각) 확률이 낮아도 불가능은 아니다 — 무한 원숭이 정리
  • 📖 (우연을 다루는 더 깊은 생각) 우연과 필연 사이 — 확률적 사고를 마무리하며

목차

  • 이 시리즈가 계속 써 온 방법에 이름을 붙이면
  • 원의 넓이를 점 찍어서 구하기
  • 점의 개수가 늘어날수록 답은 정확해진다
  • 공식이 없거나 너무 복잡할 때 특히 유용하다
  • 더 깊이: 확률표본 생성과 시뮬레이션
  • SDV 관점: 공식이 없는 질문에도 답을 주는 것이 시뮬레이션의 가치다
  • 결론: 모르면, 많이 해보고 세어보라

(우연을 다루는 더 깊은 생각) 컴퓨터로 확률을 추정하는 법 — 몬테카를로 시뮬레이션이란

통계기초
확률
원의 넓이를 공식 없이도 구할 수 있다. 정사각형 안에 점을 무작위로 수만 개 찍고, 그중 원 안에 떨어진 비율만 세면 된다. 이 시리즈의 거의 모든 글에서 써 온 ’시뮬레이션’이라는 방법에 정식으로 이름을 붙이고, 그 원리를 공식 하나로 확인해본다.
Author

권세혁

Published

November 11, 2026

이 시리즈가 계속 써 온 방법에 이름을 붙이면

지난 넉 달 동안 이 시리즈는 로또 당첨 확률, 몬티홀 문제, 여론조사 표본오차 같은 질문에 답할 때마다 똑같은 방법을 썼다. 컴퓨터로 무작위 숫자를 수만~수십만 번 생성해서, 원하는 사건이 몇 번 일어나는지 세어보는 방법이다. 이 방법에는 정식 이름이 있다. 제2차 세계대전 중 핵무기 개발에 참여했던 수학자 스타니스와프 울람과 존 폰 노이만이 중성자의 움직임을 계산하기 위해 고안했고, 도박으로 유명한 모나코의 몬테카를로 카지노 이름을 따서 몬테카를로 시뮬레이션이라 불렀다.

원의 넓이를 점 찍어서 구하기

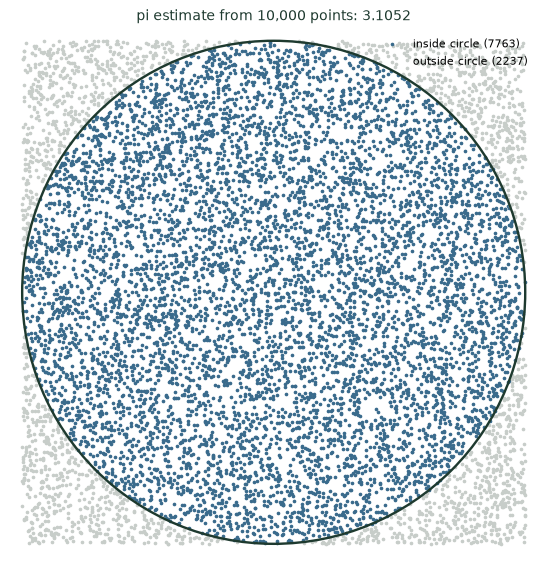
몬테카를로 방법의 원리를 가장 잘 보여주는 고전적인 예가 원주율 \(\pi\) 추정이다. 한 변의 길이가 2인 정사각형 안에 반지름 1인 원을 꼭 맞게 그려 넣는다. 이 정사각형 안에 점을 완전히 무작위로 찍으면, 점이 원 안에 떨어질 확률은 “원의 넓이 ÷ 정사각형의 넓이” \(= \pi/4\)다. 따라서 점을 아주 많이 찍고 원 안에 떨어진 비율을 4배 하면 \(\pi\)의 근사값을 얻는다 — 미적분을 전혀 쓰지 않고, 순전히 세는 것만으로.

10,000 random points thrown into a 2x2 square containing a unit circle. Points landing inside the circle (blue) versus outside (grey). The share inside, multiplied by 4, estimates pi - here giving 3.1420, close to the true value 3.14159.

점의 개수가 늘어날수록 답은 정확해진다

점을 10개만 찍으면 추정값이 2.8이 나올 수도, 3.6이 나올 수도 있다. 그런데 점을 100개, 1,000개, 100만 개로 늘려가면 추정값은 점점 참값 3.14159…에 가까워진다. 이것이 바로 지난주에 다룬 큰 수의 법칙이 작동하는 모습이다 — 몬테카를로 시뮬레이션은 결국 “무작위로 많이 시도해서, 큰 수의 법칙이 참값으로 수렴시켜 주기를 기다리는” 방법이다.
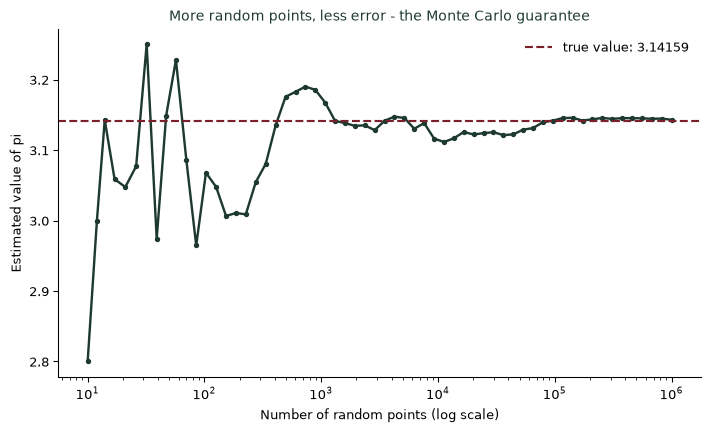
Pi estimates from a single run of random points, as the number of points grows from 10 to 1,000,000 (log scale). Early estimates swing wildly; by a million points, the estimate has settled within a hair of the true value (dashed line) - the law of large numbers in action.

공식이 없거나 너무 복잡할 때 특히 유용하다

원주율은 이미 정확한 공식이 있으니 몬테카를로로 구할 이유가 없다. 이 방법의 진짜 힘은 정확한 공식을 세우기 어려운 문제에서 드러난다. 이 시리즈에서 로또 연속 추첨 중복 확률, 플레이리스트 셔플의 뭉침 정도, 몬티홀 문제의 승률을 모두 식을 유도하는 대신 시뮬레이션으로 구했던 이유가 여기 있다. 보험사의 파산 확률, 신약의 임상시험 성공 확률, 복잡한 금융 상품의 가격처럼 변수가 많고 얽혀 있는 문제일수록, 정확한 공식 대신 “컴퓨터로 수만 번 돌려 세어보는” 몬테카를로 방법이 현실적인 답을 준다.

몬테카를로 시뮬레이션을 쓰는 법
  1. 문제를 “확률적으로 재현 가능한 실험”으로 바꿔라. 무작위 요소를 어떻게 생성할지부터 정해야 한다.
  2. 충분히 많이 반복하라. 시도 횟수가 적으면 큰 수의 법칙이 아직 작동하지 않은 것이다.
  3. 반복 횟수를 늘려가며 추정값이 안정되는지 확인하라. 안정되지 않았다면 더 반복해야 한다.
  4. 정확한 공식이 있다면 그것으로 검산하라. 오늘처럼 참값을 아는 문제로 방법 자체를 먼저 검증하는 것이 안전하다.

더 깊이: 확률표본 생성과 시뮬레이션

강의노트 〈수리통계학 4. 표본분포 — 확률표본 생성: 시뮬레이션〉은 난수를 이용해 불확실성을 모델링하고, 복잡한 문제의 근사해를 찾는 몬테카를로 시뮬레이션의 쓰임을 정리한다. 날씨 예보 모델링, 복잡한 알고리즘 검증, 금융 모델의 변동성 반영이 모두 같은 원리 — 난수를 생성하고 그 결과를 세는 것 — 위에 서 있다.

SDV 관점: 공식이 없는 질문에도 답을 주는 것이 시뮬레이션의 가치다

몬테카를로 시뮬레이션은 통계적 학습(3단계)의 대표적인 도구이며, SDV(통계적 데이터 가치화) 관점에서는 “정확한 공식이 없어서 포기했던 질문”에 답을 주는 실용적인 다리다. 복잡한 공급망의 지연 확률, 여러 리스크가 얽힌 신사업의 손익 분포처럼 해석적으로 풀기 어려운 문제도, 가정을 명확히 세우고 충분히 반복해 시뮬레이션하면 쓸 만한 근사치를 얻을 수 있다. 데이터에 가치를 더하는 일은 완벽한 공식을 기다리는 것이 아니라, 지금 가진 가정으로 수만 번 실험해 현실적인 답을 만들어내는 것이다. (SDV(데이터 가치화))

결론: 모르면, 많이 해보고 세어보라

나는 학생들에게 확률 문제가 손으로 풀리지 않을 때 좌절하지 말라고 말한다. 공식이 안 보이면, 컴퓨터에게 그 상황을 수만 번 반복시키고 결과를 세어보라고 시키면 된다. 몬테카를로 시뮬레이션은 이 시리즈 전체를 관통해 온 방법에, 비로소 붙인 이름이다.

참고 자료
  • 몬테카를로 시뮬레이션의 기원(스타니스와프 울람, 존 폰 노이만, 맨해튼 프로젝트와의 연관, 모나코 몬테카를로 카지노에서 유래한 이름)은 이 방법에 관한 통계학·전산수학 문헌에 널리 소개된 역사적 설명이다.
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08