권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • 데이터 플랫폼
  • 유튜브
  1. 📖 (확률의 뒷이야기) 그럴듯하게 느껴지는 이유 — 혈액형 성격론과 바넘 효과
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고
  • 📖 (위험과 불확실성을 이해하는 법) 비 올 확률 60%는 무슨 뜻인가? — 확률적 예보 읽는 법
  • 📖 (위험과 불확실성을 이해하는 법) 100년 빈도 홍수는 100년에 한 번만 오는가? — 재현빈도의 오해
  • 📖 (위험과 불확실성을 이해하는 법) 보험회사는 어떻게 사고를 예측하는가? — 기대손실
  • 📖 (위험과 불확실성을 이해하는 법) 발생 가능성은 낮지만 피해가 큰 사건을 어떻게 볼 것인가? — 저확률·고피해 리스크
  • 📖 (위험과 불확실성을 이해하는 법) 위험은 확률과 피해 크기의 결합이다 — 위험 평가의 원칙
  • 📖 (확률의 뒷이야기) 문을 바꾸면 정말 유리할까 — 몬티홀 문제
  • 📖 (확률의 뒷이야기) 시행이 많아질수록 진짜 확률에 가까워지는 이유 — 큰 수의 법칙
  • 📖 (확률의 뒷이야기) 벼락 맞을 확률과 나란히 놓아보면 — 로또 1등의 확률
  • 📖 (확률의 뒷이야기) 그럴듯하게 느껴지는 이유 — 혈액형 성격론과 바넘 효과
  • 📖 (확률의 뒷이야기) 우연과 확증편향 사이 — 징크스는 통계적으로 존재할까

목차

  • 한국인 10명 중 6명이 믿는다는 성격설
  • 모두에게 같은 문장을 나눠줬는데, “정확하다”고 답했다
  • 모두에게 “양성”이 나오는 검사는 검사가 아니다
  • 더 깊이: 아무것도 구별 못 하는 검사의 통계적 의미
  • SDV 관점: “모두에게 맞는 설명”은 가치가 없는 설명이다
  • 결론: 맞는 것처럼 느껴지는 것과 맞는 것은 다르다

(확률의 뒷이야기) 그럴듯하게 느껴지는 이유 — 혈액형 성격론과 바넘 효과

통계기초
확률
한국갤럽 조사에서 한국인의 57%가 혈액형 성격설을 믿는다고 답했다. 그런데 1948년 심리학자 버트럼 포러는 모든 학생에게 똑같은 ’성격 묘사’를 나눠주고도 평균 4.26점(5점 만점)의 ’정확하다’는 평가를 받아냈다. 누구에게나 맞는 것처럼 느껴지는 설명을 ’바넘 효과’라 부른다.
Author

권세혁

Published

October 29, 2026

한국인 10명 중 6명이 믿는다는 성격설

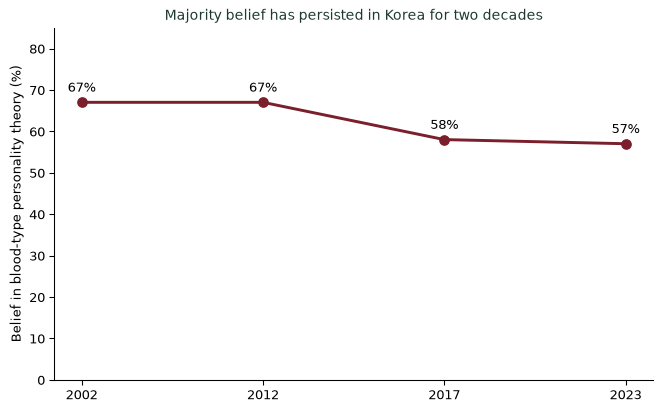
2023년 한국갤럽이 전국 성인 1,501명을 조사한 결과, “혈액형 성격설을 믿는다”고 답한 사람이 57%였다. 2002년과 2012년에는 이 비율이 67%까지 올라갔다가 2017년 58%로 떨어진 뒤 비슷한 수준을 유지하고 있다. 믿는 사람의 상당수는 연애나 결혼 상대를 고를 때 혈액형을 고려하는 것이 좋다고까지 답했다(전체 응답자 기준 20%). 그런데 혈액형과 성격 사이에 과학적으로 입증된 연관성은 없다는 것이 학계의 정설이다. 그렇다면 왜 이렇게 많은 사람이 “맞는 것 같다”고 느낄까?

Share of Koreans who say they believe blood-type personality theory, across four Gallup Korea surveys (2002, 2012, 2017, 2023). Belief has declined somewhat since the early 2000s but still sits above 50%.

모두에게 같은 문장을 나눠줬는데, “정확하다”고 답했다

1948년 미국 심리학자 버트럼 포러는 학생들에게 성격 검사를 받게 한 뒤, “각자에게 맞춤 분석한 결과”라며 성격 묘사를 나눠줬다. 그러고는 이 묘사가 자신에게 얼마나 정확한지 0점에서 5점으로 평가해 달라고 했다. 평균 점수는 4.26점, 거의 “매우 정확하다”에 가까웠다. 그런데 사실 모든 학생이 받은 묘사는 완전히 똑같은 문장이었다 — 별자리 운세에서 흔히 쓰이는 모호하고 보편적인 표현들을 짜깁기한 것이었다. “당신은 때로는 외향적이지만 때로는 내향적이다”, “당신에게는 아직 발휘하지 못한 잠재력이 있다” 같은 문장은 누구에게 줘도 “맞는 것 같다”고 느껴진다. 이 현상을 포러의 이름을 따 포러 효과, 또는 서커스 흥행사 피니어스 바넘의 “모두를 위한 무언가가 있다”는 문구를 따 바넘 효과(Barnum effect)라 부른다.
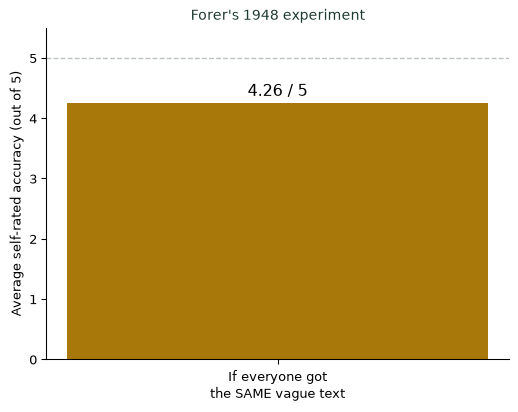
Forer’s 1948 classroom demonstration: every student received the identical, vague personality description, yet the average self-rated accuracy was 4.26 out of 5 - nearly as high as a genuinely personalized result would score.

모두에게 “양성”이 나오는 검사는 검사가 아니다

이 현상을 통계학의 언어로 바꿔 보면 더 분명해진다. 어떤 성격 묘사가 누구에게 줘도 “맞다”는 평가를 받는다면, 그 묘사는 민감도는 100%이지만 특이도는 0%인 검사와 같다. 참인 사람에게도 “맞다”고 하고, 거짓인 사람에게도 “맞다”고 하면, 그 검사는 아무것도 구별해내지 못한다. 혈액형 성격론이 계속 “맞는 것 같다”고 느껴지는 이유도 비슷하다. “A형은 꼼꼼하다”는 말을 들으면, 사람들은 자신이 꼼꼼했던 순간은 기억하고 덤벙댔던 순간은 지나친다. 이렇게 맞아떨어지는 사례만 골라 기억하는 확증편향이 바넘 효과와 겹쳐지면, 근거 없는 이론도 “통계적으로 검증된 것처럼” 느껴지게 된다.

바넘 효과를 알아채는 법
  1. 그 설명이 나에게만 특별히 맞는지, 누구에게 줘도 맞을지 생각해 보라. 반대 성향을 가진 사람에게 보여줘도 “맞다”고 할 것 같다면 바넘 문장이다.
  2. “때로는 ~하지만 때로는 ~하다”는 식의 양쪽 다 가능한 표현을 의심하라. 반증이 불가능한 설명은 애초에 검증된 적이 없는 설명이다.
  3. 맞아떨어진 사례만 기억하고 있지는 않은지 점검하라. 틀렸던 순간을 일부러 세어보면 균형이 잡힌다.
  4. “많은 사람이 믿는다”는 사실과 “과학적으로 입증됐다”는 사실을 구분하라. 57%가 믿는다는 것은 유행이지 증거가 아니다.

더 깊이: 아무것도 구별 못 하는 검사의 통계적 의미

강의노트 〈수리통계학 1. 확률론 — 특이도와 민감도〉는 검사의 민감도(참을 참이라 판정하는 비율)와 특이도(거짓을 거짓이라 판정하는 비율)를 정의한다. 민감도가 100%라도 특이도가 0%인 검사는, 모든 대상에게 똑같이 “양성”을 내놓을 뿐 아무 정보도 주지 않는다. 바넘 문장이 바로 이런 “검사”다 — 누구에게나 똑같이 “맞다”고 답하도록 설계되어 있어, 실제로는 아무것도 구별해내지 못한다.

SDV 관점: “모두에게 맞는 설명”은 가치가 없는 설명이다

바넘 효과를 알아보는 일은 요약과 추론(1~2단계)을 넘어, SDV(통계적 데이터 가치화) 관점에서 데이터 기반 설명의 진짜 가치를 가려내는 기준이 된다. 고객 세분화 보고서나 성과 분석이 “이 그룹은 다양한 특성을 보이며, 때로는 적극적이고 때로는 신중하다”처럼 누구에게나 들어맞는 문장으로 채워져 있다면, 그 분석은 그럴듯하게 느껴질 뿐 실제 의사결정에는 아무 도움이 되지 않는다. 데이터를 가치 있는 결정으로 바꾸려면, 그 설명이 특정 조건에서는 틀릴 수 있다는 것, 곧 반증 가능한 구체적 주장을 담고 있는지부터 확인해야 한다. (SDV(데이터 가치화))

결론: 맞는 것처럼 느껴지는 것과 맞는 것은 다르다

나는 학생들에게 “이거 완전 내 얘기인데?”라는 느낌이 들 때일수록 더 의심하라고 말한다. 포러의 실험이 보여주듯, 그 느낌은 그 설명이 정확해서가 아니라 애초에 누구에게나 맞도록 설계됐기 때문일 수 있다. 통계적으로 검증되지 않은 믿음이 오래 살아남는 이유는, 그 믿음이 맞아서가 아니라 반박하기 어렵게 만들어졌기 때문이다.

참고 자료
  • 한국인의 혈액형 성격설 신뢰 비율(2002/2012년 67%, 2017년 58%, 2023년 57%)과 연애·결혼 고려 비율은 한국갤럽 조사를 참고했다: ‘혈액형 성격설’ 믿는 한국인 57%…최애 혈액형은 ‘O형’ — 데이터솜
  • 버트럼 포러의 1948년 실험(평균 정확도 평가 4.26/5)은 심리학 교재와 문헌에 널리 인용되는 고전적 수치다.
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08