권세혁HOME
  • SDV(데이터 가치화)
  • 강의노트
    • 기초수학·수리통계·조사방법
    • 기초통계·회귀·다변량분석
    • 머신러닝·딥러닝
    • AI·감성분석
  • 통계챗봇
  • 오늘의 검색 트렌드
  • 통계, 다르게 읽기
  • 통계로 보는 세상(티스토리 e책방)
  • 데이터 플랫폼
  • 유튜브
  1. 📖 (위험 인식과 승부의 확률) 먼저 차는 팀이 유리한 이유 — 승부차기의 심리 확률
  • 📋 전체 목록

  • 📖 (비율과 백분율의 함정) 인구 1만 명당 범죄율을 사용하는 이유
  • 📖 (비율과 백분율의 함정) 위험이 두 배 증가했다는 뉴스는 얼마나 위험한가?
  • 📖 (비율과 백분율의 함정) 지지율 3% 상승인가, 3%포인트 상승인가?
  • 📖 (비율과 백분율의 함정) 매출이 50% 늘었다는 말에 속지 않는 법
  • 📖 (숫자를 대표하는 방법) 같은 평균, 전혀 다른 세상
  • 📖 (숫자를 대표하는 방법) 연봉은 평균보다 중앙값으로 보아야 하는 이유
  • 📖 (숫자를 대표하는 방법) 우리 반 평균이 올랐는데 학생들은 왜 불만일까?
  • 📖 (숫자를 대표하는 방법) 별점 4.5점짜리 식당은 믿을 만한가?
  • 📖 (숫자를 대표하는 방법) 내 체온 36.5도는 정말 정상인가?
  • 📖 지각하는 사람들의 비밀
  • 📖 대기 시간의 비밀
  • 📖 평균의 함정
  • 📖 p-값은 왜 0.05인가?
  • 📖 카톡 답장 속도와 호감도의 통계학
  • 📖 (그래프는 어떻게 우리를 속이는가) 막대그래프의 축을 자르면 차이가 커진다
  • 📖 (그래프는 어떻게 우리를 속이는가) 두 개의 세로축이 만드는 가짜 상관관계
  • 📖 (그래프는 어떻게 우리를 속이는가) 누적그래프는 왜 항상 좋아 보일까?
  • 📖 (그래프는 어떻게 우리를 속이는가) 선형 눈금과 로그 눈금은 무엇이 다른가?
  • 📖 (그래프는 어떻게 우리를 속이는가) 좋은 그래프는 무엇을 숨기지 않는가?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 농구에서 ’슛 감각이 올랐다’는 말은 사실일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 동전이 다섯 번 앞면이면 다음은 뒷면일까?
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 성공한 사람만 보면 성공법이 보이지 않는다
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 시험을 망친 다음 점수가 오르는 이유
  • 📖 (사람의 직관은 왜 통계와 충돌하는가) 기억에 잘 남는 사건이 더 자주 일어난다고 느끼는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 연승과 연패, 우연일까 실력일까
  • 📖 (기록의 착시, 대표값의 재발견) 작은 표본이 만드는 큰 착각 — 야구 타율 3할의 의미
  • 📖 (기록의 착시, 대표값의 재발견) 세대별 평균이 말해주는 진짜 의미 — 평균 키가 자라는 이유
  • 📖 (기록의 착시, 대표값의 재발견) 평균으로 설명되지 않는 데이터들 — 최빈값이 필요한 순간
  • 📖 (기록의 착시, 대표값의 재발견) 평균의 함정 총정리 — 평균 수심 1m 강물이 위험한 이유
  • 📖 (흩어짐과 역설) “보통”의 폭을 재는 법 — 표준편차란 무엇인가
  • 📖 (흩어짐과 역설) 재벌 총수가 낀 동네 평균 소득 — 이상치 하나가 바꾸는 평균
  • 📖 (흩어짐과 역설) 입시에서 표준점수를 쓰는 이유 — 편차값의 비밀
  • 📖 (흩어짐과 역설) 단위가 다른 두 집단을 견주는 법 — 변동계수로 비교하기
  • 📖 (흩어짐과 역설) 부분에서 이기고도 전체에서 지는 이유 — 심슨의 역설
  • 📖 (숫자로 사람을 줄 세우는 법) 숫자 하나로 사회를 요약하기 — 지니계수로 읽는 불평등
  • 📖 (숫자로 사람을 줄 세우는 법) 어느 쪽이 더 공정할까 — 상대평가 vs 절대평가
  • 📖 (숫자로 사람을 줄 세우는 법) 1점 차이가 갖는 진짜 무게 — 순위의 착시
  • 📖 (숫자로 사람을 줄 세우는 법) 5.0과 4.8 사이, 표본크기의 문제 — 별점 평균의 함정
  • 📖 (숫자로 사람을 줄 세우는 법) 별점 대신 순위를 매기는 이유 — 넷플릭스 평점 시스템
  • 📖 (공식 통계 숫자 읽는 법) 평균수명 60세 시대의 오해 — 기대수명이라는 숫자의 함정
  • 📖 (공식 통계 숫자 읽는 법) 나만의 장바구니 물가지수 — 체감 물가와 통계 물가
  • 📖 (공식 통계 숫자 읽는 법) 누구를 세고 누구를 빼는가 — 실업률의 숨은 정의
  • 📖 (공식 통계 숫자 읽는 법) 분모가 다르면 결론도 다르다 — 치명률 숫자 읽는 법
  • 📖 (공식 통계 숫자 읽는 법) 인과추론 감각을 기르는 법 — 미신적 상관관계 모음
  • 📖 (확률과 우연의 세계) 23명만 모여도 생일이 겹칠 가능성이 높은 이유 — 생일 문제
  • 📖 (확률과 우연의 세계) 같은 번호가 연속으로 나오면 조작일까? — 독립사건
  • 📖 (확률과 우연의 세계) 무작위 숫자는 왜 고르게 흩어지지 않는가? — 군집 착각
  • 📖 (확률과 우연의 세계) 로또 번호에 명당이 존재할까? — 동일확률과 선택편향
  • 📖 (확률과 우연의 세계) 희귀한 사건이 매일 뉴스에 나오는 이유 — 다중 기회
  • 📖 (확률의 도구들) 확률을 세는 언어 — 표본공간과 사건이란 무엇인가
  • 📖 (확률의 도구들) “적어도 하나”의 확률 — 여사건으로 풀면 쉬워지는 문제
  • 📖 (확률의 도구들) 경우의 수 세기 — 카드 한 장을 뽑을 때 확률 계산법
  • 📖 (확률의 도구들) 오해하기 쉬운 개념 — 독립이라는 것의 진짜 의미
  • 📖 (확률의 도구들) 복권 기댓값으로 알아보기 — 기댓값이란 무엇인가
  • 📖 (분포가 들려주는 이야기) 세상의 모든 데이터는 정규분포일까? — 정규분포 신화와 한계
  • 📖 (분포가 들려주는 이야기) 키는 정규분포에 가깝고 소득은 그렇지 않은 이유 — 분포 모양이 다른 이유
  • 📖 (분포가 들려주는 이야기) 평균에서 세 표준편차 밖이면 이상한 값일까? — 68-95-99.7 법칙
  • 📖 (분포가 들려주는 이야기) 하루에 걸려오는 전화 수는 어떤 분포를 따를까? — 포아송분포
  • 📖 (분포가 들려주는 이야기) 분포를 모르면 평균도 해석할 수 없다 — 분포 이해의 중요성
  • 📖 (조건부확률과 베이즈의 사고) 검사 결과가 양성이면 정말 병에 걸린 것일까? — 기저율
  • 📖 (조건부확률과 베이즈의 사고) 정확도 99% 검사가 틀릴 수 있는 이유 — 조건부확률
  • 📖 (조건부확률과 베이즈의 사고) 범인이 범행 현장에 있을 확률과 현장에 있던 사람이 범인일 확률 — 조건의 방향
  • 📖 (조건부확률과 베이즈의 사고) 스팸메일 필터는 어떻게 배워가는가? — 베이즈 갱신
  • 📖 (조건부확률과 베이즈의 사고) 새로운 증거가 들어오면 믿음도 바뀌어야 한다 — 베이지안 사고
  • 📖 (위험과 불확실성을 이해하는 법) 비 올 확률 60%는 무슨 뜻인가? — 확률적 예보 읽는 법
  • 📖 (위험과 불확실성을 이해하는 법) 100년 빈도 홍수는 100년에 한 번만 오는가? — 재현빈도의 오해
  • 📖 (위험과 불확실성을 이해하는 법) 보험회사는 어떻게 사고를 예측하는가? — 기대손실
  • 📖 (위험과 불확실성을 이해하는 법) 발생 가능성은 낮지만 피해가 큰 사건을 어떻게 볼 것인가? — 저확률·고피해 리스크
  • 📖 (위험과 불확실성을 이해하는 법) 위험은 확률과 피해 크기의 결합이다 — 위험 평가의 원칙
  • 📖 (확률의 뒷이야기) 문을 바꾸면 정말 유리할까 — 몬티홀 문제
  • 📖 (확률의 뒷이야기) 시행이 많아질수록 진짜 확률에 가까워지는 이유 — 큰 수의 법칙
  • 📖 (확률의 뒷이야기) 벼락 맞을 확률과 나란히 놓아보면 — 로또 1등의 확률
  • 📖 (확률의 뒷이야기) 그럴듯하게 느껴지는 이유 — 혈액형 성격론과 바넘 효과
  • 📖 (확률의 뒷이야기) 우연과 확증편향 사이 — 징크스는 통계적으로 존재할까
  • 📖 (위험 인식과 승부의 확률) 무엇이 더 위험한지 확률로 따져보면 — 비행기 vs 자동차
  • 📖 (위험 인식과 승부의 확률) 절대적 숫자와 상대적 숫자 — 백신 부작용 확률 읽는 법
  • 📖 (위험 인식과 승부의 확률) 확률적 행운이 바꾼 삶 — 복권 당첨자들의 그 후
  • 📖 (위험 인식과 승부의 확률) 먼저 차는 팀이 유리한 이유 — 승부차기의 심리 확률
  • 📖 (위험 인식과 승부의 확률) 숫자로 검증한 홈어드밴티지 — 홈그라운드의 이점

목차

  • 2002년, 한국은 먼저 공을 찼다
  • 보도되는 숫자들: 55%에서 62.5%까지
  • 왜 “동전 던지기”가 아닐까 — 압박감은 킥을 독립시행이 아니게 만든다
  • 더 깊이: 조건이 매번 똑같지 않은 시행
  • SDV 관점: 겉보기엔 같은 시행도 조건이 다르면 다른 분포를 써야 한다
  • 결론: 순서는 우연이 아니라 심리를 바꾼다

(위험 인식과 승부의 확률) 먼저 차는 팀이 유리한 이유 — 승부차기의 심리 확률

통계기초
확률
2002년 한일 월드컵 8강, 한국은 스페인을 상대로 먼저 공을 찼고 5-3으로 승리하며 4강에 올랐다. 우연이었을까? 1982년 이후 월드컵 승부차기를 모아 보면 먼저 차는 팀이 더 자주 이긴다는 보도가 반복된다. 각 킥을 독립된 동전 던지기로 보면 안 되는 이유를 짚어본다.
Author

권세혁

Published

November 5, 2026

2002년, 한국은 먼저 공을 찼다

2002년 6월 22일 광주, 한일 월드컵 8강전에서 한국과 스페인은 연장전까지 0-0으로 비겼다. 승부차기가 시작됐고, 한국은 황선홍, 박지성, 설기현, 안정환, 홍명보 순으로 먼저 공을 찼다. 골키퍼 이운재가 스페인의 네 번째 키커 호아킨의 슛을 막아내며 분위기가 넘어갔고, 결국 한국이 5-3으로 승리해 아시아 국가 최초로 월드컵 4강에 올랐다. 이 승부에서 한국은 ‘선축(先蹴)’ 팀이었다. 승부차기에서 먼저 차는 팀이 정말 유리할까?

보도되는 숫자들: 55%에서 62.5%까지

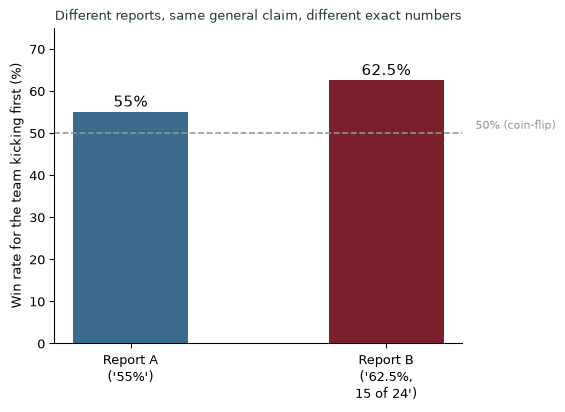
1982년 월드컵부터 집계한 여러 보도에 따르면, 월드컵 승부차기에서 먼저 찬 팀이 이긴 비율은 보도마다 55%에서 62.5% 사이로 소개된다(한 보도는 24번의 승부차기 중 15번을 먼저 찬 팀이 이겼다고 전한다). 50:50이어야 할 것 같은 승부에서 먼저 차는 쪽이 조금이라도 더 자주 이긴다는 것이다. 다만 이 수치들은 대부분 언론 보도에 실린 2차 자료이고, 원 연구의 정확한 표본과 방법은 확인되지 않는다는 점을 먼저 밝혀둔다.

Reported win rates for the team that kicks first in World Cup penalty shoot-outs, as cited by different Korean news outlets covering the same general claim. The range (55% to 62.5%) itself signals that these are secondary citations rather than a single, precisely documented statistic - a reason for caution even while the general pattern (first-kicker edge) is widely repeated.

왜 “동전 던지기”가 아닐까 — 압박감은 킥을 독립시행이 아니게 만든다

승부차기 한 번 한 번을 독립된 동전 던지기로 생각하면 순서는 중요하지 않아야 한다. 그런데 실제로는 그렇지 않다는 것이 많은 스포츠 심리학 연구의 결론이다. 핵심은 뒤에 차는 선수일수록 “이걸 못 넣으면 바로 진다”는 압박감이 커진다는 데 있다. 한 보도는 패배가 확정되는 마지막 키커의 성공률이 평소보다 크게 떨어진다고 전한다(원 수치는 출처 확인이 필요하다). 영국 엑스터대 연구팀도 압박감이 골키퍼를 보는 시선 처리를 바꿔 성공률에 영향을 준다고 보고한 바 있다. 즉 각 킥은 같은 확률을 가진 독립적인 시행이 아니라, 점수 상황이 뒤로 갈수록 심리적 부담이 실리는 시행이다. 2024년 국제축구평의회(IFAB)가 순서를 ABAB에서 ABBA로 바꾼 것도, 이 “먼저 차는 쪽의 이점”을 줄이기 위한 조치였다.
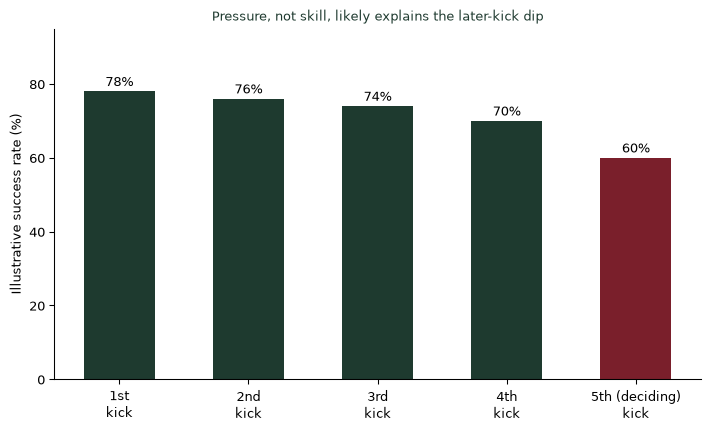
Illustrative success rates by kick position, reflecting the commonly described pattern: success rates stay fairly stable for early kicks but drop noticeably for a kick that would end the shoot-out in defeat if missed - especially the decisive final kick. Values are illustrative, built to show the shape of the reported pattern rather than cite one precise study.
승부차기 통계를 읽을 때
  1. “독립시행”이라는 가정이 실제로 성립하는지 의심하라. 심리적 압박처럼 시행마다 조건이 달라지면 이항분포의 기본 가정이 깨진다.
  2. 보도마다 다른 숫자가 나오면 출처의 신뢰도를 먼저 따져라. 55%와 62.5%처럼 범위가 넓다는 것 자체가 신호다.
  3. 규칙이 바뀐 이유를 추적하면 통계의 방향을 다시 확인할 수 있다. IFAB가 순서를 바꾼 것은 그 자체로 “먼저 차는 쪽이 유리하다”는 분석이 실무에 반영된 사례다.
  4. 압박감 같은 심리적 요인이 통계적으로 “독립성 위반”으로 나타난다는 것을 기억하라.

더 깊이: 조건이 매번 똑같지 않은 시행

강의노트 〈수리통계학 5. 유명분포 — 베르누이분포〉는 “성공/실패” 두 결과를 갖는 단일 시행을 정의한다. 이항분포가 성립하려면 이런 베르누이 시행이 매번 같은 성공 확률로, 서로 독립적으로 반복되어야 한다. 승부차기는 외형상 같은 시행처럼 보이지만, 점수 상황에 따라 압박감이 달라지면서 성공 확률 자체가 매 킥마다 바뀐다 — 이항분포의 전제가 깨지는 실제 사례다.

SDV 관점: 겉보기엔 같은 시행도 조건이 다르면 다른 분포를 써야 한다

승부차기의 순서 효과를 이해하는 일은 요약과 추론(1~2단계)을 넘어, SDV(통계적 데이터 가치화) 관점에서 “반복되는 것처럼 보이는 이벤트”를 분석할 때의 함정을 보여준다. 영업 성과, 콜센터 응대, 생산 공정처럼 “매번 같은 조건”이라고 가정하고 평균이나 표준 모형을 적용하는 경우가 많지만, 실제로는 순서나 압박 같은 숨은 요인이 조건을 바꿔 놓는다. 데이터에 가치를 더하려면 “이 시행들이 정말 같은 조건에서 반복됐는가”를 먼저 확인하고, 그렇지 않다면 조건별로 나눠 분석해야 한다. (SDV(데이터 가치화))

결론: 순서는 우연이 아니라 심리를 바꾼다

나는 학생들에게 승부차기를 “같은 확률을 가진 다섯 번의 동전 던지기”로 보지 말라고 말한다. 2002년 한국이 먼저 공을 찬 것, 그리고 그 뒤 스페인의 키커들이 점점 더 큰 부담 속에 섰던 것은 모두 통계적으로 의미가 있는 차이다. 순서는 단순한 우연이 아니라, 매 순간 달라지는 확률을 만드는 구조다.

참고 자료
  • 2002년 한일 월드컵 8강 한국 vs 스페인 경기 결과(5-3, 키커 순서, 이운재 선방)는 위키백과와 당시 보도를 참고했다: 2002년 FIFA 월드컵 결선 토너먼트 — 위키백과
  • 먼저 차는 팀의 승률(55~62.5%)과 압박감·시선 처리 연구는 다음 기사를 참고했다: 승부차기의 심리학, 먼저 차면 유리하다? — 이투데이, 승부차기의 심리학…이론상 키커 유리 — 조세일보
  • 킥 순서별 성공률 차트의 구체적인 수치는 보도된 패턴의 모양을 보여주기 위한 가상의 예시다.
권세혁 교수의 통계책방 사이트 소개 슬라이드 (클릭하면 크게 보기)
사이트 소개 슬라이드 확대


방문자 수 since 2026.08.08